更新于 2026-08-13
Cloudflare bot 白名单不是一个单独开关,而是按身份放行、按路径限权、按来源兜底的组合。Cloudflare 早已把传统“白名单”思路改成更细粒度的放行规则;官方文档也明确建议优先用 WAF 自定义规则 处理已验证机器人,而不是把所有流量都交给 IP 放行。
Cloudflare bot 白名单到底指什么
Cloudflare bot 白名单,今天更准确的说法是“允许特定 bot 通过”。它通常对应三种能力:验证过的机器人、基于规则的放行、以及基于 IP 的例外。Cloudflare 的 verified bots 文档说明,可信 bot 需要能证明身份并遵守站点偏好;而 cf.client.bot 变量正是用来识别这类已知好 bot 的。
先分清 3 类流量,再决定放不放
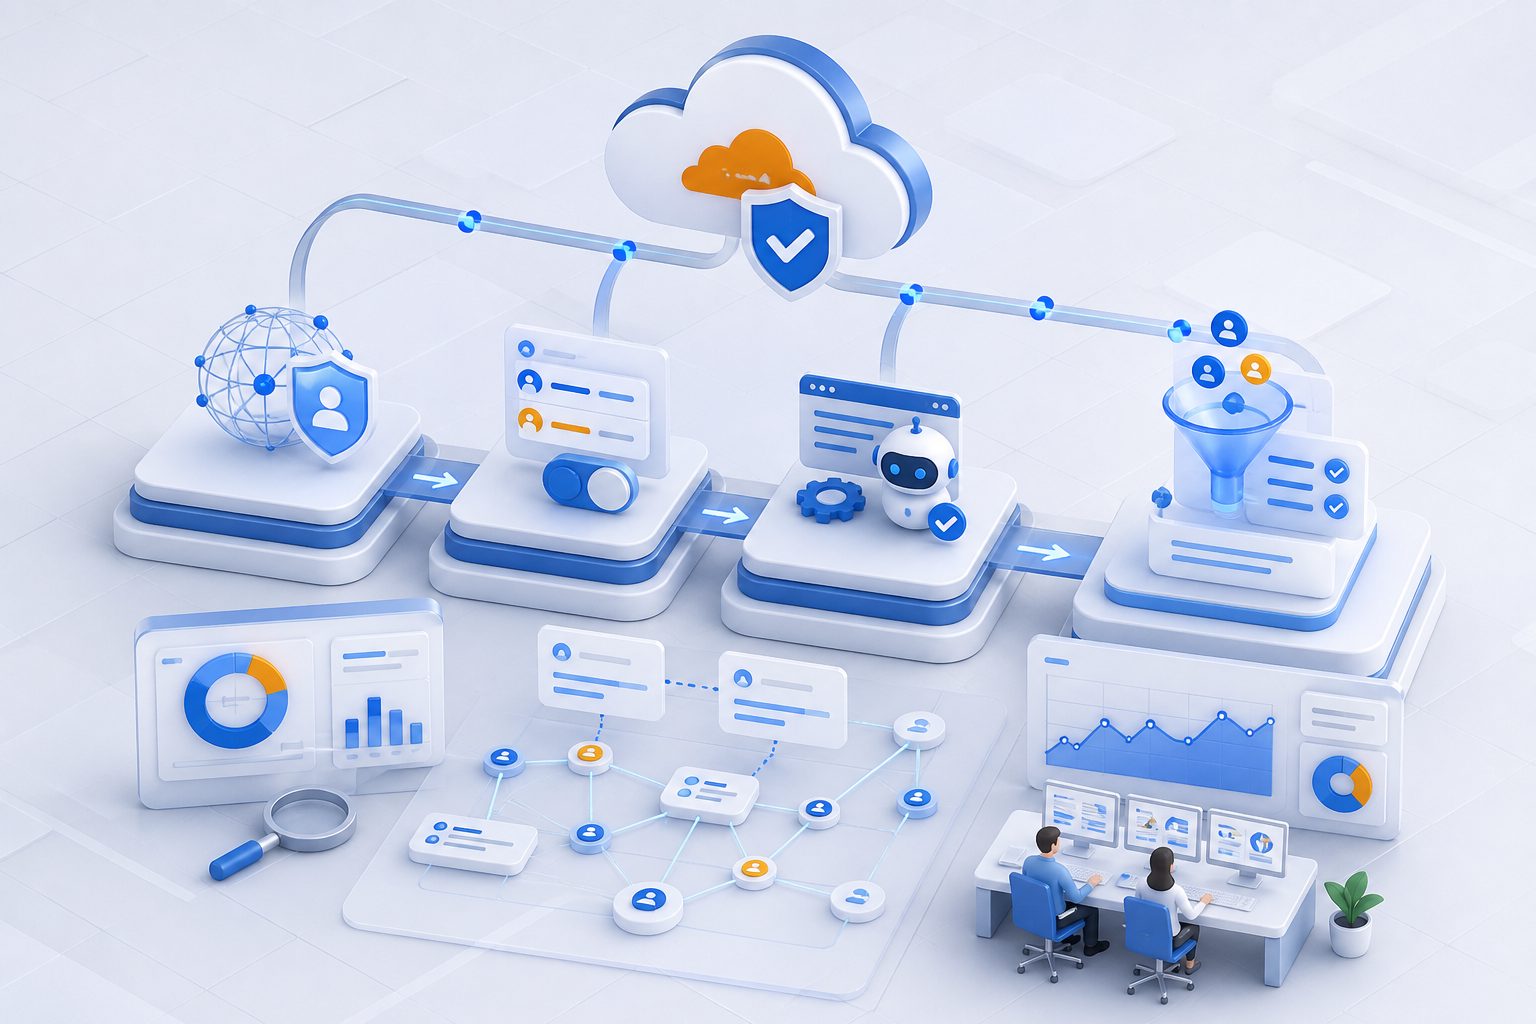
不同 bot 不能一刀切。搜索引擎爬虫、合作伙伴爬虫、AI 爬虫的风险和用途完全不同。最实用的判断方式,是先看“它是谁”,再看“它要访问哪里”,最后看“是否真的需要全放行”。
| 场景 | 推荐方式 | 不推荐方式 |
|---|---|---|
| Googlebot、Bingbot 这类验证过的搜索引擎 | cf.client.bot / verified bots 放行 |
只看 UA |
| 固定 IP 的监控、支付、接口服务 | IP Access Rules 或定向自定义规则 | 仅靠 robots.txt |
| AI 爬虫、代理式 agent | 按路径、类别、用途分层放行 | 整站 Allow |
Cloudflare 还提示,IP Access Rules 的 Allow 会绕过不少安全检查;官方同时建议,能用 custom rules 时,优先用 custom rules。IP Access Rules 文档与 Cloudflare bot 规则说明都强调了这一点。
最小放行顺序:先认身份,再选控制面
可直接按这 4 步处理 Cloudflare bot 白名单:
- 先验证 bot 身份。 对搜索引擎类流量,别只看 user-agent。Google 说明,验证 Googlebot 应看反向 DNS 或 IP 段,UA 很容易被伪造。Googlebot 验证说明
- 优先用 WAF 自定义规则。 例如只放行 verified bots,或只对某个路径放行已验证 bot。Cloudflare 的
cf.client.bot与cf.bot_management.verified_bot提供了这一层判断。 - 只有稳定 IP 才用 IP 放行。 适合合作服务、固定监控节点、支付回调等;这类规则最好再加备注和到期复核。
- robots.txt 只做引导,不做安全控制。 Google 明确说过,robots.txt 主要是管理抓取,不是用来隐藏页面;要真正禁止访问,得用鉴权、
noindex或 WAF。robots.txt 说明
如果目标是 AI 爬虫,而不是传统搜索引擎,可继续看 Cloudflare 放行 AI 爬虫:从 robots.txt 到 WAF 的最小放行方案 和 AI 爬虫白名单配置:从 robots 到 WAF 的放行顺序。
Cloudflare bot 白名单最常见的误区
误区一:把 UA 白名单当成安全控制。
UA 只是声明,不是证明。Cloudflare 和 Google 都提醒过,身份识别要靠验证,不要只看字符串。
误区二:一条 Allow 放到底。
IP Access Rules 的 Allow 会跳过多种安全机制,范围过大时,反而把 WAF、限速和审计一起绕开。
误区三:把 robots.txt 当拦截器。
robots.txt 适合“告诉机器人别来”,不适合“强制禁止”。如果页面已经需要真正隔离,就别把希望寄托在爬虫自觉上。
误区四:把搜索引擎和 AI 爬虫混为一类。
搜索引擎要的是可索引,AI 爬虫可能要的是训练、摘要或实时问答。放行目标不同,规则也应该不同。更多边界可参考 llms.txt和robots.txt区别:先分清访问控制与内容引导。
可直接落地的一套规则思路
如果只想要一个不容易出错的模板,思路是:
- 默认拒绝大多数自动化流量
- 对 verified bots 单独放行
- 对固定合作方走 IP 例外
- 对 AI 爬虫按目录或路径拆分
- 每次改规则后看 Security Events 和源站日志
Cloudflare 在 cf.client.bot 之外,还提供 cf.verified_bot_category、cf.bot_management.score 等字段,适合把“能放行”与“应该放行多少”分开处理。这比单纯写一条全站白名单更稳,也更适合长期维护。
常见问题
Cloudflare bot 白名单和 robots.txt 是一回事吗?
不是。Cloudflare bot 白名单是边缘层的放行控制,robots.txt 只是抓取提示。前者管访问,后者管偏好。
Cloudflare bot 白名单一定要用 IP 放行吗?
不一定。Cloudflare 更推荐先用 verified bots 或 custom rules;只有当对方 IP 稳定、身份明确时,IP 放行才更合适。
只放行 Googlebot 可以吗?
可以,但前提是先验证身份,不能只按 user-agent 放行。Google 官方建议用反向 DNS 或 IP 段确认来源。
AI 爬虫该不该放行?
看目标。如果要收录、展示或合作抓取,可以按目录放行;如果担心训练、滥抓或带宽消耗,就该单独限制,而不是整站开放。
哪种方式最适合大多数网站?
大多数站点的起点是:cf.client.bot 放行验证过的搜索引擎,再配一条路径级规则处理合作方;只有少数稳定服务再加 IP 例外。