更新时间:2026-08-12
答案先行: Cloudflare 放行 AI 爬虫,最稳妥的做法不是只改 robots.txt,而是先在 AI Crawl Control 里允许指定爬虫,再用 WAF 限定可访问路径,最后把 robots.txt 作为偏好声明。
Cloudflare 放行 AI 爬虫到底是什么意思?
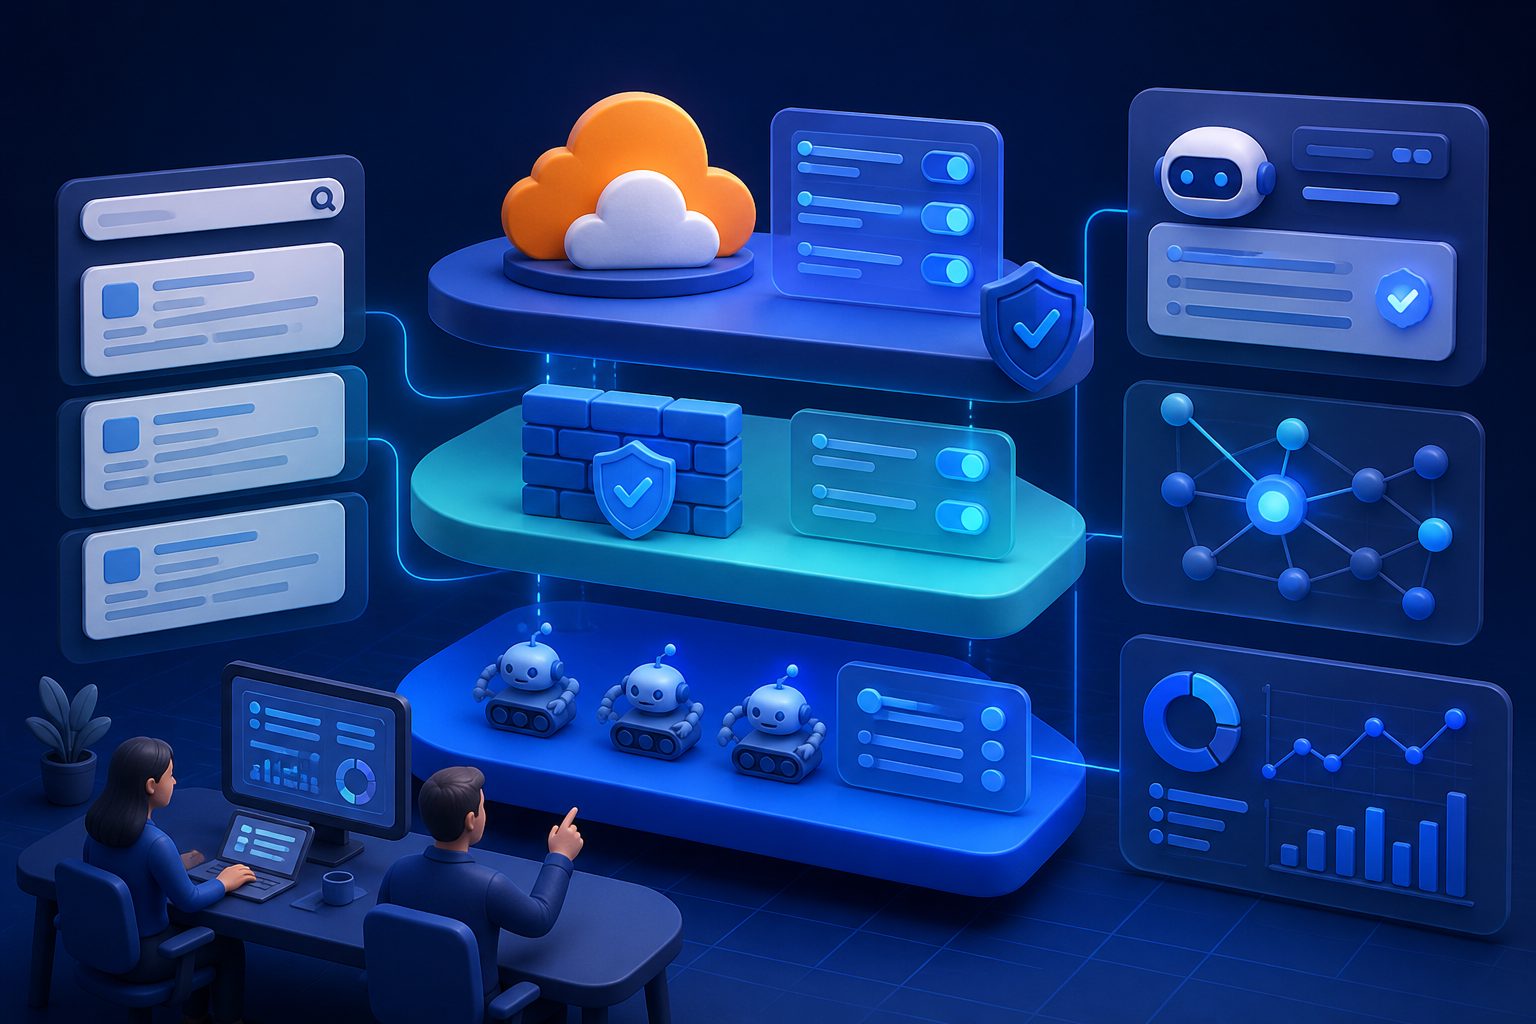
Cloudflare 放行 AI 爬虫,指的是让特定 AI crawler 能访问你想开放的内容,而不是把整站交给所有机器人。它通常分三层:robots.txt 负责表达意愿,AI Crawl Control 负责按爬虫做允许/阻止,WAF 负责做更细的路径例外和冲突处理。
| 层级 | 作用 | 适合做什么 |
|---|---|---|
| robots.txt | 表达偏好 | 先告诉爬虫哪些内容可取、哪些不可取 |
| AI Crawl Control | 按爬虫放行/阻止 | 允许指定 AI crawler 访问内容 |
| WAF custom rules | 精细控制 | 只放行某些目录、排除特定路径、处理规则冲突 |
Cloudflare 自己也明确写过,robots.txt 只是 voluntary,不是技术强制;如果要真正限制或放行,还是要靠安全层来执行。官方说明见 Cloudflare 的 managed robots.txt 说明。
先判断是哪一层在拦
先判断拦截发生在 robots.txt、AI Crawl Control 还是 WAF,这是最关键的一步。因为你在界面里看到“Allow”,不代表前面的自定义规则没有先把它拦掉;Cloudflare 也说明了,AI Crawl Control 的 block 规则会落在现有 WAF custom rules 之后,前面的规则仍可能先起作用。相关机制可见 AI Crawl Control 与 Cloudflare WAF 的关系。
如果你已经看到 403,优先对照 AI 爬虫 403 排查清单;如果是 GPTBot 单独异常,再看 Cloudflare 拦截 GPTBot 的排查思路。
最小放行方案:只放行该放的那部分
推荐策略是“先允许,再收口”。 也就是先让目标爬虫进来,再把范围缩到你愿意公开的目录,而不是反过来全站放开后再补洞。
-
在 AI Crawl Control 里找到目标 crawler
先确认是 GPTBot、ClaudeBot、PerplexityBot,还是别的 AI crawler。Cloudflare 的控制台会显示 crawler、operator、请求数和 robots.txt 违例数,便于你判断该放行谁。 -
把“Allow”只给真正需要的爬虫
不要把训练型、归档型、搜索型一股脑放开。若你的目标是品牌曝光或内容引用,通常只放行与引用、检索相关的 crawler 更合理。 -
需要目录级开放时,用 WAF 加路径例外
例如只让/blog/、/docs/、/help/可抓,其余目录继续拦截。Cloudflare 文档明确提到,可以在底层 WAF 规则里加 path-based exceptions。 -
robots.txt 只做边界声明,不单独当放行开关
它适合表达偏好,不适合单独承担“真正放行”的责任。若你要兼顾 SEO 和 AI 可见性,可以把站点结构与 robots.txt 一起整理。
这也是我更推荐的“三层放行法”:身份放行、路径放行、意图声明 三者分开。
放行后怎么验证是否真的生效
放行不等于被引用。要确认它真的生效,至少看三件事:爬虫是否到站、返回码是否正常、内容是否在 AI 答案里出现。Cloudflare 的 AI Crawl Control 页面能看请求与 robots.txt 违例,WAF 侧则能看是否还有上游规则在挡。
验证时,别只看一次浏览器访问。更靠谱的顺序是:
- 看 AI Crawl Control 里的 crawler 记录是否从 Block 变成 Allow
- 看 Security / WAF 里是否还有 upstream rule 命中
- 看目标目录是否还能稳定返回 200、是否被跳转或改写
- 看你关心的 AI 引擎是否开始引用该页面
如果你的目标是“让 AI 更容易引用品牌内容”,放行之后还要做可见性监测。可参考 AI 品牌可见性监控 和 AI 搜索营销分析工具怎么选,把“能抓到”变成“能被提到”。
常见误区
只改 robots.txt 就以为放行成功
不行。robots.txt 只能表达偏好,不能强制执行。Cloudflare 也说明了,一些 crawler 会忽略它,所以它只能做辅助层。
AI Crawl Control 已经 Allow,为什么还是 403?
多半是前面的 WAF 规则还在拦。Cloudflare 文档明确提到,skip、redirect、transform 这类上游规则都可能让结果与 AI Crawl Control 的设置不一致。
能不能只放行文档页,不放行全站?
可以,这正是 WAF 例外规则最有价值的地方。先在 AI Crawl Control 允许目标 crawler,再在 WAF 里把可访问路径收窄到文档、帮助中心或品牌页。
放行后还要不要看内容结构?
要。若正文藏在 PDF、iframe 或图片里,很多 AI crawler 仍然读不顺。可以顺手检查内容是否可抓、可渲染、可引用;这类问题可参考 正文藏在 PDF、长图和 iframe 里:这些内容 AI 读不读得到,怎么改。
适合直接照抄的判断顺序
先问三个问题: 你要放行谁、放行到哪、放行后能否验证。
如果答不上来,就先不要全站放开。
- 目标 crawler 是谁
- 允许访问哪些目录
- 是否还要保留 robots.txt 边界
- 上游 WAF 是否有冲突规则
- 放行后是否能在 AI 答案里看到引用
这套顺序的好处是,既能减少误拦,也能把 AI 可见性和站点安全一起保住。
常见问题
Cloudflare 放行 AI 爬虫和放行搜索引擎爬虫是一回事吗?
不是。AI crawler、搜索引擎 bot、归档 bot 的行为和目的不同,最好分开处理,不要用一个总开关解决所有问题。
robots.txt 能替代 Cloudflare 的放行规则吗?
不能。robots.txt 适合声明,不适合强制执行;真正的放行/阻止要靠 Cloudflare 的 AI Crawl Control 或 WAF。
AI Crawl Control 放行后,还能继续限制某些路径吗?
能。可以在底层 WAF 规则里加路径例外,只开放你想开放的目录。
放行 AI 爬虫后,怎么判断有没有带来品牌收益?
看 AI 引擎是否开始引用你的内容、品牌名是否更常被提及、引用页面是否更集中在你想推的栏目。这个闭环适合接入 AI 品牌可见性监控 做持续观察。