llms.txt和robots.txt区别,核心不是“谁更先进”,而是谁管访问,谁管理解。robots.txt 决定爬虫能不能进、哪些路径别抓;llms.txt 只是给 AI 一个更清晰的阅读地图,不能放行或拦截访问。Google 也明确说,llms.txt 不影响 Google Search 的可见性或排名。
一句话先讲明白:两者不是替代关系
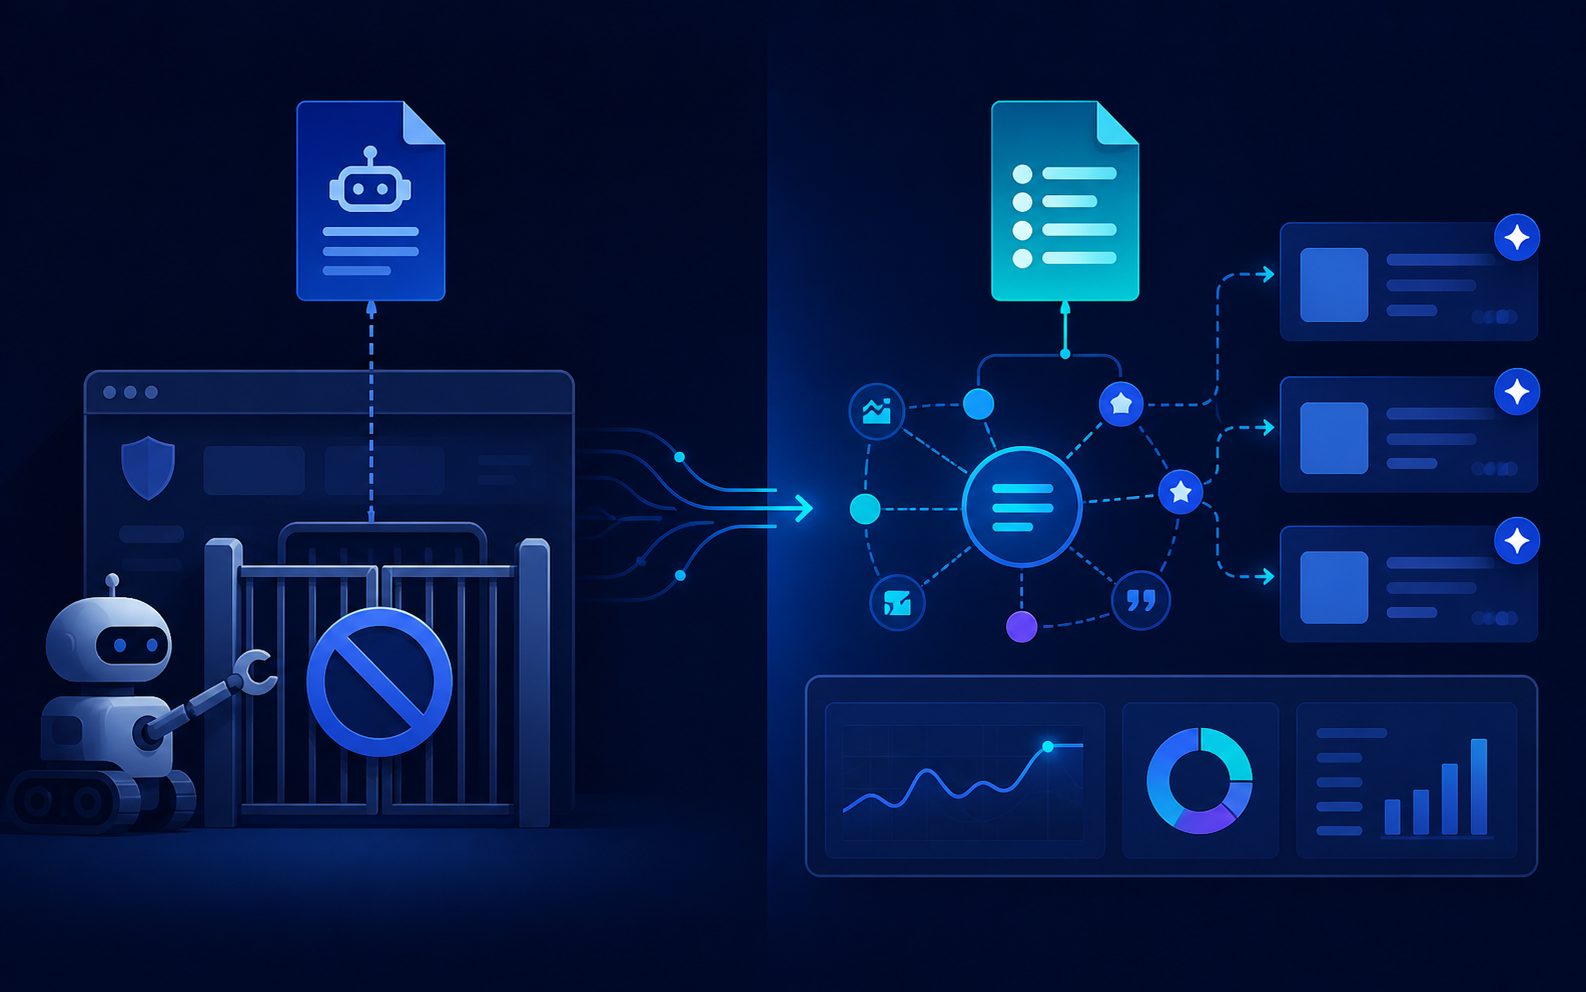
**robots.txt 是门禁,llms.txt 是导览图。**前者面向所有爬虫,核心是允许、禁止和抓取节流;后者面向 AI/LLM 的内容组织,核心是告诉系统“先看什么、怎么理解”。如果你只记住这一句,后面的大多数误区都能避开。
Google Search Central 的 robots.txt 指南说明,robots.txt 主要用于管理抓取流量,不应被当成隐藏页面的手段;而 Google 的 生成式 AI 优化指南也直接写明,Google Search 不使用 llms.txt 这类“特殊”文件。llms.txt 官方提案则把它定义成一个放在站点根目录或子目录下的 Markdown 入口页,侧重帮助 agent 找到重点内容。
llms.txt和robots.txt区别,一张表看懂
| 维度 | robots.txt | llms.txt |
|---|---|---|
| 主要职责 | 控制抓取边界 | 提供内容导航和上下文 |
| 目标对象 | 搜索引擎和各类爬虫 | LLM、AI agent、文档阅读器 |
| 能否阻止访问 | 可以,按规则限制抓取 | 不可以 |
| 能否阻止收录 | 不能保证,仍可能被索引 | 不能 |
| 常见格式 | Allow / Disallow / Sitemap | Markdown、H1、摘要、链接列表 |
| 对 Google Search | 有明确作用 | Google 明确表示不需要 |
如果你只想知道 llms.txt和robots.txt区别的实操结论:**robots.txt 先管“能不能抓”,llms.txt 再管“抓到后先看什么”。**这也是为什么它们更像前后两层,不是同一层的替代品。
为什么很多人会把它们混为一谈
混淆通常来自三个地方:文件都放根目录、都用纯文本、名字都像“给机器看的说明书”。但两者的设计目标完全不同。robots.txt 是 1994 年就已经成熟的排除协议;llms.txt 则是 2024 年提出、仍在社区演进的规范,官方页面也写明它处于开放讨论状态,且支持 H1、摘要和分区链接等结构。llms.txt 官方提案把它描述成帮助 agent 使用网站的入口文件,而不是访问控制文件。
这也是本文的第一个判断框架:**不是先问要不要写,而是先问你要解决的是“可达性”还是“可理解性”。**前者优先 robots.txt,后者才轮到 llms.txt。
什么时候该写哪个文件
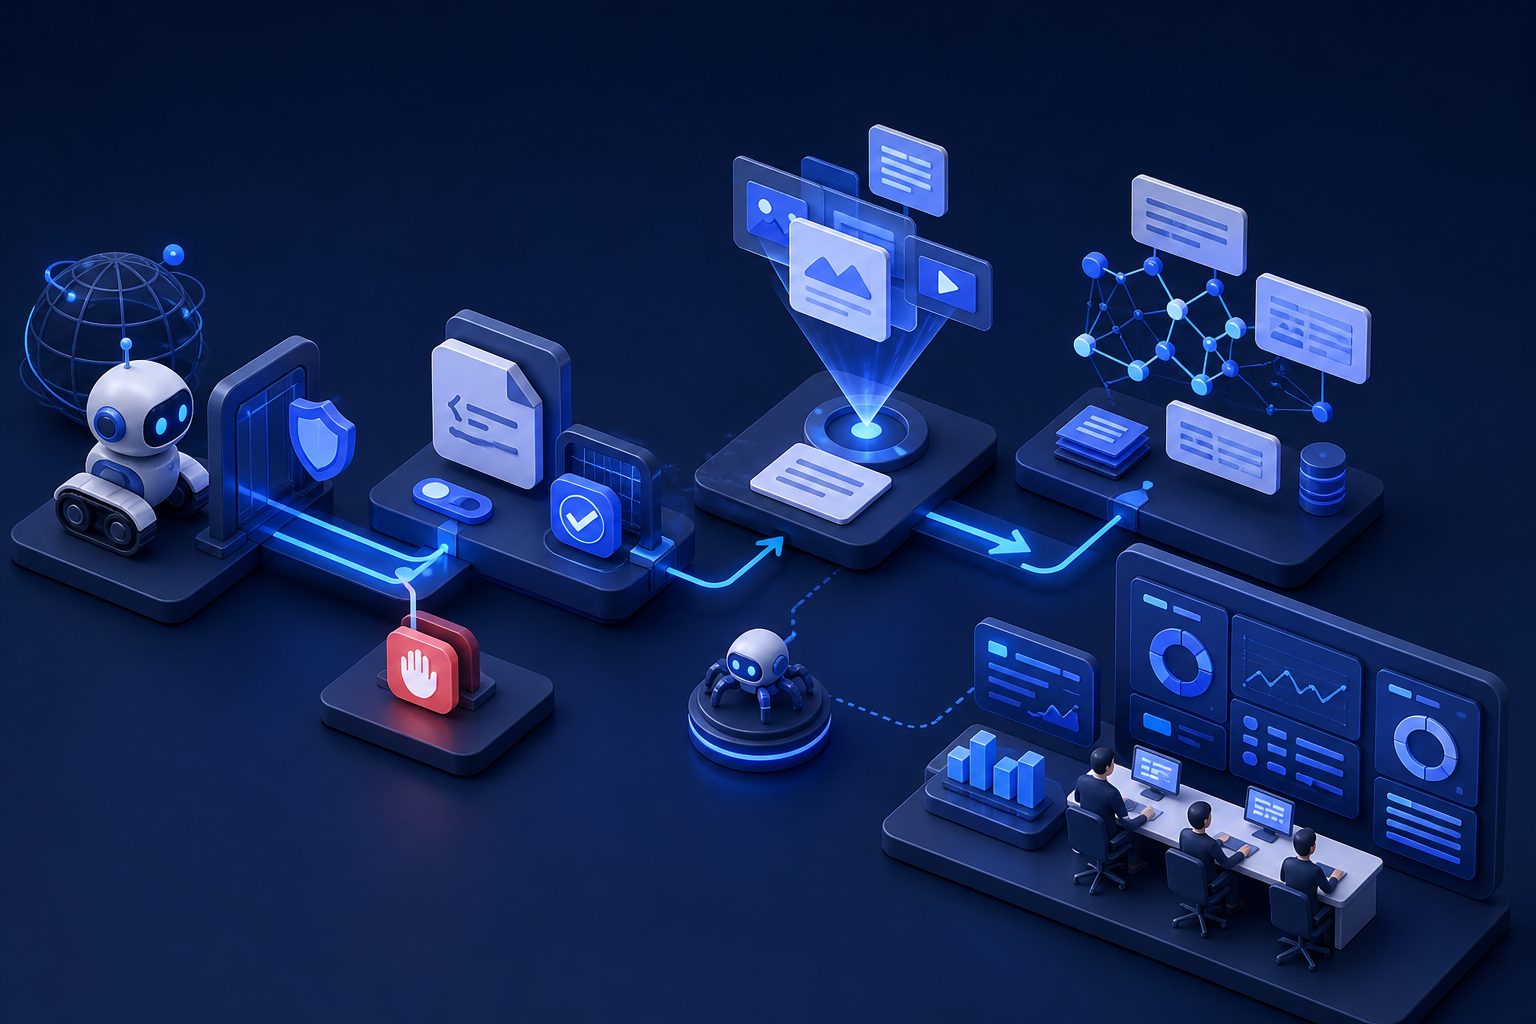
**先修 robots.txt,再谈 llms.txt。**这是最稳的顺序。
-
你要控制抓取预算、放行重要路径、屏蔽无价值目录
先做 robots.txt。这个文件决定爬虫能否进入你的站点,也决定很多 AI 爬虫是否能访问正文。若 CDN、WAF 或规则写错,AI 甚至会直接拿到 403。相关排查可看 AI爬虫403怎么排查:从 robots 到 WAF 的最小放行清单。 -
你想给 AI 一个“优先阅读”的内容入口
再考虑 llms.txt。适合文档站、知识库、产品说明页、内容体量大的站点,尤其是页面层级复杂、核心答案分散时。若你关心国产 AI 是否真的能读到这些文件,可参考 llms.txt 到底要不要写:国产 AI 认不认,写了怎么验证有没有被读。 -
你做的是 AI 搜索可见性治理
只配文件不够,还要看日志、抓取状态、引用结果。可进一步参考 AI 搜索品牌可见性分析:指标、采样与诊断框架。
对 Google 和 AI 搜索的真实影响
**对 Google Search 来说,llms.txt 不是排名按钮。**Google 已明确说明,它不会因为你加了 llms.txt 就更高排名,也不会因为你没加而受罚。相反,Google 更看重清晰的技术结构、独特内容和可抓取性;robots.txt 仍然是基础设施的一部分。
另一个容易被忽略的点是:**robots.txt 不是“删除工具”。**Google 说明,如果页面被 robots.txt 阻止,URL 仍可能出现在结果里,只是描述可能缺失;如果你真正想隐藏页面,应使用密码保护或 noindex 等其他方法。这个区别在 B2B 官网、活动页、测试环境里尤其重要。
所以在 AI 搜索时代,正确顺序不是“先写 llms.txt 再说”,而是:**先保证可达,再保证可读,最后验证是否被引用。**如果你在做品牌级监测,真正要看的是 AI 引擎是否提到你、是否引用你、是否因 403 或错误分流而看不到你。
常见误区
- 把 llms.txt 当成 robots.txt 用:它不能封禁爬虫,也不能替代权限控制。
- 以为 robots.txt 能彻底挡住收录:它主要管抓取,不等于绝对删除。
- 只写文件不做验证:没看日志、没看 403、没看引用,等于只做了一半。
- 把 llms.txt 当成 Google 排名技巧:Google 已明确说不需要这类文件。
常见问题
llms.txt 会替代 robots.txt 吗?
不会。两者解决的问题不同:一个管访问,一个管内容组织。
robots.txt 能阻止页面被收录吗?
不一定。它能阻止抓取,但页面 URL 仍可能因为外链等原因出现在结果里。
Google 会读取 llms.txt 吗?
Google Search 官方说明是不需要,也不会因此改变可见性或排名。
小网站有必要写 llms.txt 吗?
如果页面少、结构简单,优先把 robots.txt、站内结构和正文质量做好;llms.txt 属于可选加分项。
只做 llms.txt,AI 搜索就会更好吗?
不会。先确保 AI 爬虫能访问,再谈内容引导和引用优化。