AI爬虫访问失败,不等于网站“没内容”,更常见的是 DNS、证书、CDN/WAF、源站鉴权或渲染链路其中一层断了。先分清失败发生在哪一层,才能避免把 robots.txt 当成万能开关。
先用“三层两问”判断失败发生在哪一层
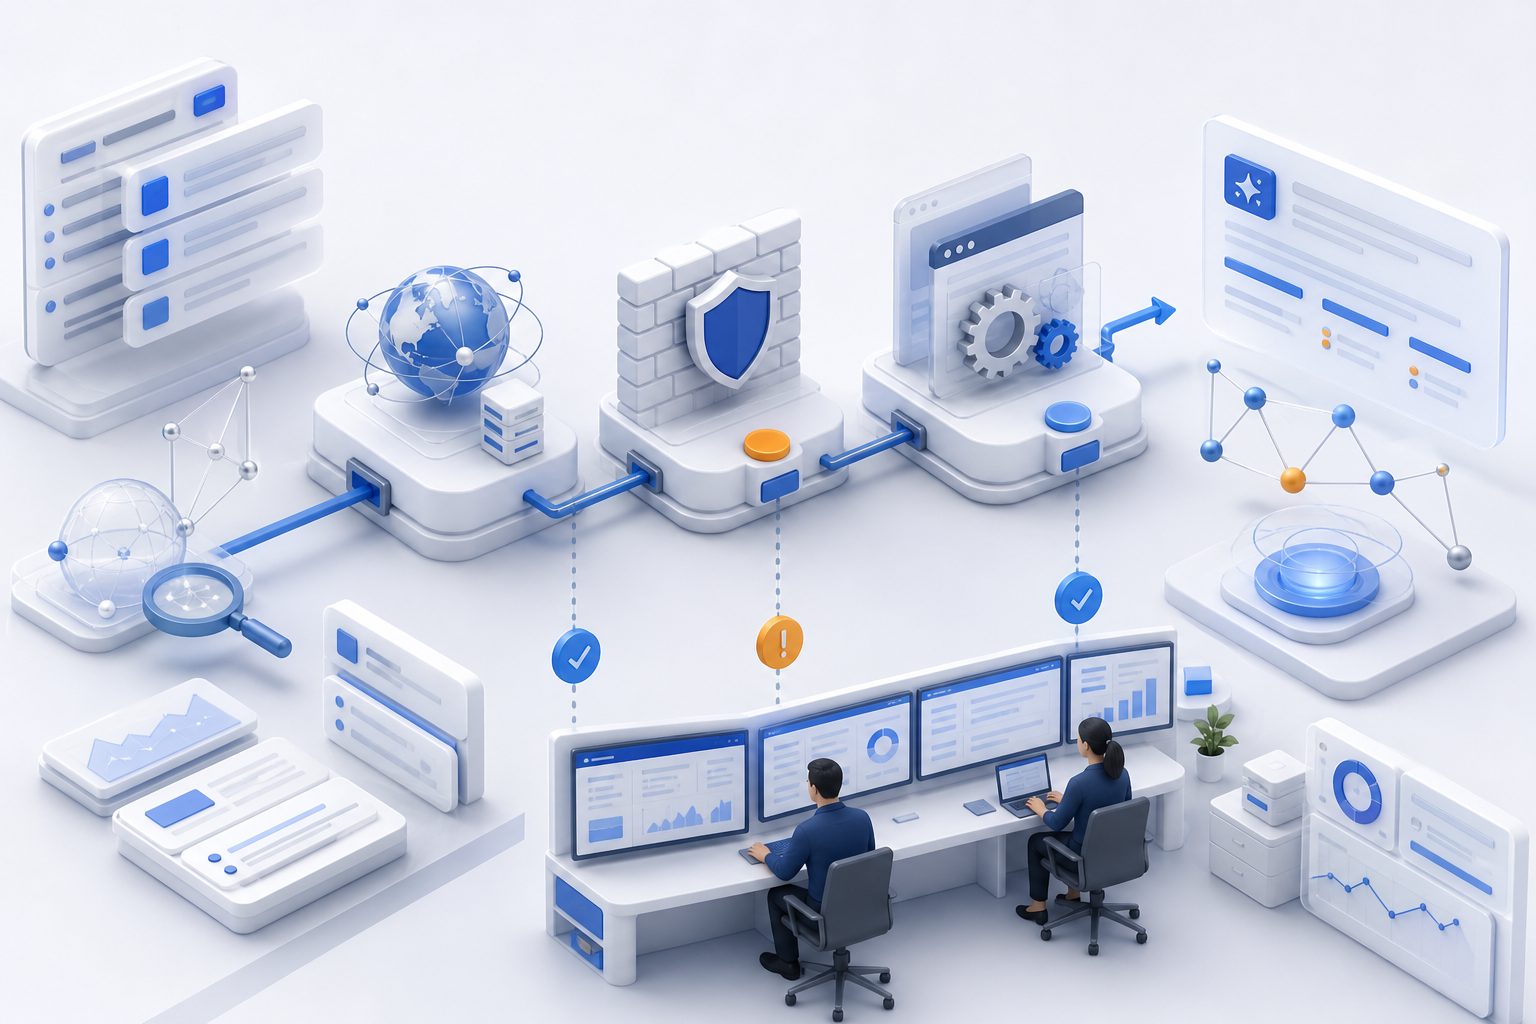
答案先行: 这类问题通常不是单点故障,而是“可发现、可请求、可解析”三层里至少断了一层。先问请求有没有到边缘,再问边缘有没有放过,最后问源站返回的页面能不能被读取。
可直接按下面顺序判断:
- 能发现吗:站点地图、内链、首页是否可达。
- 能请求吗:CDN、WAF、速率限制是否返回 403/429/challenge。
- 能解析吗:是否被登录墙、JS 渲染、iframe、PDF 或空壳模板挡住。
robots.txt 为什么常被误判成“放行成功”
答案先行: robots.txt 只是抓取指令,不是访问授权。Google Search Central 明确说明,它用于控制爬虫请求哪些 URL,但不是把页面“从搜索里清掉”的机制;RFC 9309 也指出,真正的访问控制应交给应用层安全措施。可参考 Google Search Central 的 robots.txt 介绍 和 RFC 9309。
所以,常见误区是:
- robots.txt 已允许,但 WAF 仍拦截;
- 首页可抓,内页被目录规则挡住;
- 200 返回了“验证页”,但正文其实没到。
如果需要先梳理放行顺序,可看 AI爬虫白名单配置:从 robots 到 WAF 的放行顺序。
403、429、5xx 分别说明什么
答案先行: 403 多半是“明确拒绝”,429 是“节流过度”,5xx 是“源站或上游不稳定”。Adobe 的文档也把 403 视为内容存在但访问被拒,AI 代理因此无法访问或引用;Cloudflare 的 AI Crawl Control 则强调,要同时看状态码、请求模式和 robots 合规性。
| 状态码 | 常见含义 | 优先检查项 |
|---|---|---|
| 403 | 被 WAF、鉴权或规则拒绝 | 机器人规则、IP 信誉、UA、Cookie、边缘策略 |
| 429 | 触发限速 | 频率、并发、重试策略、分路径配额 |
| 5xx | 源站异常 | 应用错误、超时、缓存回源、数据库压力 |
如果已经看到 403,优先看这篇:AI爬虫403怎么排查:从robots到WAF的最小放行清单;如果怀疑是边缘安全层误拦,再看 WAF拦截AI爬虫:403定位、身份验证与最小放行指南。
最小放行顺序:先公开页,再白名单,再限速
答案先行: 不建议一上来全站放行。更稳妥的做法是“公开内容先通、敏感路径不动、再加监控和限速”。这套顺序既能减少误拦,也能保留防刷能力。
推荐顺序如下:
- 先放首页、栏目页、详情页,不要先碰登录、结算、后台和参数态页面。
- 再放 GET/HEAD,避免把写操作也暴露出去。
- 按爬虫分层策略,例如搜索爬虫与 AI 爬虫分开配置。
- 最后加日志监控,看真实请求是否返回 2xx/304,而不是只看规则是否写上去。
如果站点是国产 AI、Cloudflare 或多 CDN 架构,还可对照 国产 AI 根本没抓到你的站:从 DNS、证书、WAF 到渲染的端到端可达性排查 做完整定位。
一张诊断表,帮你快速缩小范围
答案先行: 这张表的目标不是“猜原因”,而是让每一步都有证据。只要把请求 ID、时间、状态码、UA、路径和边缘裁决记录下来,通常 10 分钟内就能判断问题在哪一层。
- 边缘有 Block,源站没记录:问题在 CDN/WAF。
- 源站有 403,边缘放行:问题在应用鉴权、插件或服务器配置。
- 返回 200 但内容空:问题在渲染、模板或内容抽取。
- 首页正常、内页失败:问题多在目录规则、站点地图或内链发现。
常见问题
AI 爬虫访问失败但人能打开,正常吗?
正常。人类浏览器能通过 JS、Cookie 或挑战页,不代表爬虫也能通过。两者的请求能力和判定逻辑不同。
robots.txt 已经放行,为什么还是抓不到?
因为 robots.txt 只管“建议”,不管“授权”。WAF、登录墙、地域限制、证书异常都可能继续拦截。
要不要把所有 AI 爬虫都放行?
不必。更合理的是只放行公开、可引用、对品牌有价值的内容,并保留敏感路径的防护。
先解决 403 还是先优化内容?
先解决 403。内容再好,爬虫拿不到页面,也不会进入可见性链路。
结论
AI爬虫访问失败的核心,不是“要不要写 robots.txt”,而是哪一层把可见性切断了。先用“三层两问”定位,再按最小放行顺序处理,通常比盲目改规则更快、更安全。