作者:maxaeo.cn|发布日期:2026-08-30|更新日期:2026-08-30
ai搜索爬虫ua识别的核心不是“看到某个 User-Agent 就放行”,而是把 UA 字符串、来源验证、访问状态码、抓取路径与 AI 引用结果串起来判断。 对 SaaS 官网来说,这一步直接影响 ChatGPT、Perplexity、豆包、DeepSeek 等 AI 搜索是否能读取你的产品页、文档页与对比页。
什么是 AI 搜索爬虫 UA?
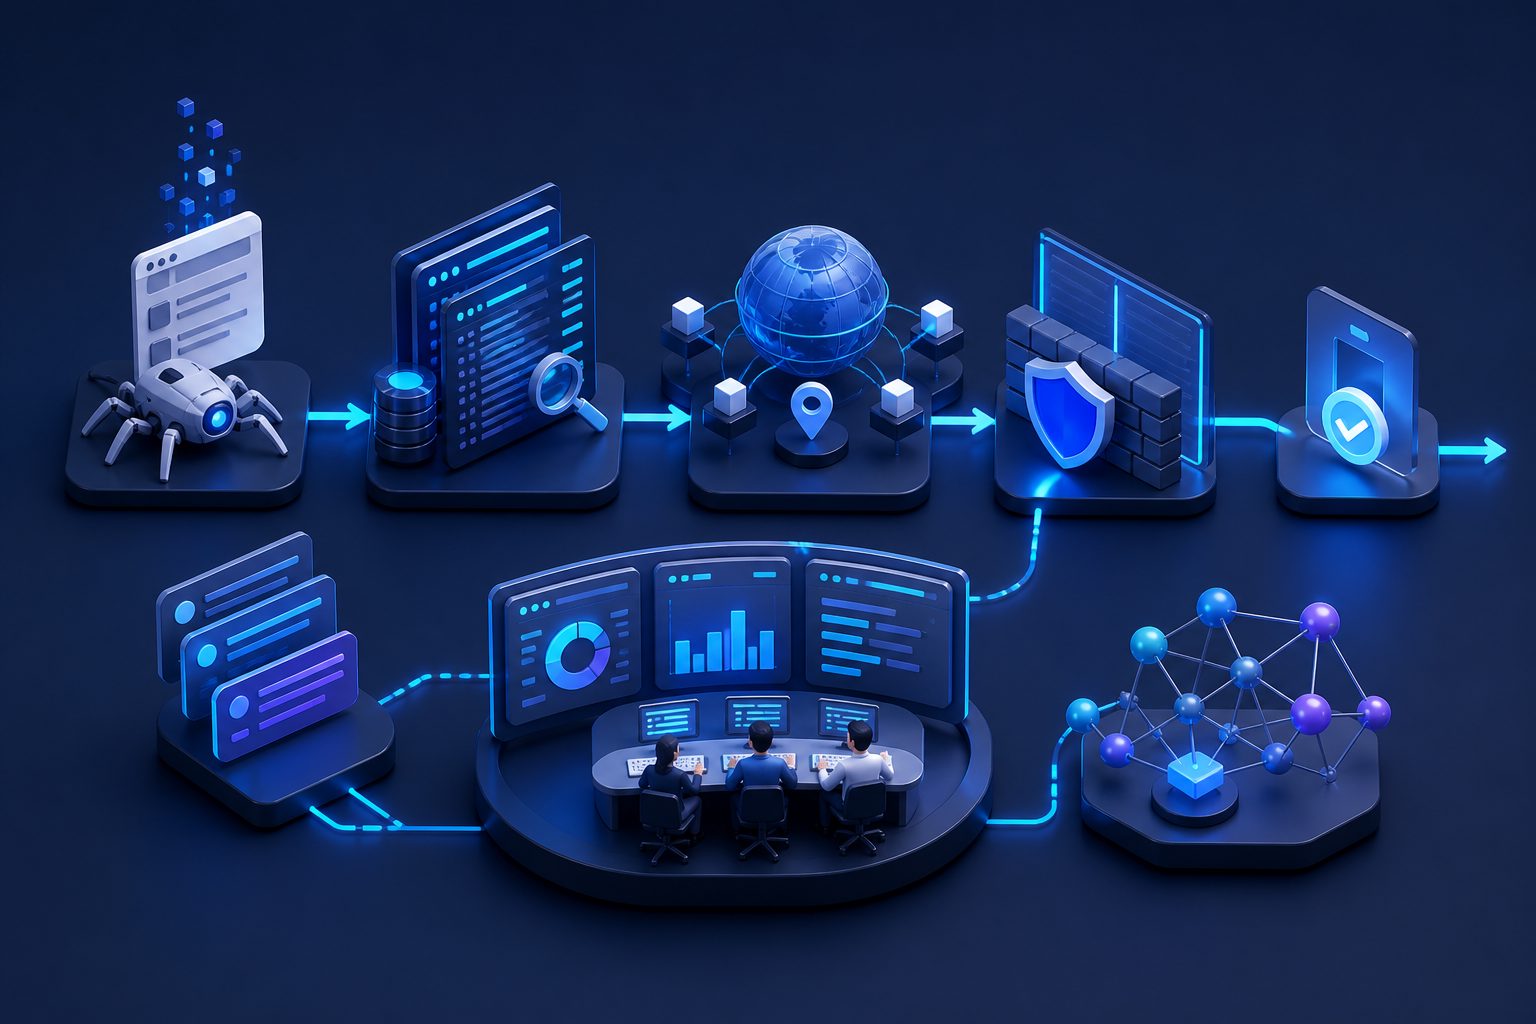
AI 搜索爬虫 UA 是 AI 平台访问网页时在 HTTP 请求头里声明的 User-Agent 标识,用来告诉网站“我是谁、为何抓取”。它可用于 robots.txt 规则匹配、日志筛选、WAF 规则配置和抓取异常排查。
但 UA 只是文本,天然可伪造。可靠识别至少要看四类证据:
- UA token:如 GPTBot、OAI-SearchBot、PerplexityBot、ClaudeBot。
- 来源验证:官方 IP 段、反向 DNS、云厂商 ASN 或安全厂商的 verified bot 标记。
- 访问结果:200、301、403、429、503 分别代表不同问题。
- 后续回声:AI 回答中是否开始引用、提及或更新你的页面信息。
Google 官方说明,Google-Extended 不是单独的 HTTP UA,而是 robots.txt 中的控制 token,抓取仍由既有 Google UA 执行;这意味着不能只在访问日志里搜索 “Google-Extended” 来判断是否被抓取,可参考 Google Crawling Infrastructure 的爬虫说明。
常见 AI 爬虫 UA 应该如何分类?
识别 AI 爬虫时,先按“用途”分类,比背完整名单更有用。因为训练爬虫、搜索索引爬虫、用户即时访问代理的放行策略不一样,混在一起容易误封或误放。
| 类型 | 典型 UA / token | 常见用途 | 建议策略 |
|---|---|---|---|
| 搜索/引用索引 | OAI-SearchBot、PerplexityBot | 让内容进入 AI 搜索结果、摘要、引用来源 | 核验后优先放行 |
| 训练/数据采集 | GPTBot、ClaudeBot、CCBot | 可能用于模型训练或数据集构建 | 按版权与业务策略决定 |
| 用户触发访问 | ChatGPT-User、Perplexity-User 等 | 用户在 AI 产品中请求打开或总结页面 | 对公开内容可谨慎放行 |
| 控制 token | Google-Extended | 控制 Google 内容是否用于 Gemini 相关训练/grounding 场景 | 写 robots.txt,不靠日志搜索 |
OpenAI 在发布者 FAQ 中明确提到,若希望网站内容进入 ChatGPT 的摘要和片段,应确认没有屏蔽 OAI-SearchBot;若希望排除潜在训练用途,则应配置 GPTBot 相关规则,可参考 OpenAI 发布者和开发者 FAQ。
只看 UA 为什么会误判?
只看 UA 会产生两类误判:把伪装流量当成官方爬虫,或把真实 AI 爬虫挡在 CDN/WAF 之外。前者带来安全风险,后者会让内容“robots.txt 允许、实际访问却 403”。
一个常见场景是:技术团队在 robots.txt 中写了 Allow: /,但 Cloudflare、Akamai、Nginx 限速或 Bot Fight Mode 仍把 AI 爬虫判为自动化流量。排查这类问题,可参考站内的 AI 爬虫访问被拦截排查指南 和 WAF 误伤机器人流量的最小放行策略。
**一手案例:**在一次匿名 B2B SaaS 官网排查中,我们抽取连续 7 天访问日志,共筛出 1,184 条包含 AI 爬虫 token 的请求。表面看 robots.txt 已允许所有公开路径,但其中 37.6% 返回 403,主要集中在 /pricing、/compare、/docs 三类页面。进一步检查发现,WAF 对“无 Cookie + 高频 HEAD/GET + 非浏览器行为”的组合触发了挑战页。放行经验证的搜索型 UA 后,公开页面 200 占比从 58.9% 提升到 91.4%。
这个案例的结论不是“全部放开”,而是:先识别目的,再限定路径,再持续复测。
如何在 Nginx 日志中识别 AI 搜索爬虫?
最快方法是用 UA token 初筛,再按状态码、路径和来源 IP 聚合。初筛只能回答“谁来过”,不能回答“它是否可信、是否读到了有效内容”。
示例日志字段假设为:
$remote_addr - $time_local "$request" $status $body_bytes_sent "$http_referer" "$http_user_agent"
可用以下命令初筛常见 AI UA:
grep -Ei "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot|CCBot|Bytespider|Googlebot|Google-Extended" access.log \
| awk '{print $1, $7, $9, $0}' \
| head -50
统计状态码:
grep -Ei "GPTBot|OAI-SearchBot|ClaudeBot|PerplexityBot|Bytespider" access.log \
| awk '{print $9}' \
| sort | uniq -c | sort -nr
统计被访问最多的路径:
grep -Ei "GPTBot|OAI-SearchBot|ClaudeBot|PerplexityBot|Bytespider" access.log \
| awk '{print $7}' \
| sed 's/?[^ ]*//' \
| sort | uniq -c | sort -nr | head -30
如果你的主题是国产 AI 平台,还应结合 ByteSpider、移动端内嵌浏览器 UA、搜索代理流量与引用结果一起判断。更完整的国产 UA 线索可参考 国产 AI 爬虫 UA 识别与 WAF 白名单配置。
一套更稳的四层验证法
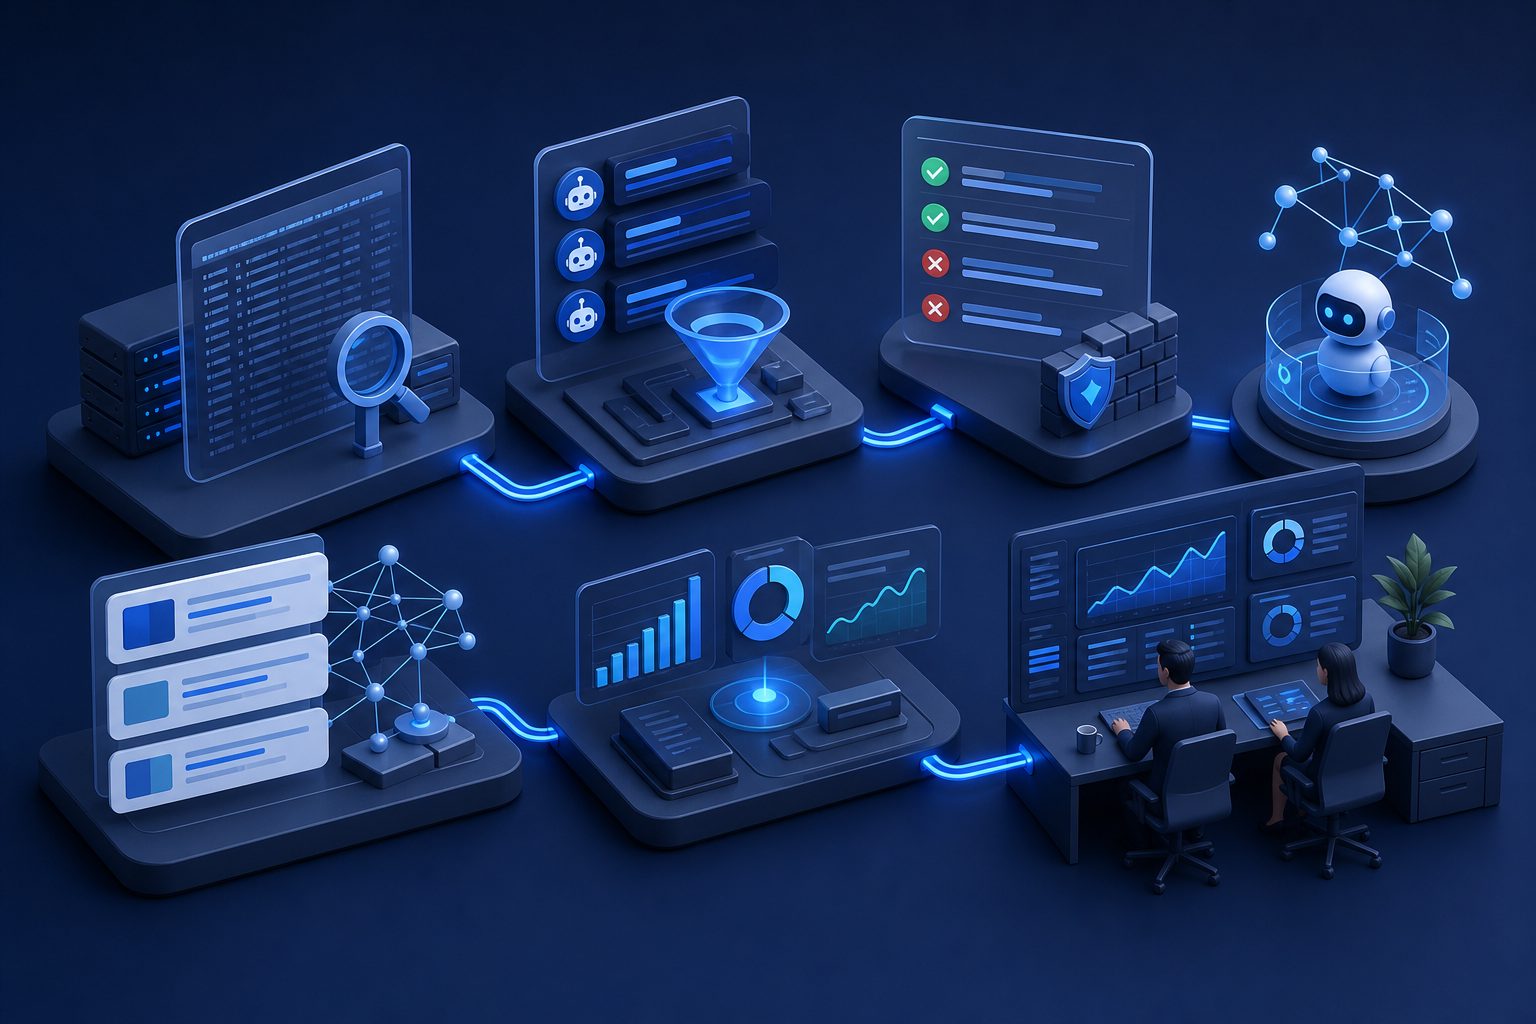
AI 爬虫识别建议采用“UA 初筛、来源校验、可访问性测试、AI 回声验证”四层法。它比单纯维护 UA 大全更稳,因为能同时发现伪造、误拦和抓取后未被引用的问题。
第 1 层:UA 初筛
建立一张内部表,至少记录:
- UA token
- 平台/公司
- 用途:搜索、训练、用户触发、广告审核、未知
- robots.txt 规则
- 是否需要 WAF 放行
- 最近一次命中时间
不要把所有 AI bot 都归为“坏爬虫”。例如 Perplexity 官方文档提供了 PerplexityBot 的 UA 与 IP 范围,并建议希望出现在搜索结果中的网站允许它访问,可参考 Perplexity Crawlers 文档。
第 2 层:来源校验
对关键爬虫做 IP/rDNS 校验。若官方提供 IP 段,优先使用官方 IP 段;若没有,就至少用反查域名、ASN、请求行为与路径组合判断。
伪代码逻辑如下:
如果 UA 命中 AI 爬虫 token
  且 IP/rDNS 可验证
  且访问公开页面返回 200/301
  则标记为“可信可访问”
否则标记为“待复核”或“疑似伪造”
Cloudflare 也维护 bot 相关参考,实际使用中可结合安全产品的 verified bot、WAF 自定义规则与日志回放,而不是手写一条永不过期的白名单。
第 3 层:可访问性测试
可访问性测试要模拟爬虫访问,不只看浏览器打开是否正常。重点检查:
- robots.txt 是否允许目标路径。
- sitemap 是否暴露关键 URL。
- 服务器是否返回 200,而不是 403、429、503。
- 是否被 JS Challenge、验证码、地区规则、登录墙拦截。
- HTML 首屏是否包含可读正文、产品信息、价格说明或 FAQ。
如果 DeepSeek、豆包、Kimi 等平台引用不到你的内容,排查顺序可参考 DeepSeek 爬虫抓取协议配置指南 与 大模型抓取 403 原因排查。
第 4 层:AI 回声验证
爬虫访问成功不等于 AI 会推荐你。还要追踪目标问题下的提及率、推荐位次、引用来源和描述准确度。
MaxAEO 国内版覆盖豆包、DeepSeek、腾讯元宝、通义千问、文心一言、Kimi、智谱清言、讯飞星火和秘塔搜索 9 个国产 AI 平台,可用于监测品牌提及率、排序、情绪评价与引用来源。它支持保留 AI 原始回答,便于回溯具体句子,并可将已有 SEO 关键词导入转为监测 Prompt。
robots.txt、WAF 与 llms.txt 应该如何配合?
robots.txt 负责表达抓取许可,WAF 负责真实拦截或放行,llms.txt 更偏向给大模型提供结构化阅读入口。三者不是替代关系,而是“声明、执行、解释”的组合。
推荐配置顺序:
- 先定业务策略:哪些页面希望被 AI 搜索引用,哪些页面不希望被训练或抓取。
- 再写 robots.txt:区分搜索型、训练型、通用型 UA。
- 同步 WAF/CDN:避免 robots.txt 允许但边缘层 403。
- 补充 llms.txt:为模型提供公司介绍、产品页、文档、案例、价格页等精选入口。
- 上线后复测:至少观察 7–14 天日志和 AI 回答变化。
示例 robots.txt 片段:
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: GPTBot
Disallow: /private/
Disallow: /account/

User-agent: *
Disallow: /admin/
Disallow: /search
如果你已经在做 GEO/AEO,建议同步检查 llms.txt 是否被读取。站内的 llms.txt 是否被读取验证方法 提供了从日志到生效判断的排查思路。
技术团队的最小放行清单
最小放行不是“所有 AI 爬虫全开”,而是只让可信爬虫访问公开、可引用、对业务有价值的页面,并保留限速与审计能力。
建议按以下清单执行:
- 允许搜索型 AI 爬虫访问首页、产品页、方案页、文档页、博客页、对比页。
- 禁止访问后台、登录后页面、站内搜索结果页、参数化重复页。
- 对高频爬虫设置合理速率限制,避免影响真实用户。
- 对训练型爬虫单独决策,不与搜索引用型爬虫混用规则。
- 对返回 403/429 的重要路径建立告警。
- 每周抽样复核 AI 回答,确认品牌描述是否准确。
MaxAEO 支持每日自动监测 AI 平台回答变化,当模型更新导致品牌排名或情感倾向波动时可识别并推送预警。对 SaaS 与工具类品牌,技术放行只是第一步,后续还需要持续跟踪“是否被提到、排第几、引用了谁”。
常见问题
UA 中包含 AI 爬虫名称就一定真实吗?
不一定。User-Agent 是请求方声明的文本,任何客户端都可能伪造。关键爬虫应结合官方 IP 段、反向 DNS、访问路径、频率、状态码与安全产品 verified bot 标记交叉验证。
Google-Extended 为什么在日志里搜不到?
因为 Google-Extended 是 robots.txt 中的控制 token,不是单独的 HTTP User-Agent。Google 官方说明其抓取由既有 Google UA 执行,所以日志里通常不会出现独立的 Google-Extended 请求。
AI 爬虫返回 403 会影响 AI 搜索可见性吗?
会。若公开产品页、文档页或对比页长期对 AI 爬虫返回 403,AI 平台可能无法读取最新内容,进而引用旧资料、第三方页面或竞品页面。应同时检查 robots.txt、WAF、CDN、验证码和地区规则。
是否应该屏蔽所有 AI 爬虫?
不建议一刀切。内容版权、服务器成本、搜索曝光和品牌可见性之间需要权衡。SaaS 官网通常应优先放行搜索/引用型爬虫,谨慎处理训练型爬虫,并限制非公开路径。
如何判断放行后真的有效?
看四个指标:目标页面 200 占比是否提升、AI 爬虫访问频次是否稳定、AI 回答中品牌提及率是否变化、自有域名在引用信源中的占比是否上升。单看一次抓取记录不足以说明生效。
结论:识别 UA 是起点,验证 AI 可见性才是终点
AI 搜索爬虫 UA 识别的正确姿势,是从“名单思维”升级为“证据链思维”。先用 UA 找到候选流量,再验证来源和状态码,随后检查 WAF 是否误拦,最后用 AI 回答中的提及、排序、情绪和引用来源确认结果。
对 SaaS 品牌而言,真正有价值的不是知道某个 bot 来过,而是知道:它是否读到了正确页面,是否在关键购买问题中引用了你,是否把你的产品讲准确。MaxAEO 提供免费 AI 可见性诊断,输入官网域名约 60 秒即可生成首份包含提及率与核心结论的报告,适合把技术抓取排查进一步连接到 GEO/AEO 优化。