作者:maxaeo.cn|发布日期:2026-08-30|更新日期:2026-08-30
国产大模型爬虫名单不能只看“网上流传的 UA 字符串”。更稳妥的做法是:把可公开核验、日志高频出现、仅社区传闻的爬虫分层管理,再决定放行、限速或阻断。
什么是国产大模型爬虫
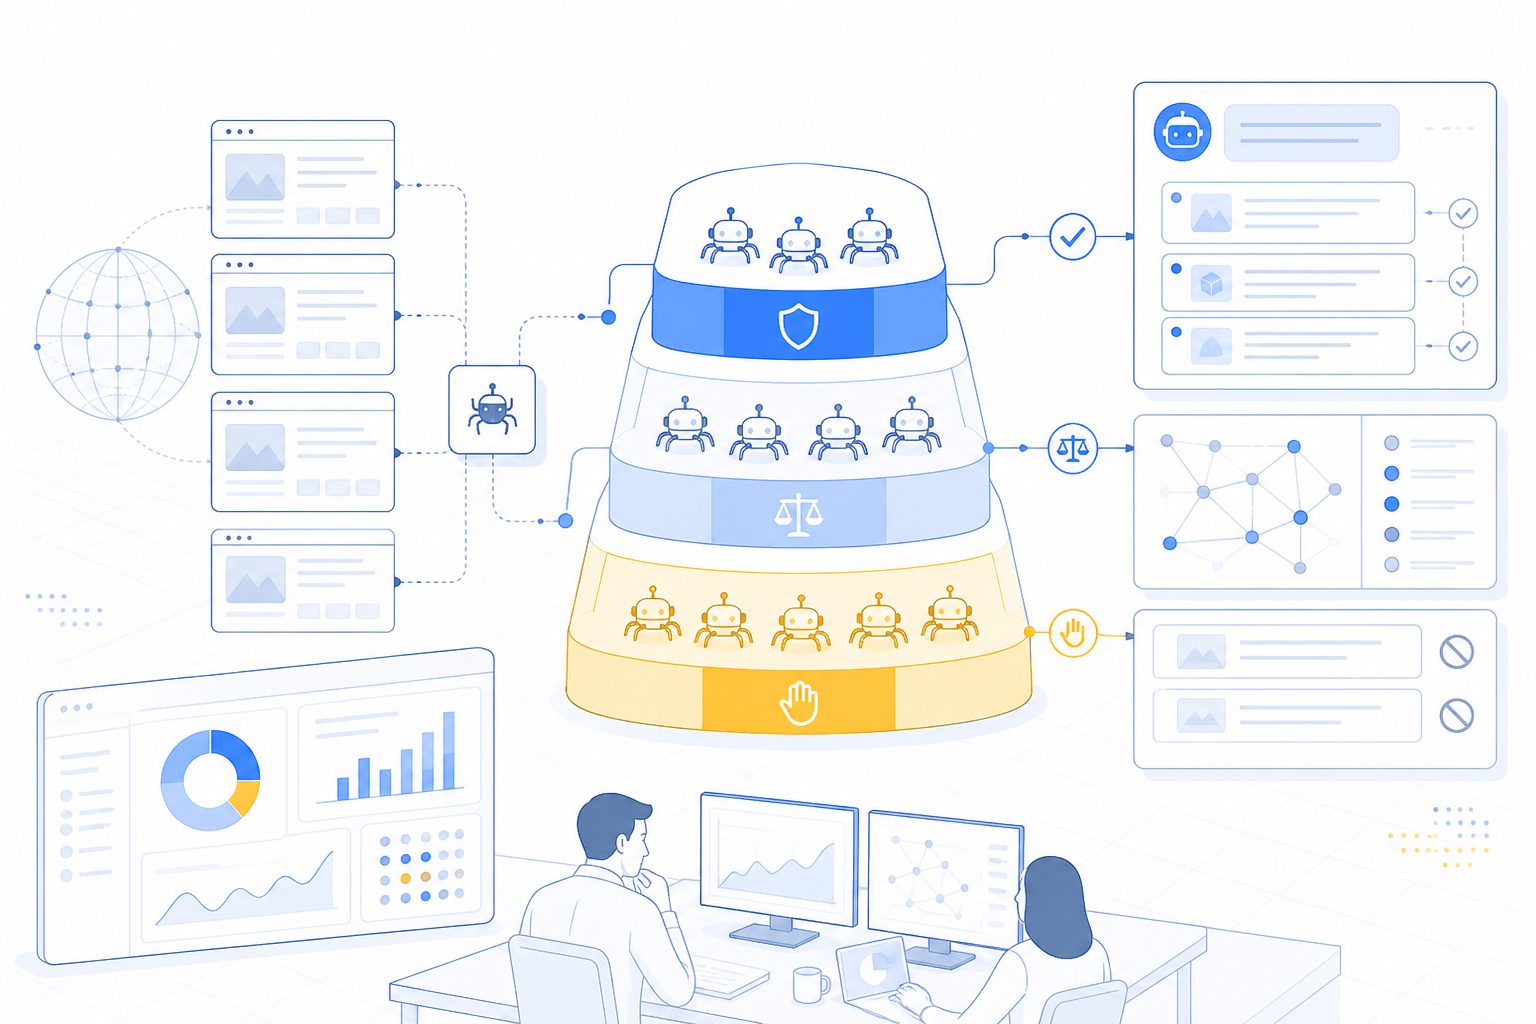
国产大模型爬虫是指国内 AI 产品、搜索引擎或模型生态用于发现、抓取、索引网页内容的自动化访问程序。它可能服务于搜索索引、AI 摘要、问答引用、训练语料或实时联网检索。
站长真正需要区分的不是“它是不是 AI 公司”,而是它的访问目的:
- 搜索索引型:如 Baiduspider、PetalBot,通常与搜索结果和内容发现相关。
- AI 语料/摘要型:如 Bytespider 等,常被归入生成式 AI 抓取讨论。
- 产品联网型:来自 AI 助手、浏览器、搜索 App 的实时请求,UA 可能更像普通浏览器。
- 伪装型:UA 写着某个爬虫名,但 IP、反查、访问节奏都不可信。
如果目标是提升 AI 搜索可见性,不建议一刀切封禁所有爬虫。更好的路径是先识别,再做目录级控制,并配合后续的 AI 引用验证。
国产大模型爬虫名单:按可信度分级
下面这份名单采用“可执行分级”,不是把所有传闻 UA 堆在一起。A 级适合优先监测,B 级适合观察与限速,C 级只建议作为日志线索,不建议直接写入白名单。
| 分级 | 常见 User-Agent / 关键词 | 关联生态 | 建议动作 |
|---|---|---|---|
| A | Baiduspider |
百度搜索、文心生态相关内容发现 | 可按目录放行,关注抓取频率 |
| A | PetalBot |
华为搜索、花瓣搜索相关索引 | 可放行公开内容,限制低价值路径 |
| A- | Bytespider |
字节跳动、豆包生态常被关联 | 建议单独限速与日志监测 |
| B | Sogou web spider、Sogou |
搜狗搜索及其内容索引 | 视业务地区与流量价值决定 |
| B | 360Spider、HaosouSpider |
360 搜索、纳米搜索生态可能相关 | 先观察引用价值,再配置 |
| B | YisouSpider |
神马搜索、移动搜索生态 | 移动内容站可重点观察 |
| C | DeepSeekBot、DeepSeek |
DeepSeek 相关传闻或日志线索 | 不建议只凭 UA 放行 |
| C | Qwen、AlibabaBot、Tongyi |
通义千问/阿里生态线索 | 需结合 IP 与来源页验证 |
| C | Kimi、Moonshot |
Kimi/月之暗面线索 | 作为日志检索词,不作强规则 |
| C | Yuanbao、Hunyuan、TencentBot |
腾讯元宝/混元线索 | 需复核,不宜盲目封禁或白名单 |
| C | ChatGLM、Zhipu、GLM |
智谱清言线索 | 仅作监控关键词 |
| C | Spark、iFlytek |
讯飞星火线索 | 仅作监控关键词 |
百度官方帮助中心明确提供了 Baiduspider 的 robots.txt 示例,可作为 A 级依据之一;Google 也在其文档中强调不同爬虫可用不同 user-agent token 管理,这一点适用于制定通用规则,参见 Google Search Central 关于爬虫与 robots 的说明。
为什么名单不能直接等于白名单
名单只是识别线索,不是信任凭证。User-Agent 本质上是 HTTP 请求头里的自报字段,任何客户端都可以伪造;真正的放行策略必须叠加 IP、DNS、访问路径、频率和返回码。
一套更安全的判断顺序是:
- 先查 UA:在 Nginx、CDN、WAF 日志里检索关键词。
- 再看路径:是否访问首页、栏目页、文章页、sitemap,而不是只扫登录、接口、参数页。
- 检查频率:是否在短时间内造成 CPU、带宽或数据库压力。
- 验证来源:能否通过官方文档、反向 DNS、CDN Bot Directory 或稳定 IP 段佐证。
- 看 AI 回声:内容被抓取后,是否真的进入 AI 回答、摘要或引用来源。
MaxAEO 的实践经验是:很多 SaaS 站点误把“可带来 AI 引用的索引爬虫”和“无价值高频抓取”放进同一条拦截规则,结果短期服务器压力下降,长期品牌在 AI 答案中的可见性也下降。相关排查思路可参考 AI 爬虫访问被拦截的排查方法。
robots.txt 应该怎么配置
robots.txt 适合表达“允许或不允许抓取哪些路径”,但它不是强制安全边界。对国产 AI 爬虫,建议采用“公开内容放行、低价值路径限制、异常流量交给 WAF”的三层策略。
一个偏稳妥的 SaaS 官网模板如下:
User-agent: Baiduspider
Allow: /
Disallow: /admin/
Disallow: /login/
Disallow: /api/

User-agent: PetalBot
Allow: /
Disallow: /admin/
Disallow: /login/
Disallow: /api/

User-agent: Bytespider
Allow: /blog/
Allow: /docs/
Disallow: /admin/
Disallow: /login/
Disallow: /api/

User-agent: *
Disallow: /admin/
Disallow: /login/
Disallow: /api/

Sitemap: https://example.com/sitemap.xml
这里的关键不是“全部放行”,而是让爬虫更容易抓到可公开传播的页面,例如产品页、案例页、帮助文档、博客和结构化说明页。更完整的 UA 写法可结合 国产 AI 爬虫 UA 识别与 WAF 白名单配置 对照。
WAF 和 Nginx 如何做最小限速
WAF 不应替代 robots.txt。robots.txt 管“礼貌爬虫”,WAF 管“高频、伪装、异常访问”。最小限速策略是:先限频,再挑战,最后才封禁。
Nginx 可用类似思路做基础限速:
map $http_user_agent $ai_bot {
    default 0;
    ~*Baiduspider 1;
    ~*PetalBot 1;
    ~*Bytespider 1;
    ~*Sogou 1;
    ~*360Spider 1;
}

limit_req_zone $binary_remote_addr zone=ai_crawler:10m rate=1r/s;

location / {
    if ($ai_bot) {
        set $limit_key $binary_remote_addr;
    }
    limit_req zone=ai_crawler burst=10 nodelay;
}
这类配置要先在测试环境验证,避免误伤正常搜索引擎、监控工具和付费广告落地页。若已经出现 403、429 或 CDN Bot Fight Mode 误拦,可参考 Cloudflare Bot Fight Mode 放行监控与 AI 爬虫的修复方案。
如何判断爬虫是否带来 AI 引用
判断国产大模型爬虫是否有价值,不能只看访问量。更可靠的指标是:抓取后品牌是否被 AI 提到、是否进入推荐排序、AI 回答是否引用自有域名或权威第三方信源。
建议建立一张“抓取—引用—提及”对照表:
| 指标 | 观察方式 | 判断含义 |
|---|---|---|
| 抓取频次 | 日志中 UA、IP、路径、状态码 | 是否有稳定发现内容 |
| 有效页面占比 | 文章页/产品页请求占比 | 是否抓到可被引用内容 |
| 返回码 | 200、304、403、429 | 是否被误拦或限速过严 |
| AI 提及率 | 在豆包、Kimi、DeepSeek 等平台测试问题 | 品牌是否进入回答 |
| 引用来源 | AI 回答引用的 URL 或站点 | 自有内容是否成为信源 |
MaxAEO 国内版覆盖 Kimi、DeepSeek、腾讯元宝、豆包、通义千问、文心一言等 9 个中国大陆 AI 平台,可监测品牌提及率、排序、情绪评价与引用来源。若要把日志识别和答案表现连起来,可使用 MaxAEO AI 搜索可见性监测平台 做持续跟踪。
一手排查框架:三张表比一份名单更有用
单独收藏国产大模型爬虫名单,只能解决“认得出”。真正能指导决策的,是三张运营表:UA 分级表、路径价值表、AI 回声表。
1. UA 分级表
记录 UA、首次出现日期、日均请求、主要路径、状态码、可信度、处理动作。A 级放行,B 级限速,C 级观察。
2. 路径价值表
把网站路径分为高价值、低价值和敏感路径。
- 高价值:
/blog/、/docs/、/case/、/pricing/ - 低价值:标签页、站内搜索页、重复筛选页
- 敏感路径:后台、登录、接口、用户数据页
3. AI 回声表
每周固定 10–20 个真实用户问题,在目标 AI 平台复测品牌是否被提到、排第几、引用了哪个 URL。MaxAEO 的 DeepSeek 爬虫抓取协议配置指南 也强调:协议配置后要回到 AI 回答里验证,而不是只看日志。
这套框架的独特价值在于,它把“爬虫治理”从安全团队的拦截动作,变成增长团队可复盘的 AI 搜索资产管理。
常见问题
国产大模型爬虫都应该放行吗?
不应该。公开内容目录可以放行或限速,后台、登录、API、参数页应限制。对来源不明、频率异常、只扫敏感路径的访问,应交给 WAF 或服务器规则处理。
只屏蔽 Bytespider 会影响豆包收录吗?
目前很难用单一 UA 直接证明某个 AI 产品的全部引用来源。更稳妥的做法是:单独记录 Bytespider 抓取变化,再用同一批问题复测豆包等平台的品牌提及和引用来源。
DeepSeekBot、Kimi、Qwen 这些 UA 能直接写 robots.txt 吗?
可以作为观察项写入,但不建议当作强信任规则。很多这类 UA 缺少稳定公开文档,优先级应低于 Baiduspider、PetalBot、Bytespider 等更常见标识。
robots.txt 能阻止所有 AI 抓取吗?
不能。robots.txt 是协议约定,不是访问控制。真正需要保护的数据应通过登录鉴权、权限校验、WAF、接口签名和缓存策略处理。
如何知道自己的网站有没有被 AI 引用?
做法是固定问题、固定平台、固定周期复测,并记录 AI 原文、排名、情绪和引用 URL。MaxAEO 支持保留 AI 原始回答,并按平台和时间维度追踪趋势,适合把结果做成长期看板。