更新日期:2026-08-18
AI 爬虫访问被拦截,通常不是单点故障,而是 robots.txt、WAF/CDN、登录校验、JS 挑战、地域限制或速率限制中的一层或多层同时生效。先分清是要放行获引用,还是要继续拦截保护内容,再决定改哪一层。
什么是 AI 爬虫访问被拦截?
AI 爬虫访问被拦截,指自动化抓取请求在访问公开页面时,被服务器返回 403、429、挑战页、跳转登录页,或拿到空白内容,导致 AI 搜索、训练或代理程序无法读取页面。Cloudflare 已把这类流量拆成 Search、Agent、Training 三类,说明“全放行”或“全阻断”都太粗糙。
Google Search Central 的技术要求也强调,页面需要能被抓取、返回 200,并具备可索引内容,才有机会进入搜索流程。对 AI 搜索引擎而言,逻辑同样成立。
为什么 robots.txt 放行了,还是会被拦截?
因为 robots.txt 只管“能不能爬”,不等于“最终能不能进”。真正的拦截常发生在边缘层和应用层,而不是文本规则本身。
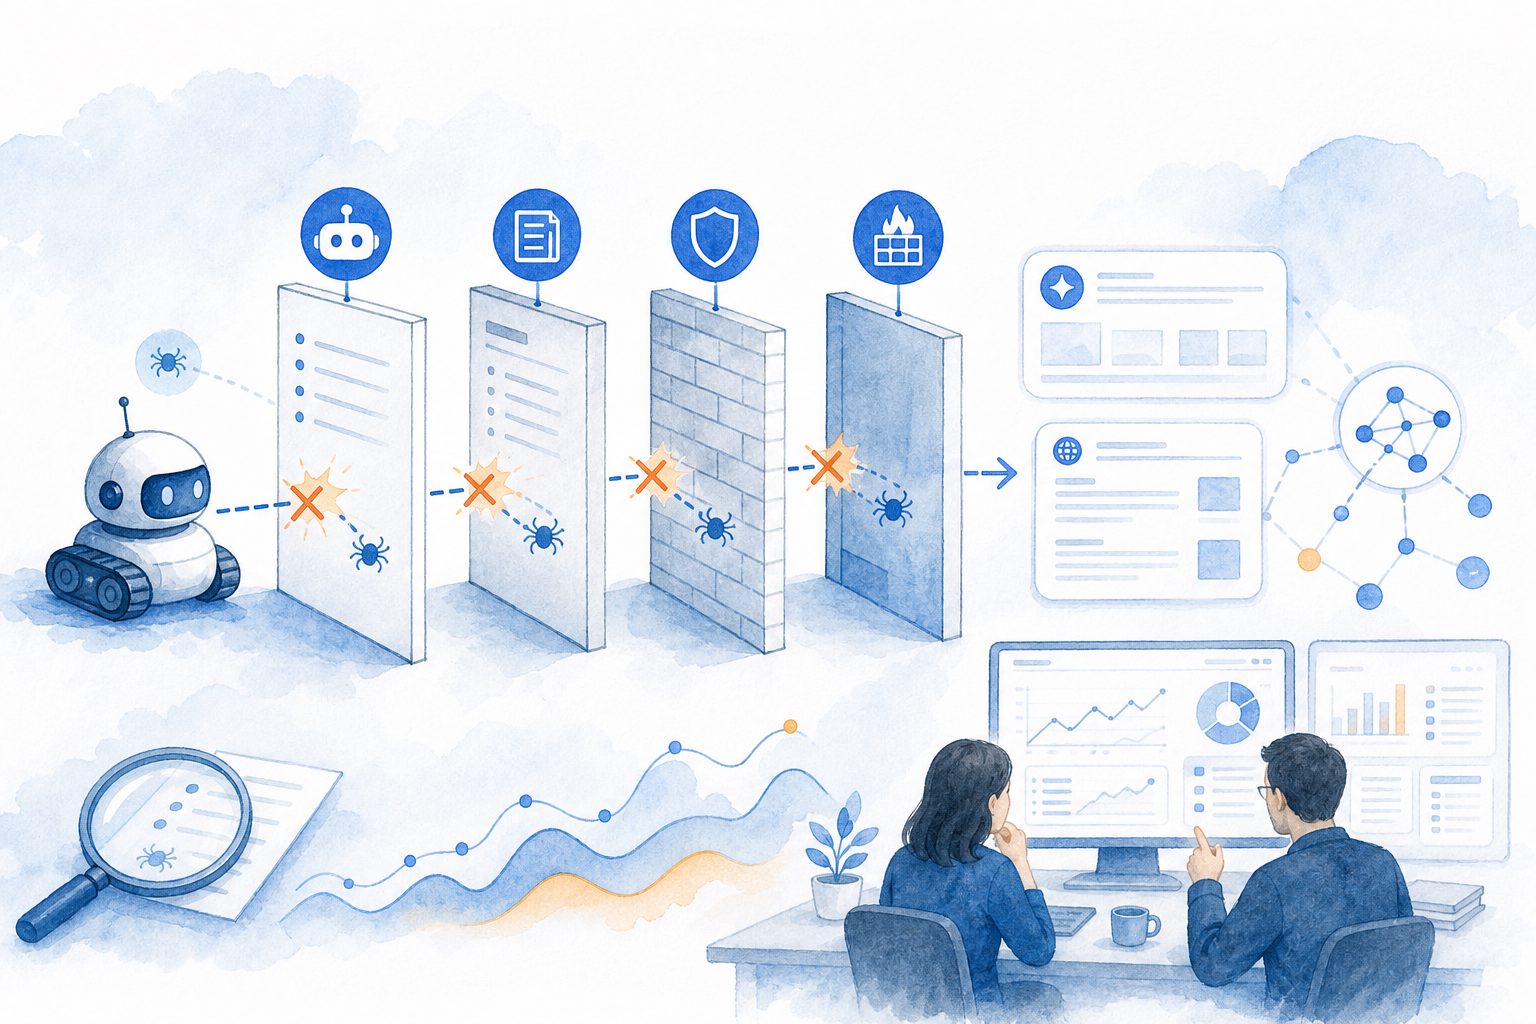
常见原因有四类:
- 边缘安全:Cloudflare、Akamai、WAF、Bot Management 直接回 403。
- 真人校验:CAPTCHA、Turnstile、行为校验、JS 验证拦住自动化请求。
- 源站规则:登录墙、地域限制、Referer 校验、速率限制、反爬库。
- 路径策略:公开页和登录页混在一起,导致爬虫先被导向不可抓页面。
OpenAI 的放行指南也明确建议逐层核验 robots.txt、WAF、CDN、机器人拦截、身份校验和速率限制。换句话说,看到 403 时,先别急着改 robots.txt。
先判断:你要放行的是搜索爬虫,还是训练/代理爬虫?
这一步最重要,也是很多文章最容易漏掉的部分。不是所有 AI 爬虫都该同样处理。
| 目标 | 建议策略 | 不建议 |
|---|---|---|
| 提升 AI 搜索引用与品牌可见性 | 放行 Search 类爬虫,公开页保留可抓取 | 一次性放开全部 AI 机器人 |
| 保护付费内容或版权资产 | 挡 Training 类爬虫,必要时限制 Agent 类 | 只改 robots.txt,不管 WAF |
| 兼顾增长和安全 | 公网区放行,登录/付费区拦截 | 用 User-Agent 作为唯一判断依据 |
这也是更稳的四问法:它是什么爬虫、该不该放、卡在哪一层、最后放多少。
如果目标是“被 AI 引用”,重点不是把门彻底打开,而是让公开、稳定、可验证的页面可访问。
可直接参考 Cloudflare 放行 AI 爬虫的最小规则 的思路,先做最小授权,再看效果。
AI 爬虫访问被拦截时,按什么顺序排查最快?
先从最外层看,再往里收缩。这个顺序最省时间。
- 看返回码:是 200、301、302、403 还是 429。
- 查 robots.txt:是否显式禁止了目标路径或目标 UA。
- 查边缘层:Cloudflare/WAF/机器人管理/挑战页是否命中。
- 查源站:登录、JS、地域、速率、应用反爬是否生效。
- 复测真实链路:不要只看浏览器,要看日志里的真实请求路径。
如果已经看到 403,可以先对照 AI 爬虫 403 排查清单 复核,再进入 WAF 拦截 AI 爬虫的实操指南 做最小放行。
很多站点的问题不在“有没有允许”,而在“允许了哪一层、是否只放了公开页”。
放行之后,怎样让内容真的被 AI 引用?
能访问,不代表一定会被引用。要让 AI 读得懂、记得住、愿意引用,页面还要满足三个条件:公开、稳定、结构清晰。
- 核心答案放在首屏和标题附近。
- 同一主题保持固定 URL,避免频繁跳转。
- 关键信息用清晰小标题和简短段落承载。
llms.txt更像导航,不是访问控制开关。
如果还没建立内容引导,可以先看 llms.txt 示例 和 llms.txt 验证方法;如果更关心品牌是否真的被 AI 提及或引用,再接上 AI 品牌可见性监控 做长期复盘。
常见问题
robots.txt 已经放行,为什么还是 403?
因为 403 往往来自 WAF、CDN、Bot Management、登录墙或真人校验,不一定是 robots.txt 的问题。
先改 robots.txt,还是先查 WAF?
先查 WAF 和边缘层,再看 robots.txt。只改文本规则,通常解决不了真正的拦截。
Cloudflare 能只放行 AI 搜索,不放训练吗?
可以。Cloudflare 已把 AI 流量区分为 Search、Agent、Training,适合按目标做更细的策略。
llms.txt 能解决 AI 爬虫被拦截吗?
不能。它更适合内容导航,不负责解除网络层拦截。
如何判断修复成功?
看真实抓取日志是否返回 200、是否访问到目标路径、以及 AI 搜索或引用是否开始出现变化。