大模型抓取 403 原因通常不是一个点,而是 robots.txt、Cloudflare/WAF、源站权限和登录校验叠加出来的。先分清 403 来自哪一层,后面的放行才不会越改越乱。
先判断 403 来自哪一层
403 不是“都一样”。带 Cloudflare 品牌的 403,通常先看边缘安全策略、WAF、Bot Management 或 AI Crawl Control;不带 Cloudflare 品牌的 403,更常见是源站自己在拒绝访问。Cloudflare 也明确说过,非品牌 403 往往来自 origin,而不是边缘层。参考:Cloudflare 403 说明
| 现象 | 更可能的位置 | 优先看什么 |
|---|---|---|
| 页面带 Cloudflare 相关提示 | 边缘/WAF/机器人策略 | 安全事件、WAF 规则、AI Crawl Control |
| 403 无 Cloudflare 品牌 | 源站 | .htaccess、Nginx/应用权限、IP deny |
| robots.txt 已禁止 | 机器人合规停止 | 这不等于 HTTP 403,本质是访问指令 |
| 只有某些 UA 或路径被挡 | 身份/路径策略 | User-Agent、Cookie、登录态、目录规则 |
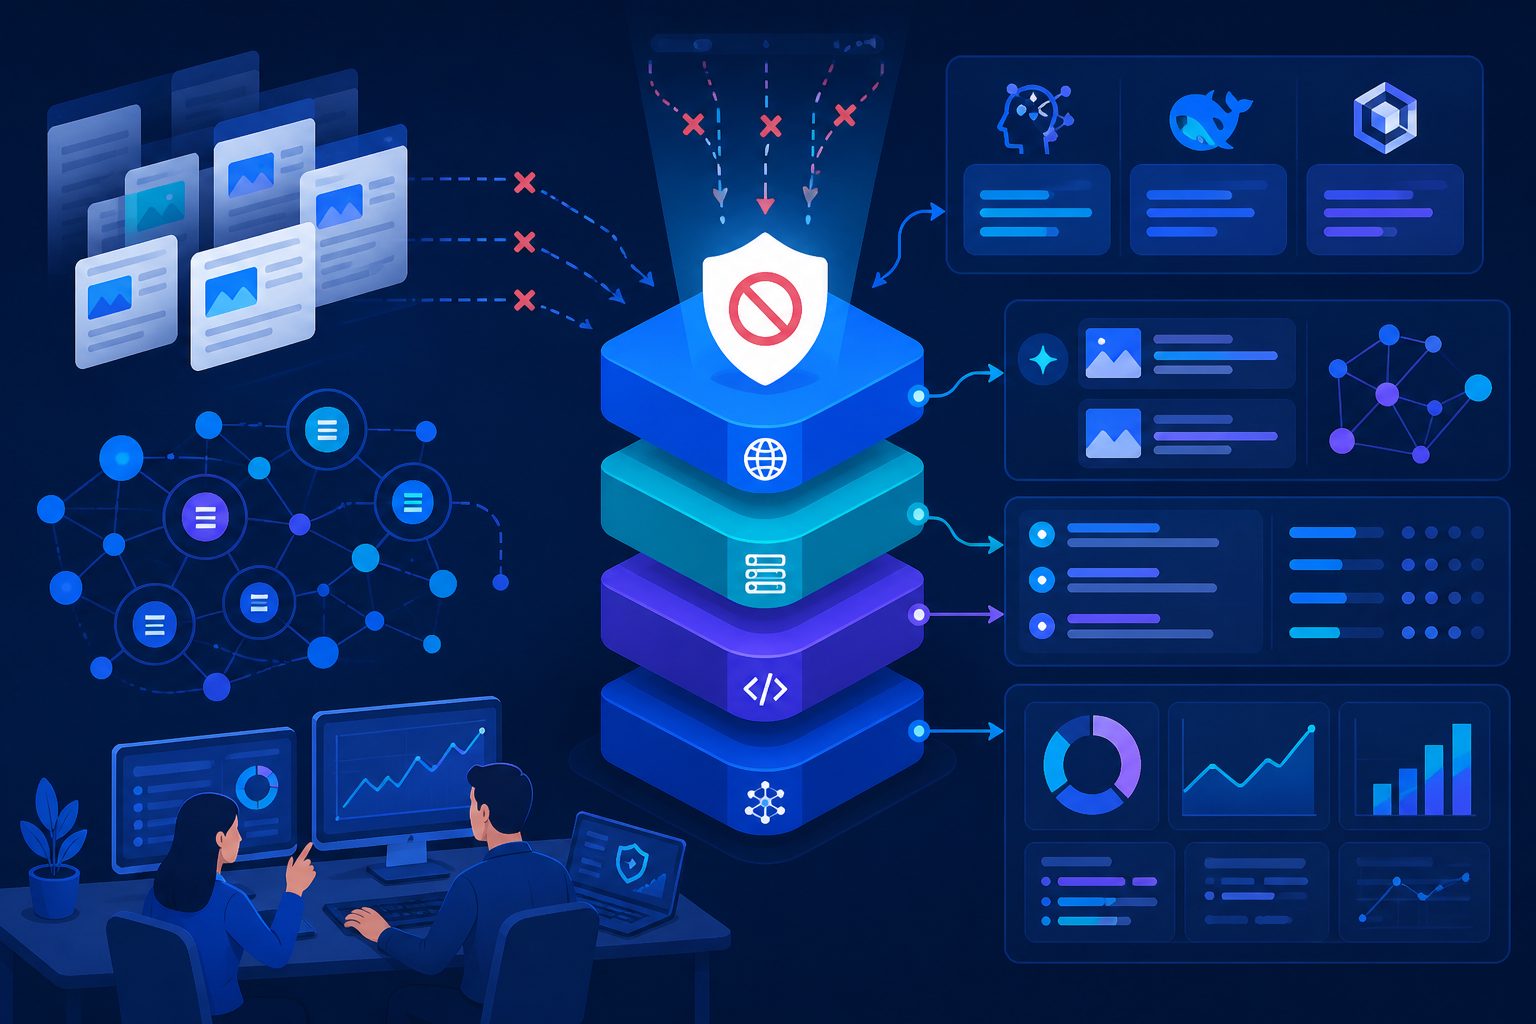
大模型抓取 403 的 5 个常见根因
第一,robots.txt 只写了“别来”,但边缘或源站仍在硬拦。 Cloudflare 提醒,robots.txt 是指令,不是强制封锁;很多大厂爬虫会遵守,但不是所有爬虫都必须遵守。参考:Cloudflare robots.txt setting
第二,WAF 或 Bot Management 把正常爬虫误判成机器人。 如果你的网站前面有 Cloudflare、Akamai 或类似防护,403 很可能是规则命中,而不是内容不可读。OpenAI 也建议按“robots.txt → web protection/bot mitigation → human verification”三层排查,并优先按 crawler 的 user-agent 做放行。参考:OpenAI 网页爬虫允许指南
第三,源站权限、目录权限或 IP deny 直接拒绝。 常见于后台、文档站、测试环境、登录墙页面。Cloudflare 的说明里也列出了 Apache、mod_security、IP 阻断这类源站原因。
第四,把限速写成了 403。 对 Google 抓取工具,Google 明确不建议用 403/404 做限速,更适合的是 429。参考:Google 抓取基础设施中的 HTTP 状态码 与 不要用 403/404 限速。
第五,把“训练爬虫”和“搜索/代理抓取”混成一类。 OpenAI 的公开说明里,GPTBot、OAI-SearchBot、OAI-AdsBot 的用途并不相同;如果目标是让内容被检索到,不一定要对所有 bot 一刀切。这个区分是很多排查文章最容易漏掉的点。
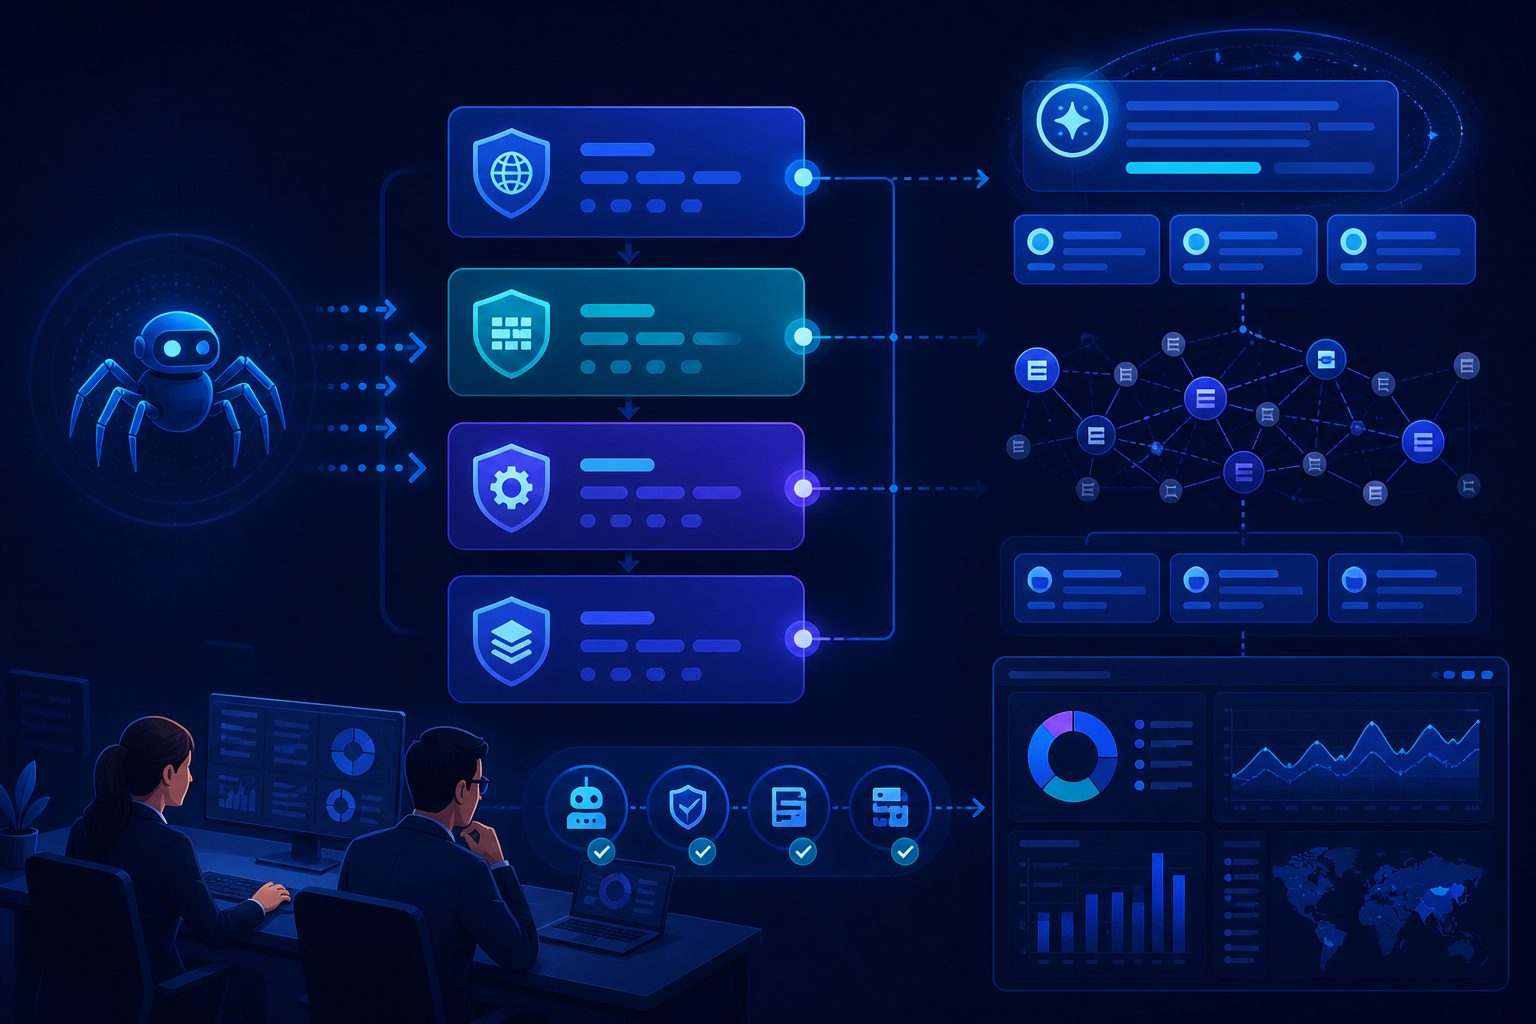
四步排查顺序,先定位再改规则
先用同一 URL 测两次:一次普通浏览器请求,一次带 bot UA 的请求。再看响应头里有没有 Cloudflare、WAF、重定向或挑战痕迹。这个动作能快速把“边缘问题”和“源站问题”分开。
curl -I https://example.com/page
curl -I -A "GPTBot/1.0" https://example.com/page
如果两个结果不同,再查日志:
- 安全事件 / WAF 日志:看命中的规则、动作和路径。
- robots.txt:确认是“禁止抓取”还是“仅建议”。
- 源站访问控制:检查权限、登录态、地理/IP 限制。
- 最小放行:先放行正确的 bot,再缩小到路径级,而不是先全开。
如果已经确认是边缘拦截,可以对照 GPTBot 403 的完整排查清单 和 WAF 误拦截排查清单。如果你想把这件事固化成 SOP,继续看 AI 爬虫访问失败怎么排查 与 Cloudflare bot 白名单配置方法。
放行策略:训练爬虫、搜索爬虫和代理抓取分开看
不要把所有 AI 爬虫都用同一条规则处理。 更稳妥的做法是:先确认你要的是“训练可见”“搜索可见”还是“实时抓取可见”,再决定放行对象。比如只想让内容进入答案检索,不必把训练型爬虫全部放开;如果页面有敏感内容,则只放行必要路径。
如果站点已经托管在 Cloudflare,优先考虑它的 AI Crawl Control 或 bot 规则,而不是只靠 robots.txt。Cloudflare 自己也强调:robots.txt 适合表达偏好,真正要硬性阻断,还是要用安全控制。对于品牌可见性团队,这一步尤其重要,因为“被抓不到”和“被回答不到”是两件事。
常见问题
1. robots.txt 允许了,为什么还是 403?
因为 robots.txt 只管“建议能不能抓”,不管所有层都不会拦。WAF、Bot Management、源站权限和人机验证都可能继续返回 403。
2. 403 和 429 有什么区别?
403 是“没有权限访问”,429 是“请求太多”。如果你的目标是限流,不要把 403 当限速响应。
3. GPTBot 和 OAI-SearchBot 要一起放行吗?
不一定。GPTBot 更偏训练场景,OAI-SearchBot 更偏搜索/检索场景。是否一起放行,要看你对内容公开度和品牌曝光的目标。
4. Cloudflare 场景下该先看哪里?
先看安全事件、WAF 规则和 AI Crawl Control,再看源站日志。若 403 没有 Cloudflare 品牌,优先回到源站权限和应用层。
5. 只看 IP 能定位问题吗?
不能只看 IP。OpenAI 也提示过,爬虫基础设施会变化,单靠短期 IP 观察不稳,最好结合 UA、验证结果和防火墙规则一起判断。
结论:403 的关键不是“拦没拦”,而是“谁在拦”
大模型抓取 403 原因的核心,往往不是内容本身,而是访问链路上的某一层策略过严。先分清边缘、源站、机器人和人机验证,再按 bot 类型做最小放行,通常比“全站开放”更安全,也更容易让内容进入 AI 搜索与引用路径。