更新日期:2026-08-13
llms.txt验证方法,核心不是看 /llms.txt 能不能打开,而是分三层确认:格式对不对、路径通不通、AI 有没有真的读到。如果目标是 Google Search,本身不会因为它加分或扣分;Google 官方已说明,llms.txt 不是 Google Search 的必需项。[Google 的生成式 AI 优化指南](https://developers.google.com/search/docs/fundamentals/ai-optimization-guide)
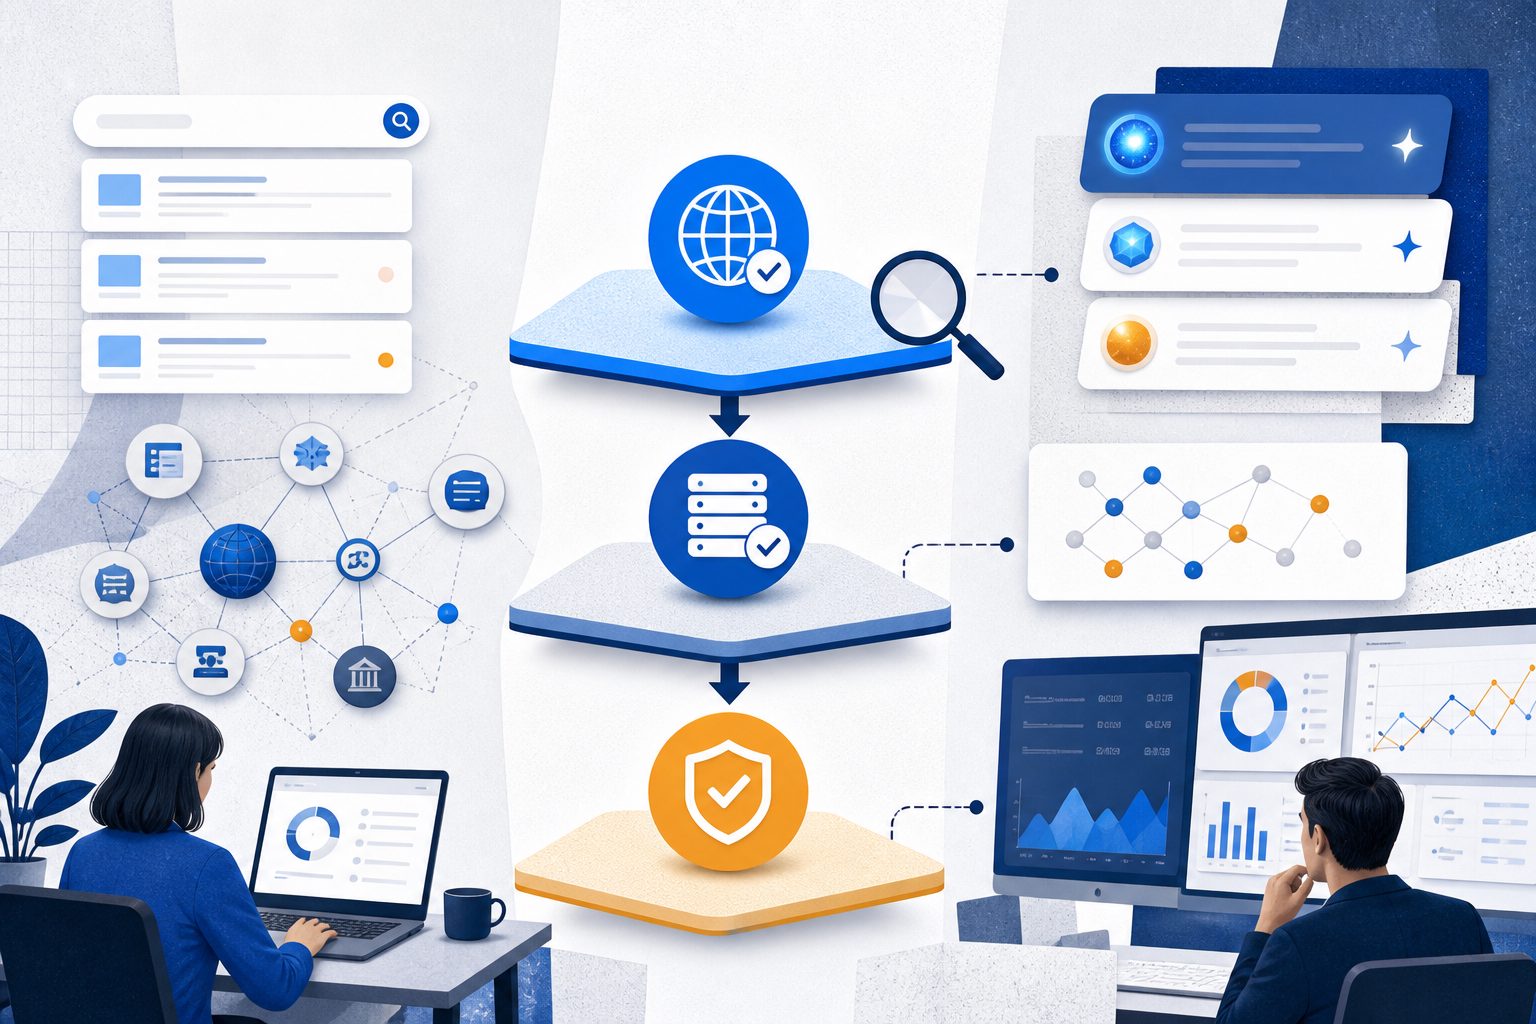
先说结论:验证要分“合规”“可达”“被读到”三层
最常见的误区,是把“文件能访问”当成“验证完成”。实际上,验证只过第一关。真正有用的做法,是先确认文件符合规范,再确认服务器返回的是正确内容,最后再看 AI 工具是否真的请求、读取并引用了它。
这个判断顺序也符合 llms.txt 官方提案 的设计:文件以 Markdown 表达,结构要清晰,且可以放在根路径或子路径;Chrome Lighthouse 的 llms.txt 审核也只是检查可访问性,不等于证明被采纳。[Chrome Lighthouse 的 llms.txt 审核说明](https://developer.chrome.com/docs/lighthouse/agentic-browsing/llms-txt?hl=zh-cn)
第一层:先验格式,别让文件“看起来像对了”
格式验证看三件事就够了:H1、摘要、链接。按官方提案,llms.txt 需要一个 H1,下面通常接一个简短 blockquote,再用小节和 Markdown 链接组织内容;如果你放在子目录,也只覆盖那个路径下的页面。若还不确定位置,可先看llms.txt放在哪里:根目录、子目录与多站点的放置规则。
一个实用的快速检查清单是:
- 文件名是否固定为
llms.txt - 是否返回 UTF-8 文本,而不是 HTML 错误页
- 是否只有一个 H1
- 摘要是否短、准、可读
- 链接是否为绝对地址
- 是否避免重复链接、测试域名和内部参数
如果你想对照样例逐项核验,可以配合llms.txt示例:可直接套用的写法、模板与检查清单一起看。
第二层:再验可访问,200 只是起点,不是终点
可访问性验证最少要做四步:状态码、重定向、内容类型、实际正文。最常见的正确结果是最终返回 200,内容是纯文本,且没有登录、验证码、WAF 拦截或 JS 空壳页。Chrome 官方文档也说明,Lighthouse 会在抓取 llms.txt 时遇到服务器错误时标记问题;如果直接返回 404,则当前只是 N/A,不代表配置成功或失败。[Chrome Lighthouse 的 llms.txt 审核说明](https://developer.chrome.com/docs/lighthouse/agentic-browsing/llms-txt?hl=zh-cn)
可直接执行的检查命令是:
curl -sS -D - https://example.com/llms.txt -o /dev/null
curl -sS https://example.com/llms.txt
判断时重点看:
- 最终是否是 HTTP 200
- 有没有长跳转链
- 响应是不是
text/plain; charset=utf-8 - 返回内容是不是你写的那个文件,而不是错误模板
- 有没有被 CDN、WAF、鉴权或地区策略拦住
如果连 /llms.txt 都抓不到,通常先排查 DNS、证书、WAF 和渲染链路;这类问题可以结合AI爬虫根本没抓到你的站:从 DNS、证书、WAF 到渲染的端到端可达性排查一起查。
第三层:最后验“有没有真的被读到”
这一步最关键,也最容易被误判。**日志里出现 GET /llms.txt,只能证明有人请求过,不足以证明内容被采用。**更稳妥的判断,是把证据分成三档:
| 证据等级 | 你看到了什么 | 能说明什么 |
|---|---|---|
| E1 | 请求了 /llms.txt |
文件被访问过 |
| E2 | 继续访问了文件里列出的页面 | 有跟随链接的迹象 |
| E3 | 回答中引用了目标页面的独有事实 | 内容可能进入了检索或生成流程 |
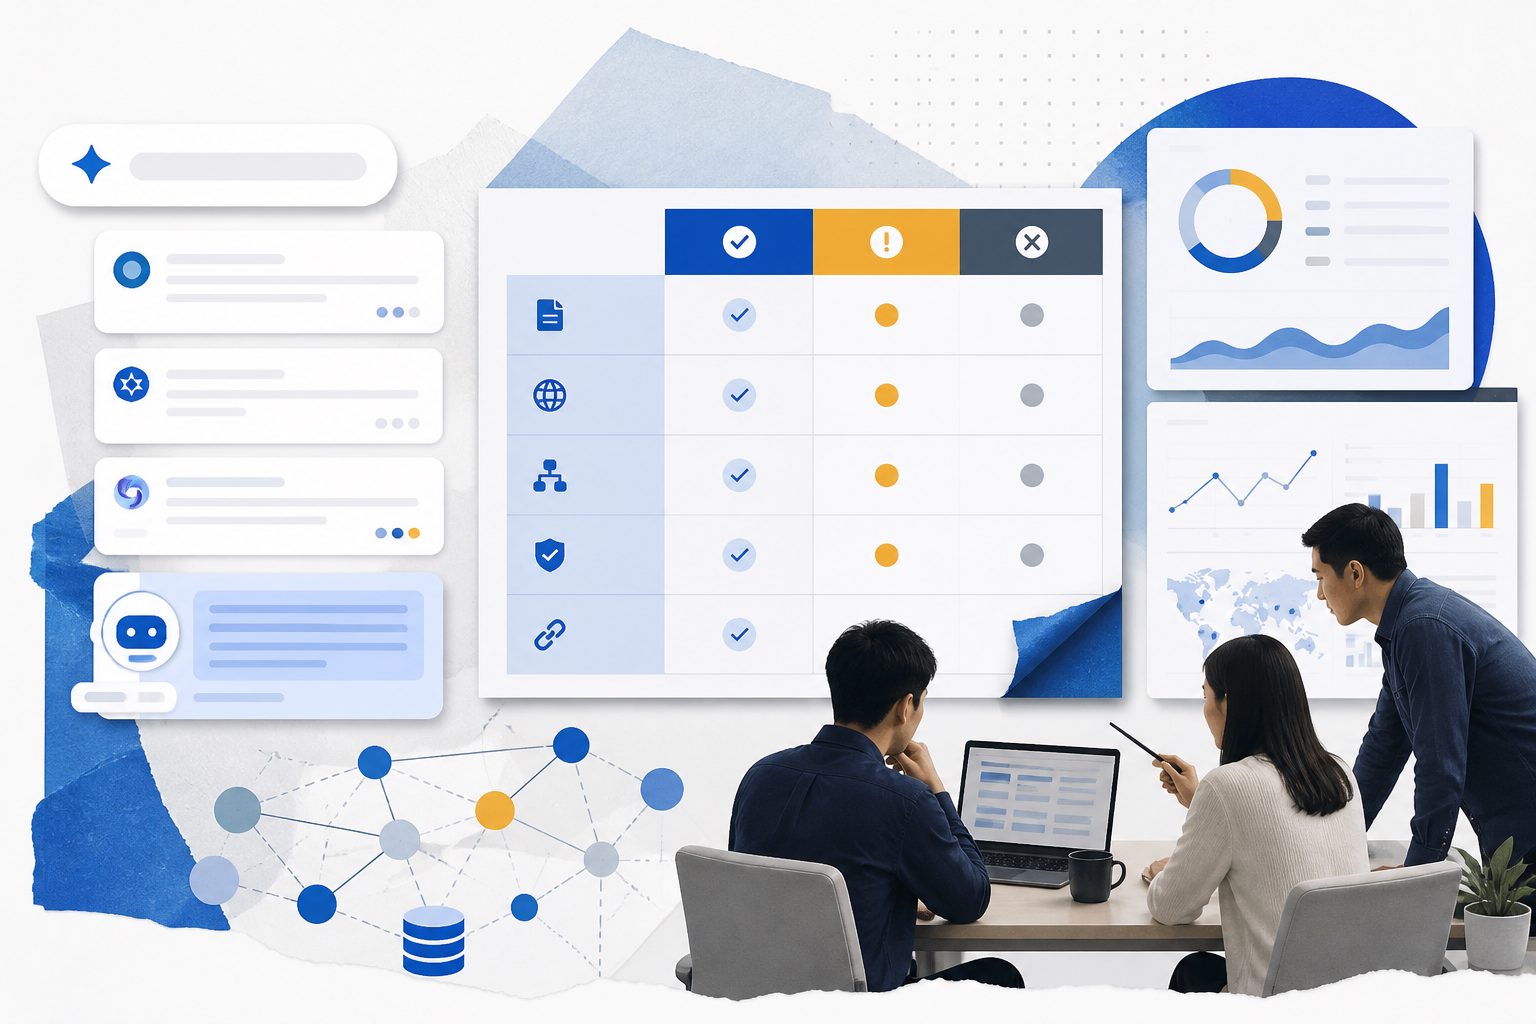
如果你要做更严肃的验证,建议用对照法:同类页面里只把一组放进 llms.txt,另一组保持不变;测试期间不要同时改正文、内链、结构化数据或 robots.txt。这样才能把“文件的作用”和“其他 SEO 变量”拆开看。想把这一步做成长期监测,可以接上AI 品牌可见性监控:从一次提及到可复盘增长。
一套可直接照做的判定标准
把 llms.txt 验证结果分成三种,就够日常使用:
- 通过:格式正确、可 200 访问、日志有请求迹象、AI 回复能引用到目标内容
- 部分通过:能访问,但格式有瑕疵,或 AI 没有读取痕迹
- 失败:403、404、返回 HTML 错页、或内容与线上实际不一致
这里的关键不是“有没有部署”,而是“有没有证据链”。对多数 SaaS 团队来说,llms.txt 更像一个内容入口说明书,不是流量开关;Google 也明确表示,它不会直接影响 Google Search 的可见性或排名。
llms.txt 验证方法和 robots.txt 验证有什么不同?
两者的目标不同。robots.txt 管的是访问边界,验证重点是“是否允许抓取”;llms.txt 管的是内容引导,验证重点是“AI 是否更容易理解和找到重点页面”。如果把它们混在一起,很容易把放行、收录、引用和排名四件事说成一件事。更完整的边界对比,可以看llms.txt和robots.txt区别:先分清访问控制与内容引导。
常见问题
1. llms.txt 能保证被 AI 读取吗?
不能。它只是一个约定好的入口文件,能降低理解成本,但不能强制任何平台读取。
2. 只有 404 就算没配好吗?
不一定。对 Chrome Lighthouse 来说,404 可能只是 N/A;但对你的业务目标来说,若你本来就要让它可用,那它就是未完成部署。
3. Google Search 会因为 llms.txt 提升排名吗?
不会。Google 官方已经说明,它不需要 llms.txt,也不会因此正向或负向影响排名。
4. 怎么知道 AI 真读了我的文件?
看三类证据:日志、后续抓取、回答引用。单看 User-Agent 不够,单看状态码也不够。
5. 我该先做什么?
先保证文件可稳定访问,再做格式校验,最后再上对照测试和可见性监测。顺序错了,后面的判断都会失真。
llms.txt 的价值,不在于“写了就有用”,而在于你能否把它变成可验证、可回溯的内容入口。真正值得做的,不是猜它会不会被读,而是把“是否被读到”变成可复盘的证据链。