作者:maxaeo.cn|发布日期:2026-08-26|更新日期:2026-08-26
Cloudflare 访问放行策略的核心,不是“全放开”,而是先分清谁在访问、访问什么路径、为何被拦,再做最小范围放行。这样既能修复误拦,又不会把防护面一次性拆掉。
什么是 Cloudflare 访问放行策略?
Cloudflare 访问放行策略,指的是把被拦截的请求按规则、身份和风险分层处理,只对必要流量开放通行。真正可用的策略,通常不是一条“允许全部”的规则,而是一组可回滚、可验证、可复盘的最小放行规则。
先判对象:哪些流量该放行,哪些不该放行?
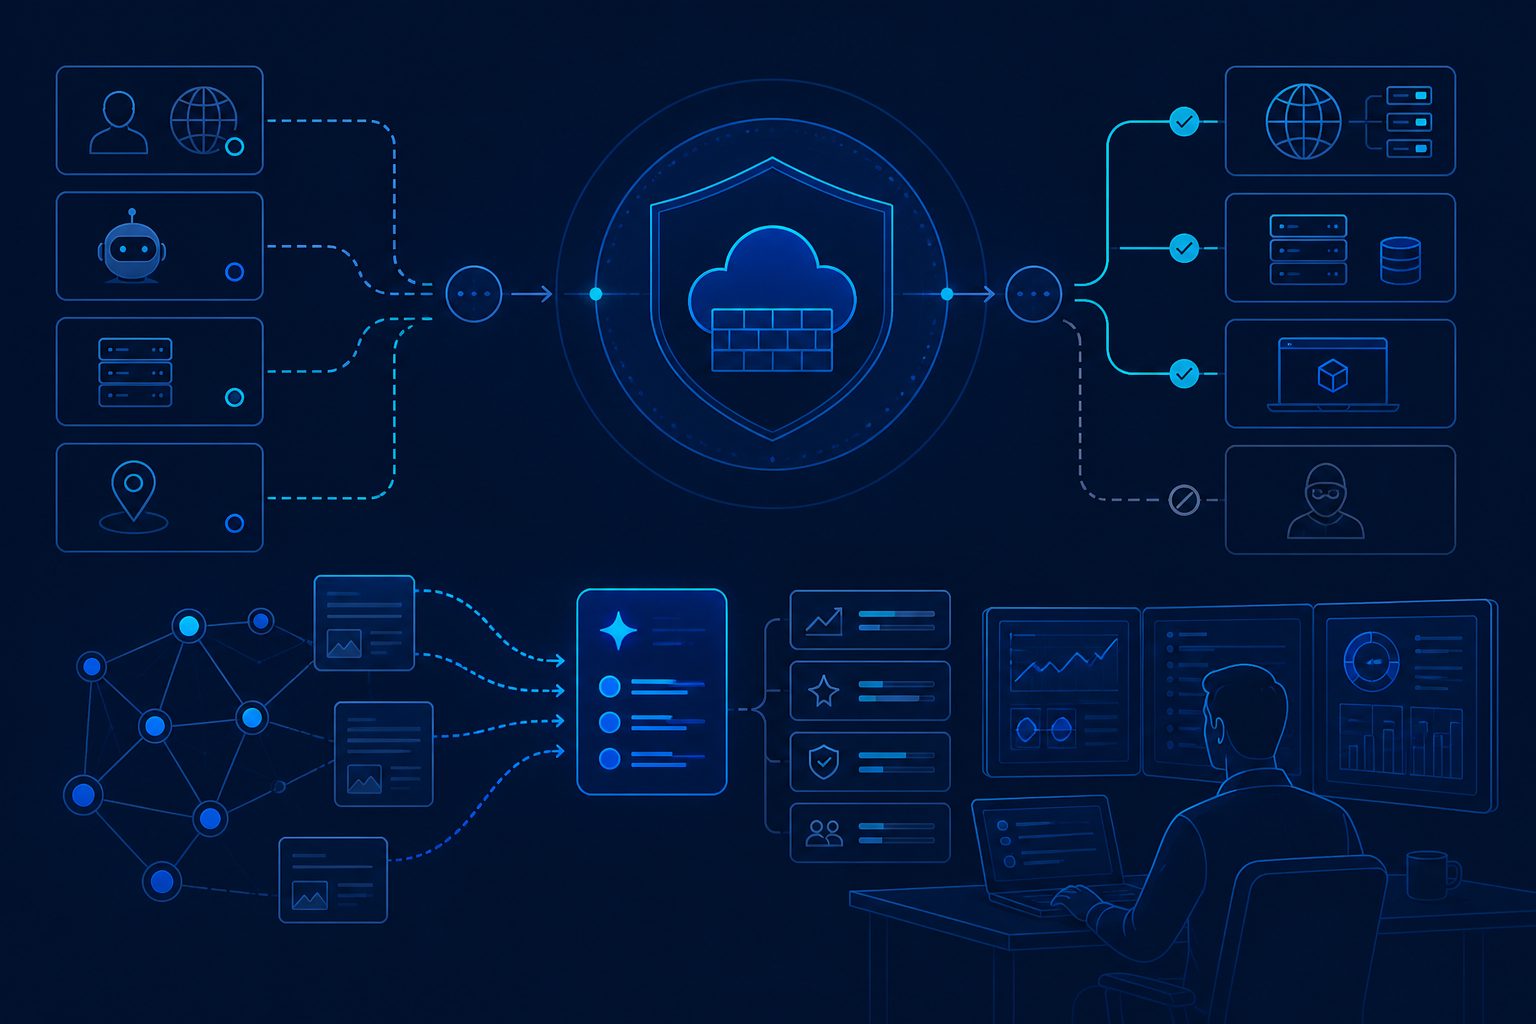
先放行“确定性高”的对象,再处理“身份不稳定”的对象。最稳妥的顺序是:业务接口 > 已验证系统 > 明确白名单来源 > 其他自动化流量。如果一上来就按 IP 段或整站放行,后面很难判断到底是修复了误拦,还是把风险一起放进来了。
| 对象类型 | 适合的放行方式 | 风险 |
|---|---|---|
| 登录、支付、API | 仅放行必要路径与方法 | 低 |
| 内部监控、回调 | IP / 证书 / 路径联合放行 | 中 |
| AI 爬虫、采集器 | 先验证来源,再局部开放 | 中高 |
| 全站匿名访问 | 不建议作为首选 | 高 |
如果你遇到的是机器人误伤,可以先对照这篇 WAF 误伤机器人流量:原因、排查与最小放行策略,先把“规则命中”与“真实风险”分开看。
最小放行的四步法,适合先修复再扩展
这套方法适合绝大多数站点。它的思路是:先锁基线,再定打法,上内容,最后看回声。对于 Cloudflare 访问放行策略,这个顺序比“先开后补”更稳。
第一步:先确认被拦的是谁
看日志里命中的规则、响应码、来源路径和方法。若是 API、Webhook、搜索抓取或后台接口,优先检查路径级规则;若是页面访问,再看挑战页、Bot 防护和地理策略。
第二步:只放行必要路径
优先放开 /api/、/webhook/、/robots.txt、/sitemap.xml、核心内容页,而不是整个域名。这样即便规则写错,影响面也有限。
第三步:把身份与风险分开
IP 白名单、UA 识别、证书、Cookie、Header 都可以作为参考,但不要只靠单一信号。尤其是自动化流量,单看 User-Agent 很容易被伪装。
第四步:上线后连续观察
放行后至少观察 24–72 小时,重点看 403、挑战页、转人工率、命中规则是否回落。若你需要排查 AI 引擎或爬虫抓取问题,可继续看 AI 爬虫访问被拦截:从 robots.txt 到 WAF 的排查与最小放行 和 大模型抓取 403 原因:四层归因与排查顺序。
为什么很多人放行后还是会被拦?
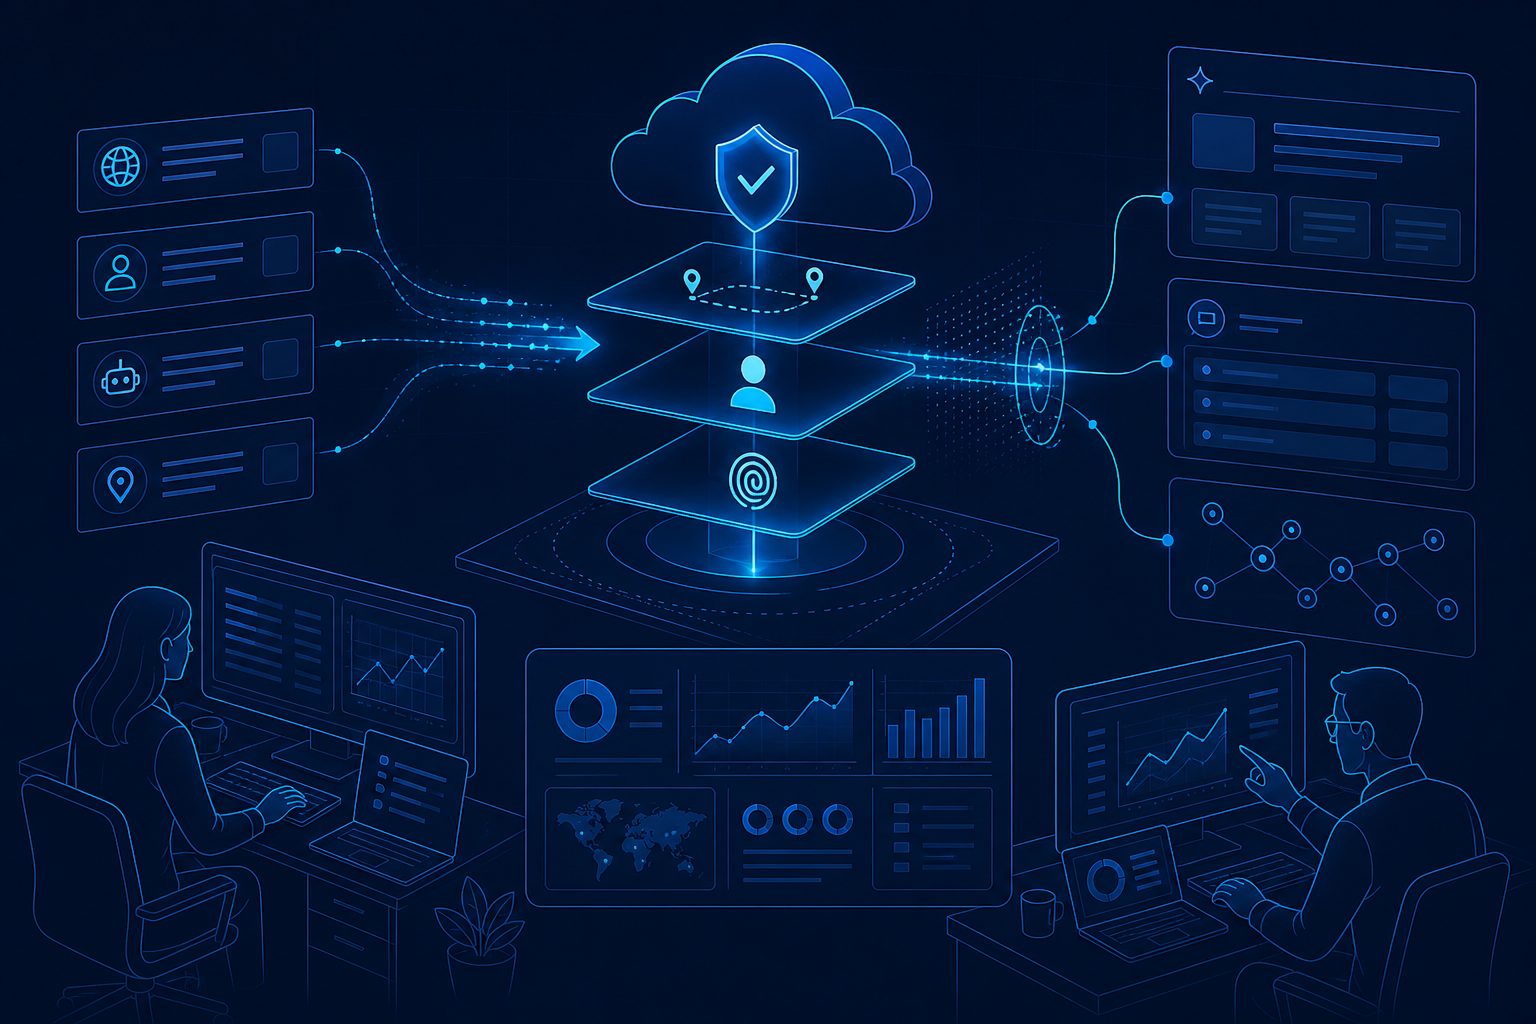
最常见的原因有四个:规则顺序错了、只改主域没改子路径、缓存没刷新、旧规则仍在生效。另一个高频问题是,把“放行某类访问”理解成“关闭全部安全策略”,结果前端看似通了,后台却仍在反复触发挑战。
如果目标是让 AI 引擎稳定读取内容,放行策略还要和内容可读性一起看。可以结合 llms.txt 文件模板与配置指南 先明确哪些内容适合被抓,再配合 Cloudflare Bot Fight Mode 放行:误拦 API、监控与 AI 爬虫的最小修复方案 做局部修正。
一个更稳的判断框架:先保业务,再谈开放
真正有效的 Cloudflare 访问放行策略,通常遵循这条原则:能用路径解决的,不用域名;能用身份解决的,不用全局;能用观察验证的,不靠猜测。
如果你的站点同时有 API、内容页和自动化抓取需求,这种分层思路比单一白名单更可持续。
常见问题
只加 IP 白名单够不够?
不够。IP 会变化,代理和云服务也会共享出口。更稳的是“IP + 路径 + 方法”联合控制。
放行 AI 爬虫要不要直接全站允许?
不建议。先放 sitemap、核心栏目和稳定内容页,再根据日志决定是否扩大范围。
为什么改完规则后,Cloudflare 仍然拦截?
通常是规则优先级、缓存、子域名遗漏或旧挑战规则未清理导致。先看命中链路,再看策略叠加。
如何判断放行有没有副作用?
看 403、挑战页、异常流量占比和关键路径的成功率是否同步改善;如果业务指标没恢复,说明放行范围仍需收缩。
什么时候不该做放行?
当你无法识别流量来源,或站点本身不需要该类访问时,不要为了“看起来顺畅”而开放整站。