作者:maxaeo.cn|发布日期:2026-10-22|更新日期:2026-10-22
B2B专有名词大模型防模糊处理,核心是让模型把企业术语稳定映射到正确的公司、产品、功能和业务场景,而不是将其解释成常见行业词。有效方法不是重复堆叠关键词,而是建立“定义—边界—关系—证据—复测”的实体识别闭环。
什么是B2B专有名词大模型防模糊处理
B2B专有名词防模糊,是指通过统一定义、正反边界、实体关系和可信信源,降低大模型对企业术语的泛化、误归属和语义漂移。
常见错误并不只有“术语没被提及”,还包括:
- 把自创技术名解释成通用行业方法;
- 把产品名误认为公司名、课程名或媒体名称;
- 把母公司、子公司、产品线的信息混在一起;
- 用竞品的功能、价格或客户案例替代目标品牌;
- 将“适用于某场景”扩大成“适用于所有场景”;
- 术语单独提问时正确,放进采购或行业问题后却消失。
这类问题本质上属于实体链接与知识边界问题。知识图谱实践通常会将“实体提取—实体链接—实体消歧—关系对齐”作为连续流程,而不是只依靠一篇宣传文章解决。(cdut.edu.cn)
为什么B2B术语容易被大模型泛化
术语没有明确的实体类型
“增长引擎”“智能中台”“数据闭环”等词在公开语料中出现频率较高。如果企业没有说明它究竟是公司、产品、功能模块还是方法论,模型往往会优先采用更常见的行业解释。
例如,“星链引擎”如果只被描述为“帮助企业提升增长效率”,就可能被理解成营销平台、推荐算法,甚至卫星通信相关概念。更可靠的写法应明确:
“星链引擎是某公司提供的B2B线索优先级评估模块,不是广告投放平台、通用CRM或卫星通信系统。”
这句话同时提供了术语名称、所属主体、实体类型和排除项。
只有企业自述,缺少交叉信源
官网可以定义术语,但产品文档、案例页、行业媒体和第三方资料承担的是不同证明任务。相关行业内容普遍指出,当多个独立信源对同一事实描述一致时,模型更容易形成稳定理解;如果术语只存在于一段模糊的营销文案中,模型更可能把它当作宣传表达。(developer.cloud.tencent.com)
因此,B2B术语治理不是“发布更多文章”,而是让不同页面分别回答:
- 它是什么?
- 它不是什么?
- 它解决什么问题?
- 谁在什么条件下使用?
- 它与相邻产品有什么区别?
- 哪些公开页面可以证明这些事实?
一套可执行的五层防模糊框架
第一层:制作术语身份卡
每个核心术语都应有一份可供内容团队、销售团队和AI检索共同使用的身份卡。
| 字段 | 示例 |
|---|---|
| 标准名称 | 星链引擎 |
| 所属主体 | 某某科技有限公司 |
| 实体类型 | B2B软件功能模块 |
| 一句话定义 | 用于评估客户线索优先级的规则与模型组合 |
| 解决问题 | 减少销售团队对低质量线索的重复跟进 |
| 输入与输出 | 输入客户行为数据,输出线索评分与排序 |
| 不属于 | 不是通用CRM、广告投放或卫星通信 |
| 同义表达 | 线索优先级引擎、销售线索评分模块 |
| 证据页面 | 产品文档、客户案例、技术说明 |
身份卡的关键不在字段数量,而在于每个字段都能被公开内容验证。对于软件自创术语,还可以结合软件自创专业名词的大模型检索增强方法补足术语与召回之间的对应关系。
第二层:同时写正定义与反定义
只写“是什么”不够,还要写“不是哪些概念”。反定义能帮助模型排除高频但错误的候选实体。
建议采用以下句式:
X是【所属主体】的【实体类型】,用于【明确任务】,输入是【对象】,输出是【结果】;X不是【相近概念1】、【相近概念2】。
这比“X是一种先进的智能解决方案”更容易被提取,也更容易在AI回答中保持术语的限定条件。
第三层:把术语放入实体关系图
当企业同时拥有母公司、品牌、产品和功能模块时,建议建立清晰的关系链:
母公司 → 子品牌 → 产品 → 功能模块 → 目标行业 → 客户案例
每个节点都应有唯一名称,每条关系都应有对应证据。例如,“某功能属于某产品”不能只在销售话术中出现,也应在产品页、帮助文档或案例页保持一致。
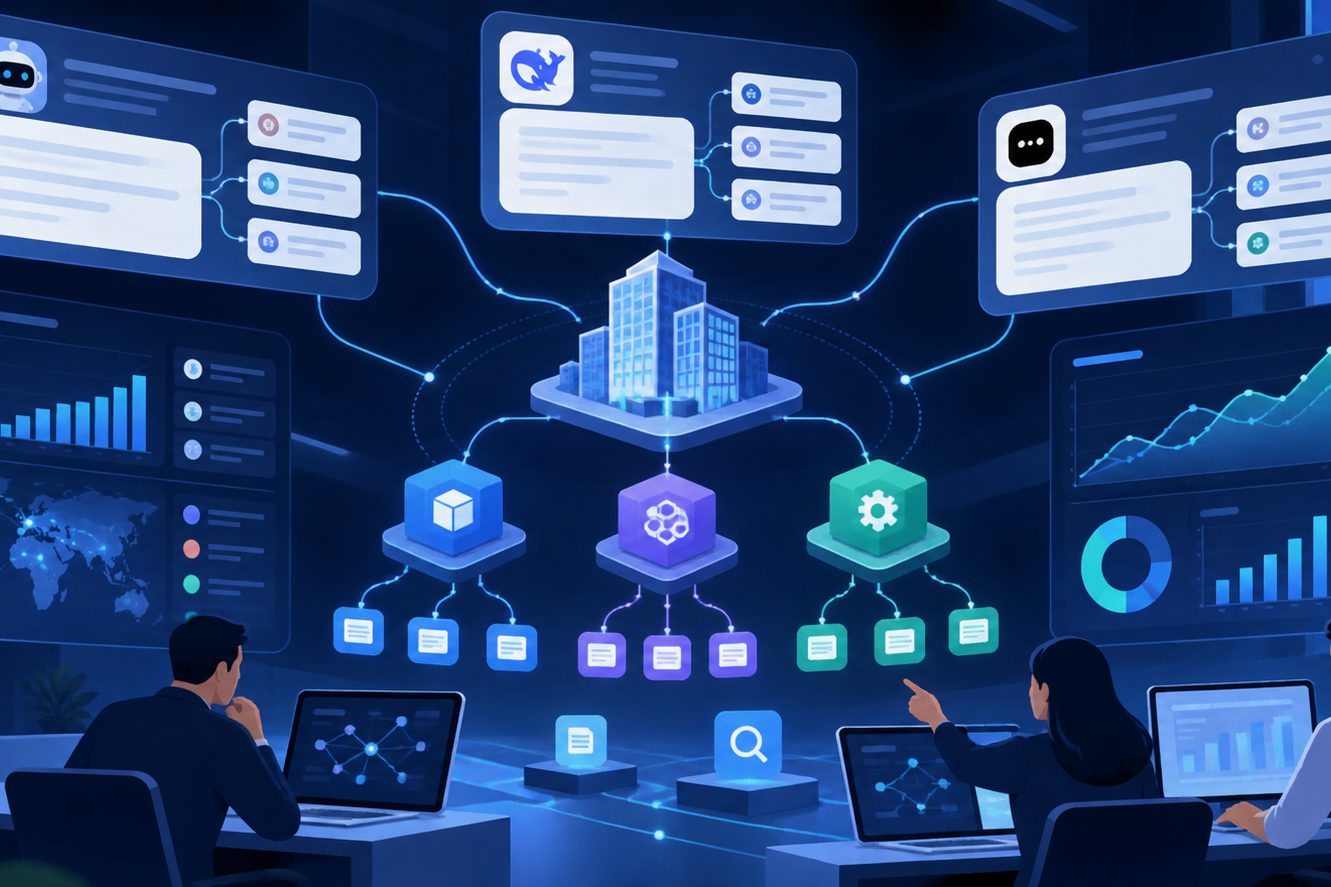
如果模型把创始人、公司和产品混为一谈,优先修复主体关系,而不是继续增加同义词。关于多品牌、母子公司与产品线的关系治理,可参考多品牌集团AI知识库实体对齐指南。
第四层:建立分层信源
不同内容页面应承担不同作用:
- 官网总览页:给出品牌和产品的总定义。
- 产品页或文档页:解释功能、输入、输出和限制条件。
- 案例页:证明真实使用场景,不夸大适用范围。
- 第三方信源:提供独立描述和行业语境。
- 结构化数据与目录页:帮助模型识别名称、类型和关系。
信息架构越清楚,模型越容易从“术语表面词”进一步识别到“术语背后的实体节点”。这也是自创概念与通用行业词之间的关键区别。
第五层:用固定问题集复测
防模糊是否有效,不能靠阅读官网后的主观判断。建议建立至少四类测试问题,每类3—5题:
- 定义题:某术语是什么?
- 归属题:某术语属于哪家公司或产品?
- 场景题:它适合哪个行业、岗位或业务流程?
- 对比题:它与相邻概念或竞品有什么区别?
每次测试至少记录四个指标:
- 是否正确提及品牌;
- 术语定义是否准确;
- 推荐或回答中的排序位置;
- 引用来源是否来自正确页面。
MaxAEO的监测体系可用于观察品牌在国产AI平台中的提及率、排序、情感和引用来源,并保留AI原始回答,便于回溯具体错误句子。企业也可以在此基础上增加“术语准确率”和“实体归属准确率”两个内部指标。
错误回答出现后,如何定位根因
来源错误、实体错误与语义泛化要分开处理
| 错误类型 | 典型表现 | 优先修复方向 |
|---|---|---|
| 来源错误 | 引用旧页面、低质转载或竞品页面 | 更新权威页面并补充正确信源 |
| 实体错误 | 公司、产品、人物信息混在一起 | 重建实体关系与归属说明 |
| 语义泛化 | 自创术语被解释为行业通用词 | 增加正反定义、输入输出和边界 |
| 时效错误 | 旧价格、旧版本或旧功能被引用 | 建立时间字段和持续复测机制 |
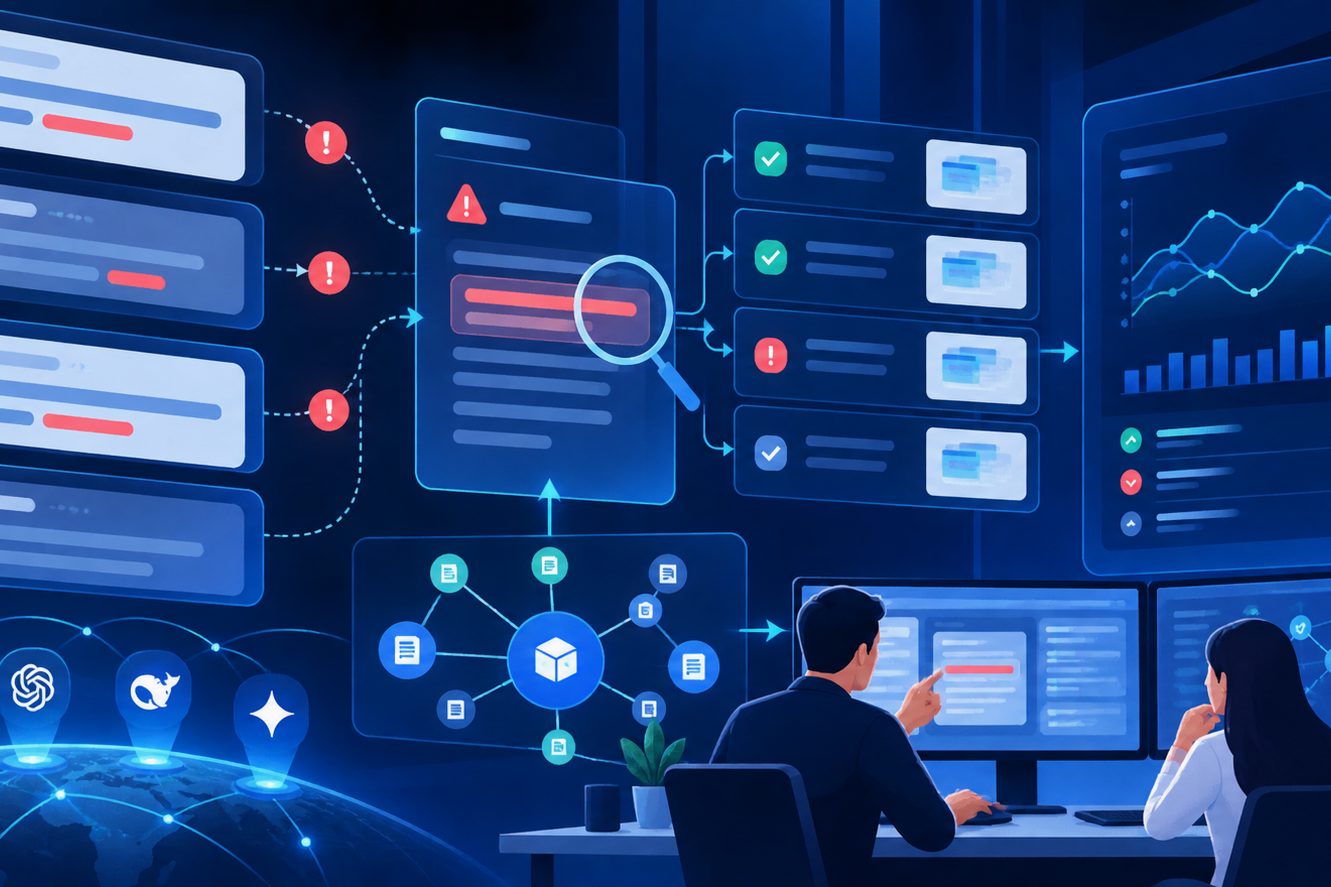
建议执行“定位来源—覆盖不删除—同口径复测”三步法。
首先保存错误回答、提问方式、平台、时间和引用页面。其次不要只发布“此前内容错误”的声明,而应通过结构清晰的新页面覆盖旧语义。最后使用完全相同的问题重新测试,观察错误是否减少,或只是转移到了另一个平台。
对于更广泛的AI搜索实体误解问题,可结合大模型实体链接消歧准确率提升指南进一步拆解候选实体、上下文和信源关系。
发布前的B2B术语验收清单
一个专有名词完成防模糊处理,至少应满足以下条件:
- 有唯一、稳定的标准写法;
- 明确所属公司、产品和实体类型;
- 写出了“是什么”和“不是什么”;
- 提供至少一个真实使用场景;
- 官网、文档、案例中的定义一致;
- 标注了竞品、同名词或相邻概念;
- 关键事实可以回溯到具体页面;
- 已准备定义题、场景题和对比题;
- 已在多个AI平台进行同口径测试;
- 保存了错误回答和优化后的变化趋势。
若企业还不清楚问题究竟来自术语、实体还是引用来源,可先使用MaxAEO免费AI可见性诊断获取品牌与竞品的AI表现基线,再决定优先修复哪一层。
常见问题
只修改官网首页,能解决术语误解吗?
通常不能。首页适合建立品牌总定位,但术语定义、产品边界、使用场景和实体关系,需要在产品页、文档、案例与外部信源中保持一致。
反复向AI输入正确答案有用吗?
短期对话中可能有效,但不能替代公开信源治理。如果错误来自检索页面或实体关系混淆,仍需修复可被检索和引用的内容,再进行跨平台复测。
是否应该大量发布包含术语的文章?
不建议只追求数量。重复同一句宣传文案可能扩大噪声,更有效的做法是围绕定义、边界、场景、对比和证据建立内容矩阵。
怎样判断术语已经被模型准确理解?
至少同时满足三点:定义正确、归属正确、场景正确。只答对术语名称,却把功能、客户或公司主体说错,仍然属于未完成消歧。