作者:maxaeo.cn|发布日期:2026-10-21|更新日期:2026-10-21
在企业级 AI 搜索与大语言模型(LLM)驱动的问答场景中,大模型实体链接消歧准确率提升是保障品牌在豆包、Kimi、DeepSeek 等大模型中被准确召回的核心前提。很多 SaaS 企业常面临痛点:当用户向 AI 询问某款软件时,AI 往往将其与同名开源库、消费品甚至竞品混为一谈,造成严重的品牌资产损耗与商业线索流失。
解决该问题的关键,在于理解大语言模型在检索增强生成(RAG)和语义解析链路中,如何通过上下文向量相似度与先验知识拓扑网络进行候选实体排序。
什么是大模型实体链接消歧?
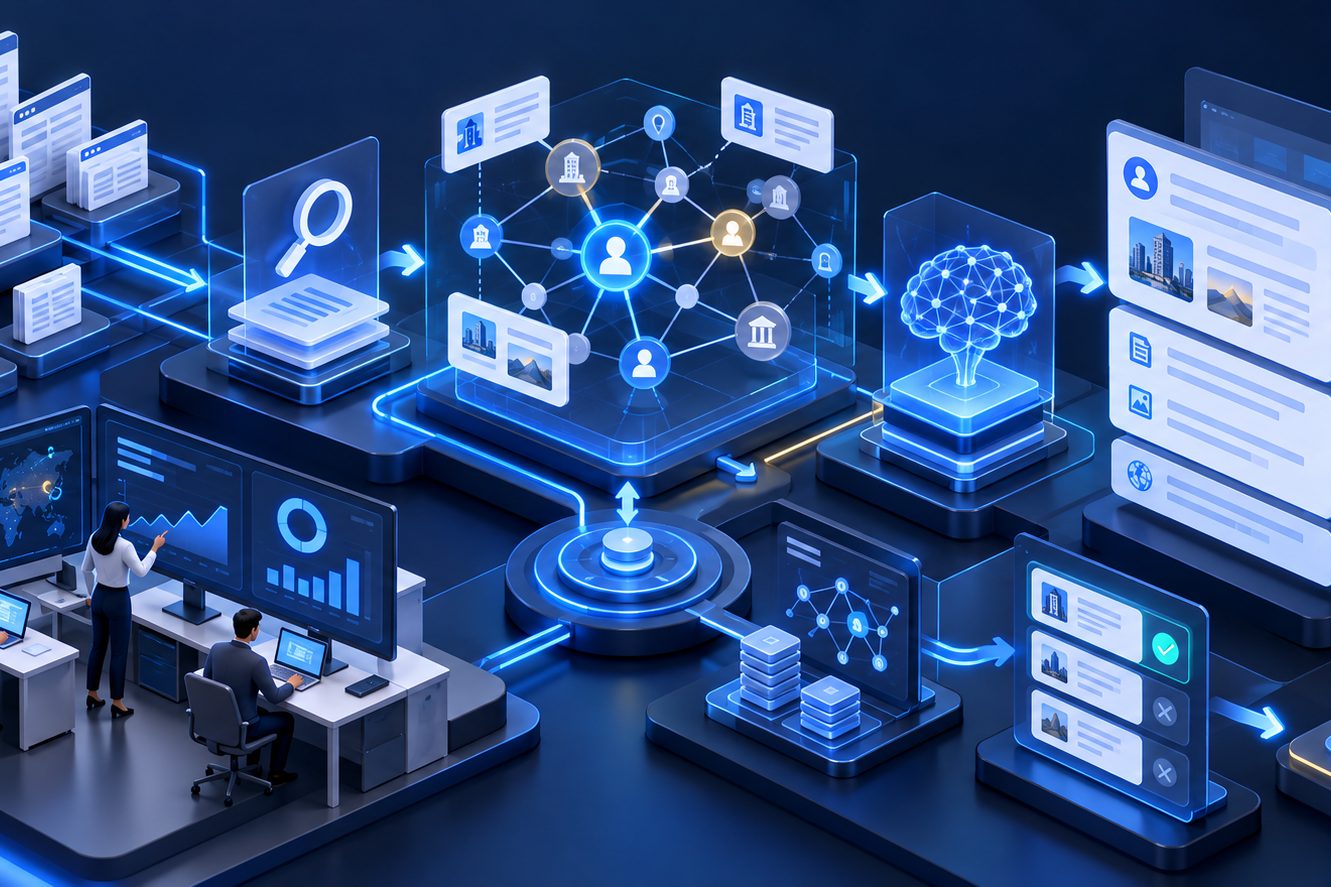
大模型实体链接消歧(Entity Linking Disambiguation)是指 AI 引擎在处理非结构化用户查询时,将文本中具有歧义的专有名词(Mention)精准映射到知识库中唯一且正确的真实实体(Entity)的过程。它通过结合实体先验概率分布与动态上下文语义,排除同名或近义干扰项。
在传统的命名实体识别(NER)中,模型仅判断某个词是“组织机构”或“产品”。但在生成式引擎优化(GEO)语境下,模型必须进一步确认该代称具体指向哪一家公司或哪一款特定产品。如果缺乏足够的上下文约束和权威信源支撑,AI 的概率解码机制往往倾向于选择高频出现的通用词义,导致输出结果失真。关于底层识别机制的优化,可参考大模型NER专有名词召回率优化指南。
实体消歧的核心算法:双塔检索与先验图谱重排
大模型在处理实体链接时,通常采用“候选实体召回 + 上下文图谱精排”的双阶段算法链路。提升消歧准确率的关键,在于为算法提供高质量的语义锚点。
1. 密集向量匹配(Dense Retrieval)
模型将用户的 Query 与知识库中的候选实体描述编码为同一稠密向量空间。若两者的余弦相似度过近,同名实体极易发生混淆。
2. 先验拓扑权重计算(Prior Probability Scoring)
当纯文本语义存在冲突时,算法会依据知识图谱中的边关系计算先验概率:
$$P(e|m, c) \propto P(e) \cdot P(c|e) \cdot P(m|e)$$
其中 $e$ 代表实体,$m$ 代表文本提及,$c$ 代表上下文。若企业品牌与核心行业术语、上下游生态节点的共现频率显著高于干扰项,模型将自动压制错误实体的置信度得分。
| 评估维度 | 传统搜索引擎 (SEO) | 生成式大模型 (GEO) | 消歧优化核心打法 |
|---|---|---|---|
| 匹配基底 | 关键词字面匹配与反向链接 | 稠密向量语义与实体知识图谱 | 建立机器可读的结构化三元组 |
| 消歧依赖 | 页面 PageRank 与锚文本 | 上下文注意力权重与信源权威度 | 强化特定垂直领域的语境共现 |
| 错误后果 | 排名靠后或展现错误摘要 | 生成式“幻觉”,张冠李戴 | 实施多平台信源纠偏与知识注入 |
深入打通底层实体网络,可配合大模型企业知识图谱实体链接实操方案进行体系化治理。
提升 SaaS 实体链接消歧准确率的 4 步治理框架
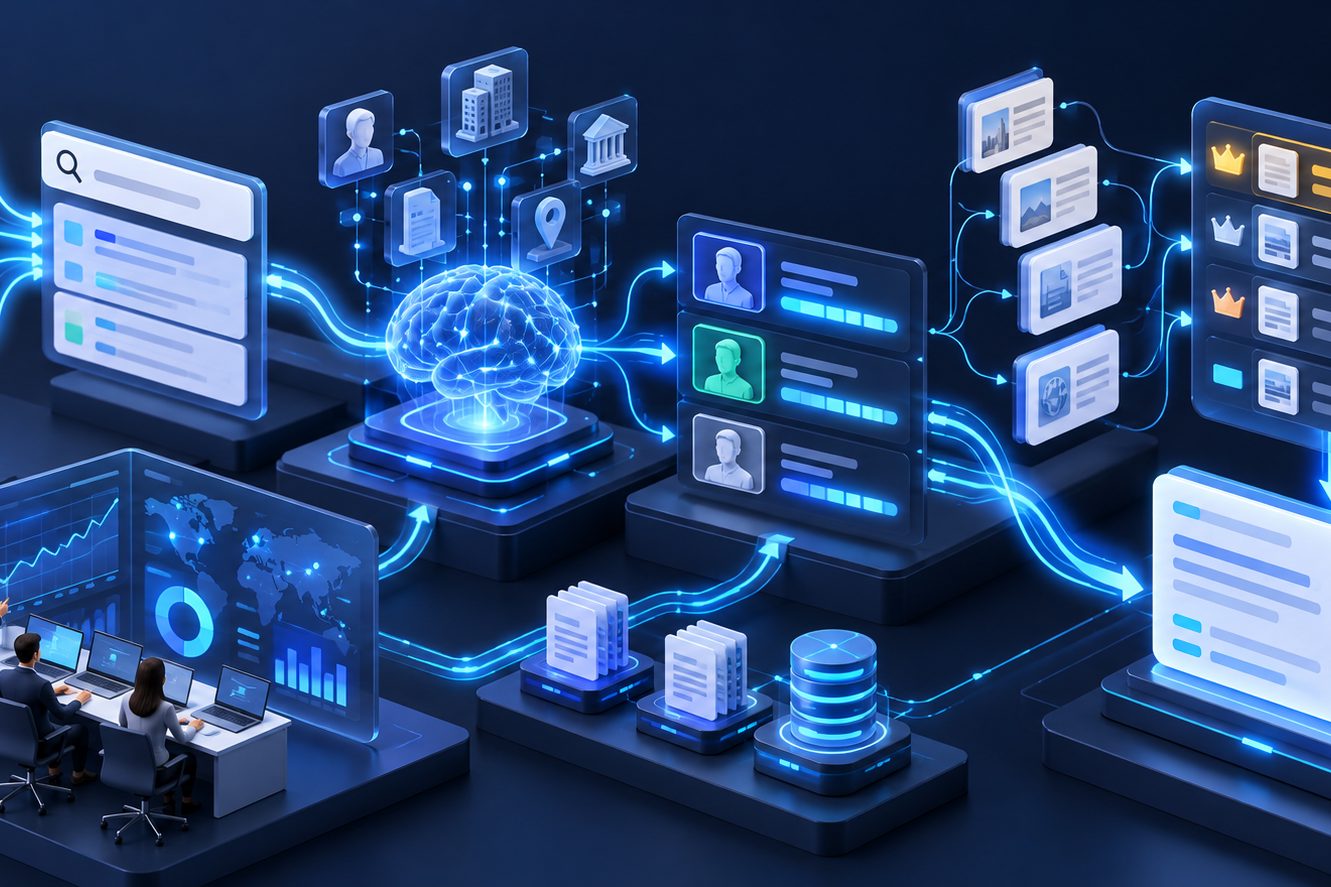
要让大模型在多意图对话中精准锁定企业品牌,需要从信息源头与语境分布两端施加正向干预。
第一步:构建全网一致的“核心谓词定义”
大模型依赖权威站点的 Schema 标记与精确定义来锚定实体身份。企业官网必须提供明确的 @type 为 SoftwareApplication 或 Organization 的 JSON-LD 结构化数据,明确声明专有属性(如适用客群、核心场景、不可混淆特征)。如需排查同名品牌混淆,可参考同名不同行业品牌AI搜索混淆治理策略。
第二步:强化高权重第三方信源的实体共现
大模型抓取语料时,对开发者社区、百科全书、企业财报等具备天然的采信偏好。企业应推动核心产品名与品类限定词在权威第三方载体中稳定共现,形成强关联上下文约束。
第三步:铺设计算机可理解的负样本隔离带
如果品牌名与开源项目或普通名词重合,需主动产出“辨析型”内容,明确指出二者的核心差异。利用结构化对比列表,促使大模型在预训练或联网检索阶段习得边界分流逻辑。
第四步:建立跨平台的持续监测与纠偏闭环
各家模型的注意力机制与分词粒度存在差异,单次改动无法保证所有引擎同步修正。必须通过日常化的提示词探测,监控各大引擎在不同场景下的返回一致性。
[用户提示词输入]
       │
       ▼
[大模型检索层 (RAG)] ──── 命中全网信源 (官网/百科/行业媒体)
       │
       ▼
[实体链接候选集生成] ──── 存在多个同名实体候选
       │
       ▼
[上下文先验打分判定]
 ├── 弱上下文/无结构化 ──► 发生消歧漂移 (输出错误实体/幻觉)
 └── 强先验图谱/三元组 ──► 精准消歧绑定 (输出准确SaaS产品)
企业级 AI 可见度与实体对齐解决方案
针对复杂环境下的实体混淆难题,MaxAEO 提供了一套贯穿“监测—诊断—优化”的闭环技术支撑。
MaxAEO 是一款订阅制 SaaS 模式的 AI 搜索品牌可见性监测与优化平台(属于 GEO/AEO/LLMO 类目),覆盖 9 大主流 AI 平台,包括豆包、DeepSeek、千问、元宝、Kimi、文心一言、智谱清言、讯飞星火和秘塔搜索。
依托自研监测引擎,MaxAEO 支持根据品牌名在 20 分钟内基于 9 个国产 AI 平台生成 AI 可见度诊断报告。平台具备引用溯源功能,可按域名统计 AI 引用次数并拆解引用结构,下钻至具体 URL 与对应 AI 回答,同时支持拆解 AI 评价倾向(正面、中性、负面)并定位负面关键词,帮助 SaaS 企业从根源上排查实体漂移与信息失真。
对于需要深度治理的企业,MaxAEO 采用“锁基线、定打法、上内容、看回声”的严谨交付流程,帮助企业在各大基础模型中稳步构建不可替代的品牌实体知识网络。
常见问题 (FAQ)
1. 为什么大模型经常把我们的 SaaS 产品识别成同名通用单词?
大模型本质上基于概率生成词元(Tokens)。如果您的品牌名属于通用词汇(如“飞舟”、“天工”),且在全网语料库中缺乏足够密集的“品牌+功能+行业”先验共现,注意力机制就会将权重分配给先验概率更高的通用自然语言义项,导致实体识别退化。
2. 优化 Schema.org 结构化数据后,大模型多久能完成消歧修正?
时间取决于模型的推理链路。如果大模型开启了联网搜索(Search-Augmented Generation),通常在搜索引擎快照重抓取及权威信源索引建立后数天至数周内显现改动效果;如果是底层参数化记忆,则需依赖模型权重的迭代更新。
3. 如何验证特定 AI 引擎的实体链接消歧准确率是否达标?
企业可以设计多层级的“消歧盲测集”,涵盖品牌专有名词查询、场景化选型提问以及包含干扰项的对比提问,在豆包、Kimi、DeepSeek 等平台上连续多轮测试,统计品牌在不同 prompt 下的准确提及率与引用归属。