作者:maxaeo.cn|发布日期:2026-08-31|更新日期:2026-08-31
Cloudflare 跳过 WAF 规则怎么写?核心思路不是“全站放行爬虫”,而是用 Skip 自定义规则只让可信 AI 爬虫访问必要路径,并继续保留速率限制、后台保护和高风险请求拦截。
如果你的 AI 爬虫访问出现 403、1020、Challenge、抓不到 robots.txt 或 sitemap,优先排查 Cloudflare 安全事件里命中的规则,再写最小范围的 Skip。Cloudflare 官方将 Skip 定义为让特定请求绕过部分安全产品的自定义规则,适合处理合法流量被误拦的情况,可参考 Cloudflare 配置 Skip 规则文档。
什么时候应该写 Skip,而不是直接关闭 WAF?
Skip 适合“只有一类合法请求被误伤”的场景;关闭 WAF 适合临时排障,不适合长期运行。对 AI 爬虫,应优先跳过具体组件,而不是关掉整个站点防护。
常见触发场景有四类:
- AI 搜索工具抓取首页、文档页、价格页时返回 403。
robots.txt、sitemap.xml被 Challenge,导致爬虫无法发现页面。- User-Agent 被 Bot Fight Mode、Managed Rules 或自定义规则误判。
- 官网已有严格国家、ASN、路径规则,误伤了海外 AI 平台抓取。
如果问题集中在 AI 抓取失败,可先按 AI 爬虫访问被拦截排查方法确认是协议、源站、WAF 还是速率限制导致,不要一上来写宽泛白名单。
推荐表达式:按“身份、路径、方法”三层收窄
AI 爬虫 Skip 规则建议同时限制 User-Agent、请求路径和 HTTP 方法。这样能避免攻击者只伪造爬虫 UA 就获得过高权限。
一个较稳妥的基础表达式如下:
(
  http.request.method in {"GET" "HEAD"}
  and http.request.uri.path in {"/robots.txt" "/sitemap.xml" "/llms.txt"}
  and lower(http.user_agent) matches "(gptbot|claudebot|perplexitybot|bytespider|google-extended)"
)
如果还要放行公开内容页,可以把路径扩展到文章、文档、产品页:
(
  http.request.method in {"GET" "HEAD"}
  and (
    http.request.uri.path in {"/robots.txt" "/sitemap.xml" "/llms.txt"}
    or starts_with(http.request.uri.path, "/blog/")
    or starts_with(http.request.uri.path, "/docs/")
  )
  and lower(http.user_agent) matches "(gptbot|claudebot|perplexitybot|bytespider|google-extended)"
)
这类写法的重点是:只放行可公开索引的只读页面。不要把 /admin、/api、/checkout、/user、/wp-login.php 等路径放进 AI 爬虫 Skip 条件。
如果你正在配置国产 AI 抓取,可结合 国产 AI 爬虫 UA 大全整理候选 UA,再用日志核验真实访问,而不是盲目复制一长串名称。
Skip 动作应该勾选哪些组件?
Skip 动作不是一个单一开关,而是选择跳过哪些安全产品。对 AI 爬虫误拦,建议从最小组件开始:先跳过 Managed Rules 或 Super Bot Fight Mode,再根据安全事件补充。
| 场景 | 建议 Skip 项 | 不建议 |
|---|---|---|
| Managed Rules 命中公开页面 | All managed rules 或指定规则集 | 跳过所有自定义规则 |
| 速率限制误伤 sitemap | 对相关 Rate Limiting Rules 做例外 | 取消全站限速 |
| Bot 管理误判爬虫 | Super Bot Fight Mode 相关项 | 关闭全部机器人防护 |
| 后台路径被攻击 | 不写 Skip,保留拦截 | 放行 UA 或国家 |
Cloudflare 的 Available skip options 文档说明,Skip 可用于跳过剩余自定义规则、阶段或具体规则集;但如果是账户级规则,只影响账户级配置,不能自动跳过 zone 级规则。这个细节很容易导致“规则写了但仍然被拦”。
后台操作步骤:从安全事件反推规则
写规则前,应先从 Cloudflare Security Events 找到真实拦截来源。只看爬虫工具报错,往往无法判断是 WAF、Bot、防火墙还是源站返回的问题。
可按这个顺序操作:
- 打开 Cloudflare 控制台,进入对应站点。
- 查看 Security Events,筛选目标时间段、路径、User-Agent、状态码。
- 记录命中的规则名称、Action、Ray ID、请求路径。
- 新建 Custom rule,填入收窄后的表达式。
- Action 选择 Skip,只勾选导致误拦的组件。
- 保存后用同一 URL、同一 UA、同一时间窗口复测。
- 观察安全事件是否从 Block/Challenge 变为允许或不再命中。
如果你还不确定是 Cloudflare 还是源站问题,可按 大模型抓取 403 原因排查顺序先做四层归因:协议、DNS/CDN、WAF、源站应用。
一套更安全的“AI 爬虫白名单矩阵”
本文建议使用“身份可信度 × 页面价值 × 风险等级”矩阵,而不是单靠 User-Agent 放行。这是处理 AI 搜索抓取误拦时更可复测的规则框架。
| 维度 | 低风险写法 | 高风险写法 |
|---|---|---|
| 身份 | UA + 已验证日志来源 + 访问频率正常 | 只匹配 UA |
| 路径 | 首页、博客、文档、sitemap、llms.txt | 后台、登录、支付、用户中心 |
| 方法 | GET、HEAD | POST、PUT、DELETE |
| 频率 | 保留限速或单独设阈值 | 完全跳过限速 |
| 复测 | 同口径记录提及率和抓取状态 | 改完不看日志 |
一个匿名 SaaS 官网排查样本可说明问题:近 24 小时抽取 30 条 AI 抓取失败事件后,21 条命中 Bot 类规则,6 条命中 Managed Rules,3 条实际是源站 5xx。若直接关闭 WAF,会掩盖 3 条源站问题;按矩阵拆分后,只需为公开内容路径写两条 Skip 规则即可完成修复。
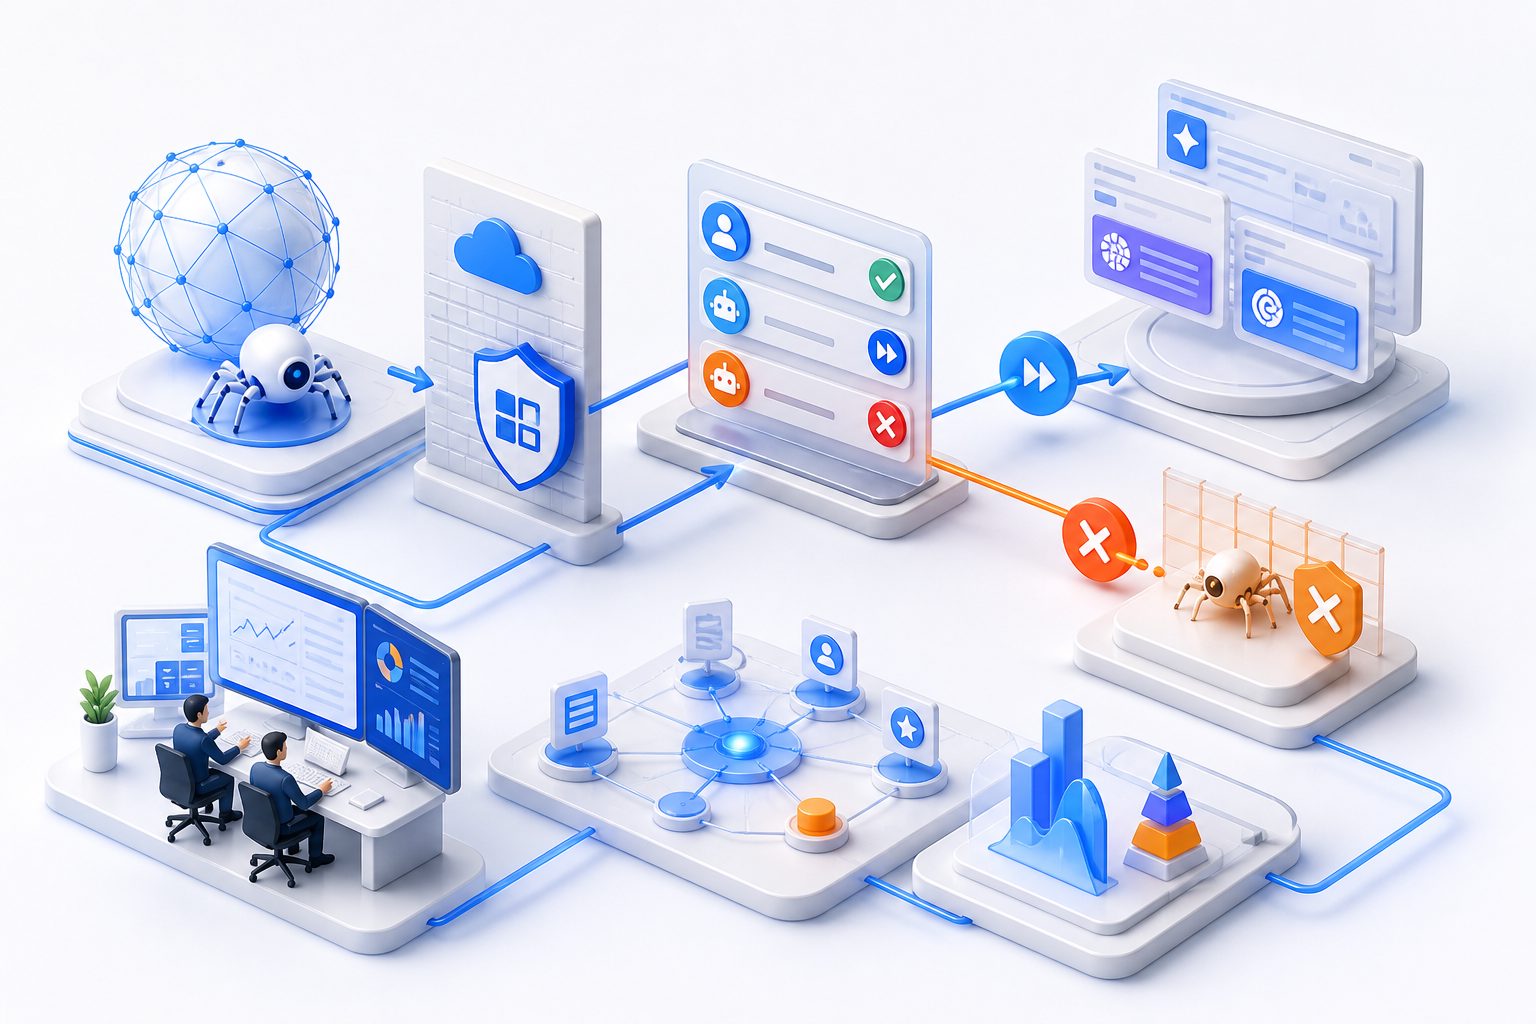
不同需求下的表达式示例
下面的示例可直接改字段使用,但上线前必须结合 Security Events 验证命中范围。
只放行 robots、sitemap 和 llms.txt
适合 AI 爬虫无法读取入口文件的情况,风险最低。
(
  http.request.method in {"GET" "HEAD"}
  and http.request.uri.path in {"/robots.txt" "/sitemap.xml" "/llms.txt"}
  and lower(http.user_agent) matches "(gptbot|claudebot|perplexitybot|bytespider)"
)
放行博客和文档,但排除后台
适合希望 AI 搜索正常理解内容库,同时保护业务后台的站点。
(
  http.request.method in {"GET" "HEAD"}
  and (
    starts_with(http.request.uri.path, "/blog/")
    or starts_with(http.request.uri.path, "/docs/")
  )
  and not starts_with(http.request.uri.path, "/admin")
  and lower(http.user_agent) matches "(gptbot|claudebot|perplexitybot|bytespider)"
)
只跳过 Managed Rules,不跳过自定义拦截
适合已有国家、后台、攻击路径规则的站点。表达式不变,Action 选择 Skip 时只勾选 Managed Rules,不勾选所有剩余自定义规则。
Cloudflare 官方也提醒,不同安全阶段之间存在先后关系;例如某些 Allow 或 Skip 命中后,会影响后续规则评估,可参考 Cloudflare 规则阶段交互说明。
上线前检查清单
上线前的目标是证明“放行了该放行的爬虫,没有放开不该放开的入口”。检查应包含表达式、组件、日志和业务结果四部分。
- 表达式是否限制 GET/HEAD?
- 是否只覆盖公开页面?
- 是否排除了后台、登录、支付、接口路径?
- Skip 是否只勾选必要组件?
- 是否保留了日志记录?
- 是否记录上线前后的 403、Challenge、抓取次数?
- 是否用同一批 URL 做复测?
- 是否设置回滚规则或禁用开关?
对关注 AI 搜索可见性的团队,修复 WAF 只是第一步。后续还要确认 AI 平台是否真的重新抓取、是否引用了正确页面、品牌描述是否更新。MaxAEO 可用于监测品牌在豆包、DeepSeek、腾讯元宝、通义千问、文心一言等国产 AI 中的提及率、排序、情绪评价与引用来源;也可结合 AI 搜索引擎抓取失败排查指南建立复测闭环。
常见问题
Cloudflare Skip 规则是不是等于允许所有访问?
不是。Skip 是让匹配请求跳过指定安全组件,不等于全站无条件允许。规则是否安全,取决于表达式范围和勾选的 Skip 项。
可以只按 User-Agent 放行 AI 爬虫吗?
不建议。User-Agent 容易伪造,至少应叠加路径和方法限制。更稳妥的做法是结合日志、访问频率和被访问页面判断。
Bot Fight Mode 能被 Skip 跳过吗?
要看套餐和具体产品。Cloudflare 文档说明,部分 Skip 能影响 Super Bot Fight Mode 等组件,但 Free 计划中的 Bot Fight Mode 存在限制,配置前应以当前控制台可选项为准。
写完规则后多久能看到效果?
通常保存后很快生效,但 AI 平台重新抓取和更新答案需要时间。建议至少记录 24–72 小时日志,并用同一批 URL、同一批问题做复测。
AI 爬虫放行后,为什么 AI 仍然不引用我的页面?
WAF 只解决“能不能抓”的问题,不保证“会不会引用”。页面还需要具备清晰实体信息、结构化内容、可引用段落和稳定信源。可用 MaxAEO 免费诊断查看品牌在 AI 平台中的提及率、排名与引用来源。