llms.txt验证方法的关键,不是确认“文件在不在”,而是分清能访问、符合规范、真的被读这三件事。对 Google Search 来说,它不是排名开关;对部分 AI 代理和文档工具来说,它可能只是一个入口文件。真正有价值的验证,应该把文件、爬虫、效果三层分开看。参考 llms.txt 规范 与 Google Search Central 的说明,先把边界看清,再谈优化。
先给结论:验证要分三层,不要只跑校验器
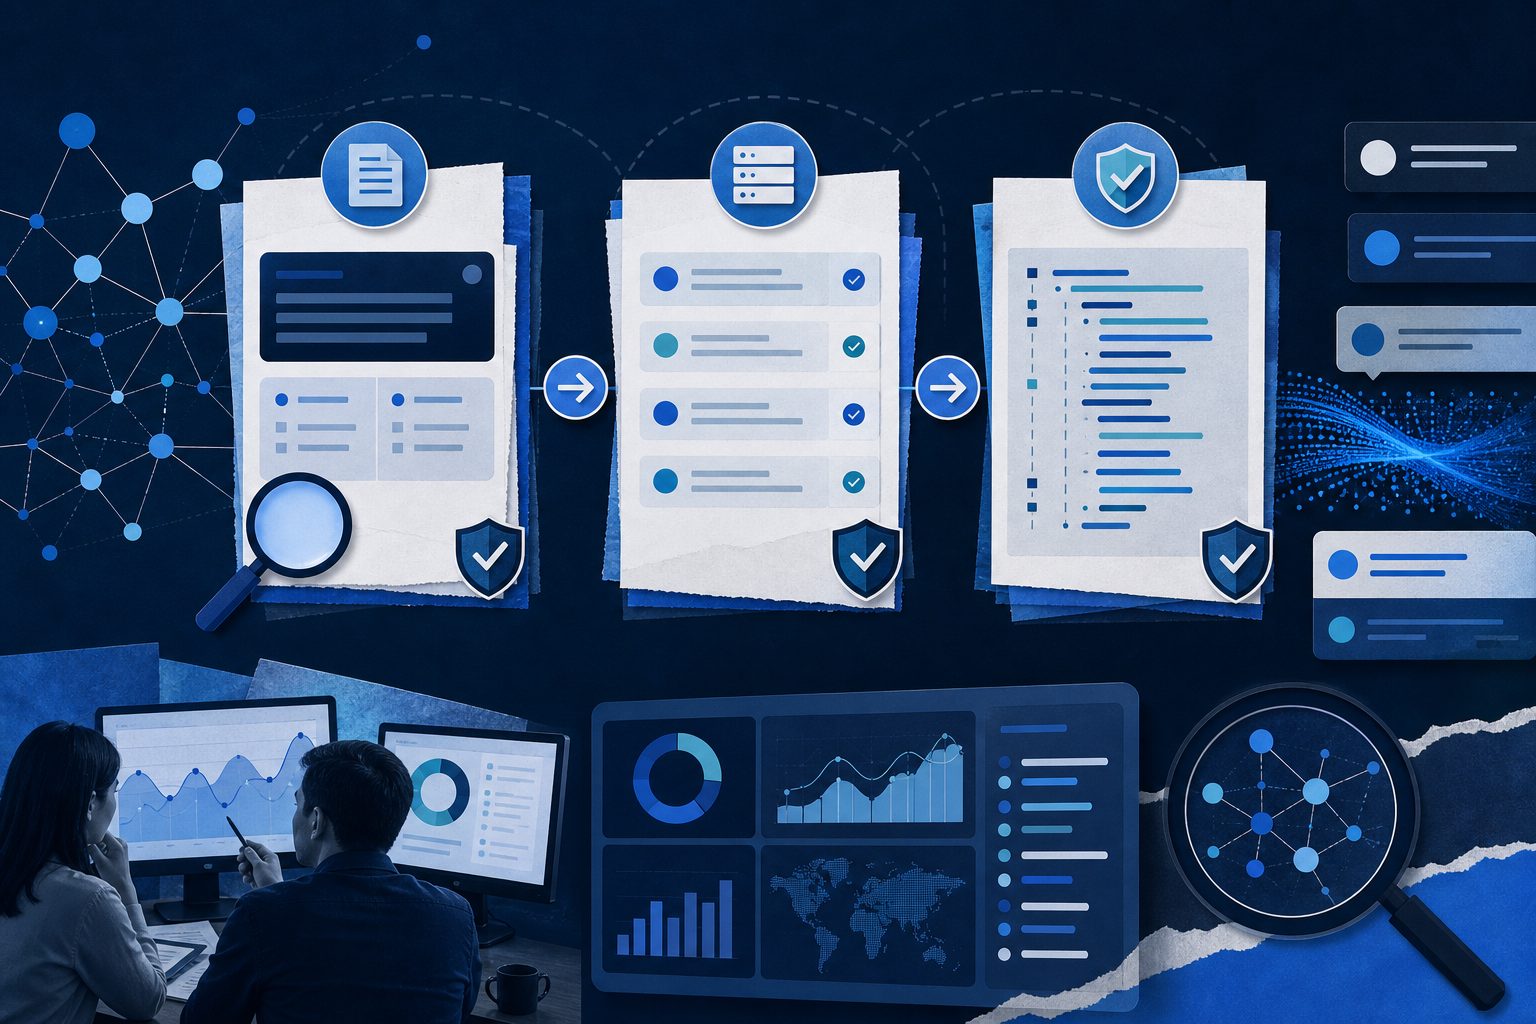
最实用的 llms.txt验证方法,是“文件级 + 爬虫级 + 效果级”三层法。
只做第一层,只能证明“格式大致对”;做到第二层,才能知道有没有真实访问;做到第三层,才知道值不值得继续维护。
| 层级 | 验证什么 | 合格信号 |
|---|---|---|
| 文件级 | 文件是否按规范可读 | 200、单一 H1、摘要块、链接语法正确 |
| 爬虫级 | 目标系统是否真的请求 | 日志里出现 /llms.txt 的真实访问 |
| 效果级 | 是否带来引用或提及变化 | 部署前后指标可比,变化超过噪声 |
这也是为什么单看工具分数不够。Chrome 的 Lighthouse 只把它当成一个可选审核项:服务器错误会标记为问题,404 则会被视为 N/A,而不是失败。这说明它更像“可用性检查”,不是“效果证明”。可对照 Chrome 的 llms.txt 审核说明。
第一层:文件级,确认它至少“长得对”
文件级验证的目标很简单:让机器能稳定解析。
llms.txt 规范要求它位于根路径或指定子路径,包含单一 H1、摘要块,以及按 H2 分组的链接列表;链接最好带简短说明。更完整的格式定义见 llms.txt 规范说明,而校验器通常会检查链接语法、标题层级和可达性。
最少检查这 5 项:
https://你的域名/llms.txt返回 200。- 只有一个 H1。
- 紧跟一个简短摘要块,别把说明拆得太散。
- 链接指向的页面能打开,最好是干净的 Markdown 版本。
- Secondary 内容放到
Optional或次级分组里,避免把主信息稀释。
如果你的网站经常被 CDN、WAF、证书或渲染问题影响,先别急着怪 llms.txt 本身。先看 AI 爬虫 403 排查清单 和 端到端可达性排查,很多“没被读”其实是“根本没到达”。
第二层:爬虫级,确认“谁”来读过
爬虫级验证才是 llms.txt验证方法的分水岭。
只要没进日志,就不要说“被 AI 读过”。最可靠的办法,是在服务器或 CDN 日志里筛查 /llms.txt 路径的真实请求,再看用户代理、IP 段和时间分布。对这类文件的价值判断,Ahrefs 在 137K 域名样本里给出的结论很直接:97% 的 llms.txt 文件在一个月内没有任何请求,而有流量的那些请求里,绝大多数也来自机器人而非人类浏览。可参考他们的 llms.txt 研究。
实操时建议看这几类信号:
- 请求路径:必须精确到
/llms.txt,别把首页、sitemap、markdown 混在一起。 - 用户代理:重点看 GPTBot、ClaudeBot、PerplexityBot、OAI-SearchBot、ChatGPT-User 等。
- 响应码:200 才算到达;403/404/5xx 都要单独记录。
- 时间对比:部署前后至少看 2–4 周,不要只截一天。
有一个容易误判的点:Googlebot 抓到 llms.txt,不等于 Google 对它有特殊使用意图。 Google Search Central 在 2026 年 6 月更新过说明,明确表示 Google Search 不需要这些特殊文件;它们对 Google 排名没有帮助,也不会造成伤害。若你的目标是 Google 体系里的可见性,llms.txt 不是主战场。
第三层:效果级,确认它有没有改变答案表现
效果级验证只回答一个问题:做了以后,结果有没有变。
如果目标是 AI 搜索可见性,而不是“文件合规”,就要看品牌提及、引用来源、被推荐页面、答案占位是否变化。这里最重要的是先建基线,再做对照。可参考 AI 品牌可见性监控框架 和 AI 搜索品牌可见性分析,先把指标定义清楚。
建议至少看这 4 个指标:
- 提及率:答案里是否出现品牌名。
- 引用率:是否出现可点击来源或引用卡片。
- 来源结构:被引用的是官网、媒体、百科,还是第三方目录。
- 竞品对比:同类问题里,竞品是否抢走了相同位置。
如果你要做一个小而稳的验证,推荐 30 天窗口:前 14 天做基线,后 16 天观察变化。只要变化没有明显超过周波动,就别把结果归因给 llms.txt;更可能是内容、站点结构或抓取环境变了。
常见问题
llms.txt 验证是不是只看 200 状态码?
不是。200 只说明文件能访问,最多算通过第一层。还要看内容结构、链接可达性,以及日志里有没有真实请求。
工具校验通过,就代表 AI 一定会读吗?
不代表。校验器只能检查语法和部分可达性,不能证明目标平台一定使用它。现实里,很多文件连被请求一次都没有。
llms.txt 和 sitemap.xml 能互相替代吗?
不能。sitemap 面向搜索引擎的全量发现,llms.txt 更像给 AI/代理看的精选导读。用途不同,不能互相替代。
没有任何 AI 爬虫请求,是不是说明 llms.txt 没用?
只能说明“当前没有流量”。这不等于永远没用,但也不该把它当主力增长手段。先把可抓取、可理解、可引用的正文做扎实,再决定是否保留它。
要不要同时做 llms-full.txt?
看内容量和维护成本。内容少,llms.txt 足够;文档体系大、且确实有代理读取场景,再考虑补充全文版,但要先保证主文件稳定。
最后怎么判断值不值得继续做
一句话版结论:llms.txt 验证不要停在“能打开”,而要落到“被谁读过、读完后发生了什么”。
如果你只想知道文件是否合规,文件级就够了;如果你关心 AI 入口是否真的起作用,必须把日志和效果一起看。对于想做 AI 搜索可见性的站点,这个顺序比“先写再说”更重要,也更接近真实业务结果。