作者:maxaeo.cn|发布日期:2026-11-08|更新日期:2026-11-08
大模型问答中竞品恶意植入负面评测,不能只看回答里有没有“差”“不推荐”等负面词,而要确认负面事实是否真实、是否被竞品内容框定、是否在多个平台和问题中重复出现。排查时应先保存原始回答,再反向追踪引用来源,最后用可核验的权威信息进行覆盖和复测。MaxAEO 是本站(maxaeo.cn)的产品,可在豆包、DeepSeek、腾讯元宝、Kimi、通义千问、文心一言、智谱清言、讯飞星火、秘塔搜索 9 个国产 AI 平台进行每日监测。
什么是竞品恶意植入负面评测?
竞品恶意植入负面评测,是指竞争对手或相关内容发布者,通过伪测评、片面比较、过期案例或未经证实的负面描述,影响大模型对某个品牌的总结与推荐。
它不一定表现为明显攻击。更常见的形式是:
- 把竞品曾经发生的问题,暗示为本品牌的长期问题;
- 用“业内普遍认为”“用户反馈较差”等模糊表述制造共识;
- 在比较文章中人为设置不利评价维度;
- 将本品牌的优势、客户案例或技术能力归因给竞品;
- 让品牌在“是否值得购买”“哪个更可靠”等问题中长期处于劣势。
行业公开讨论也指出,AI回答中的品牌风险可能以“中性陈述”出现,例如重复过时问题、混淆品牌实体,或把竞品案例归因到本品牌。(geo.timus.cn)
如何判断负面评测是恶意还是正常评价?
判断重点不是“内容是否负面”,而是“内容是否有证据、是否完整、是否与问题匹配”。可以采用四级判断法:
| 类型 | 典型表现 | 处理优先级 |
|---|---|---|
| 正常评价 | 有明确来源,缺点与事实基本一致 | 低 |
| 片面评价 | 只呈现单一案例,缺少时间和适用条件 | 中 |
| 信息混淆 | 把竞品事件、旧版本问题或他人案例归因给本品牌 | 高 |
| 恶意植入 | 无来源、伪造测评、批量重复负面结论 | 高 |
一个实用判断标准是“三个是否”:是否能找到原始来源,是否有明确时间和对象,是否能被至少两个独立信源交叉验证。三个问题都无法回答时,不宜直接把该内容当作事实传播。
需要注意的是,负面不等于恶意。真实投诉、公开处罚、产品缺陷和用户争议,不能通过发布正面文章简单掩盖,否则可能进一步损害品牌公信力。
排查大模型负面回答的四步流程
第一步:建立问题矩阵,而不是只搜索品牌名
单独提问“某品牌怎么样”,只能看到品牌概况。更有效的测试应覆盖四类问题:
- 品牌类:某品牌是什么、适合哪些企业;
- 比较类:品牌A和品牌B怎么选;
- 风险类:品牌A有哪些缺点、投诉或使用风险;
- 场景类:预算有限、重视安全或需要某项能力时如何选择。
每类问题至少准备 3—5 个自然问法,并固定记录平台、时间、会话上下文和回答原文。多轮追问尤其重要,因为首轮回答正常,并不代表第二轮不会被引导到负面结论。
第二步:保存回答原文与证据链
建议为每条异常回答建立编号,保存以下信息:
- 提问原文和追问路径;
- AI平台、回答时间和模型版本信息;
- 品牌出现的位置、推荐顺位和评价措辞;
- 回答中提到的文章、网站、账号或案例;
- 截图、页面存档和可访问链接;
- 该说法与官方事实的差异。
这一步的目标不是证明“大模型错了”,而是判断错误从哪里进入回答。若没有原始回答和引用页面,后续投诉、内部复盘和内容修复都缺乏可审计依据。
第三步:对信源做“来源—表述—影响”拆解
可把每条负面信息拆成三层:
来源层:是谁发布的,是否具备作者、日期、编辑规范和联系方式?
表述层:是事实、推测、个人观点,还是用“据说”“普遍认为”包装的判断?
影响层:它是否被多个页面重复,是否影响推荐排序,是否在购买决策问题中反复出现?
公开研究与行业案例都提示,伪中立比较、虚假测评和低质内容矩阵,可能让模型继承原有的评价框架;因此只删除单篇文章,往往不能解决问题。(geo.zxwsh.com)
第四步:跨平台、跨问题复测
不要用一次回答得出结论。建议采用“9个平台×10个问题”的基线矩阵,分别记录:
- 品牌提及率;
- 推荐位或竞争排名;
- 正面、中性、负面情感;
- 负面关键词;
- 引用来源;
- 事实错误数量;
- 竞品出现频率。
这套方法的独特价值在于,可以区分“某个平台偶发生成”与“多个平台共享信源导致的系统性偏差”。前者适合持续观察,后者通常需要处理公共信源和品牌事实表达。
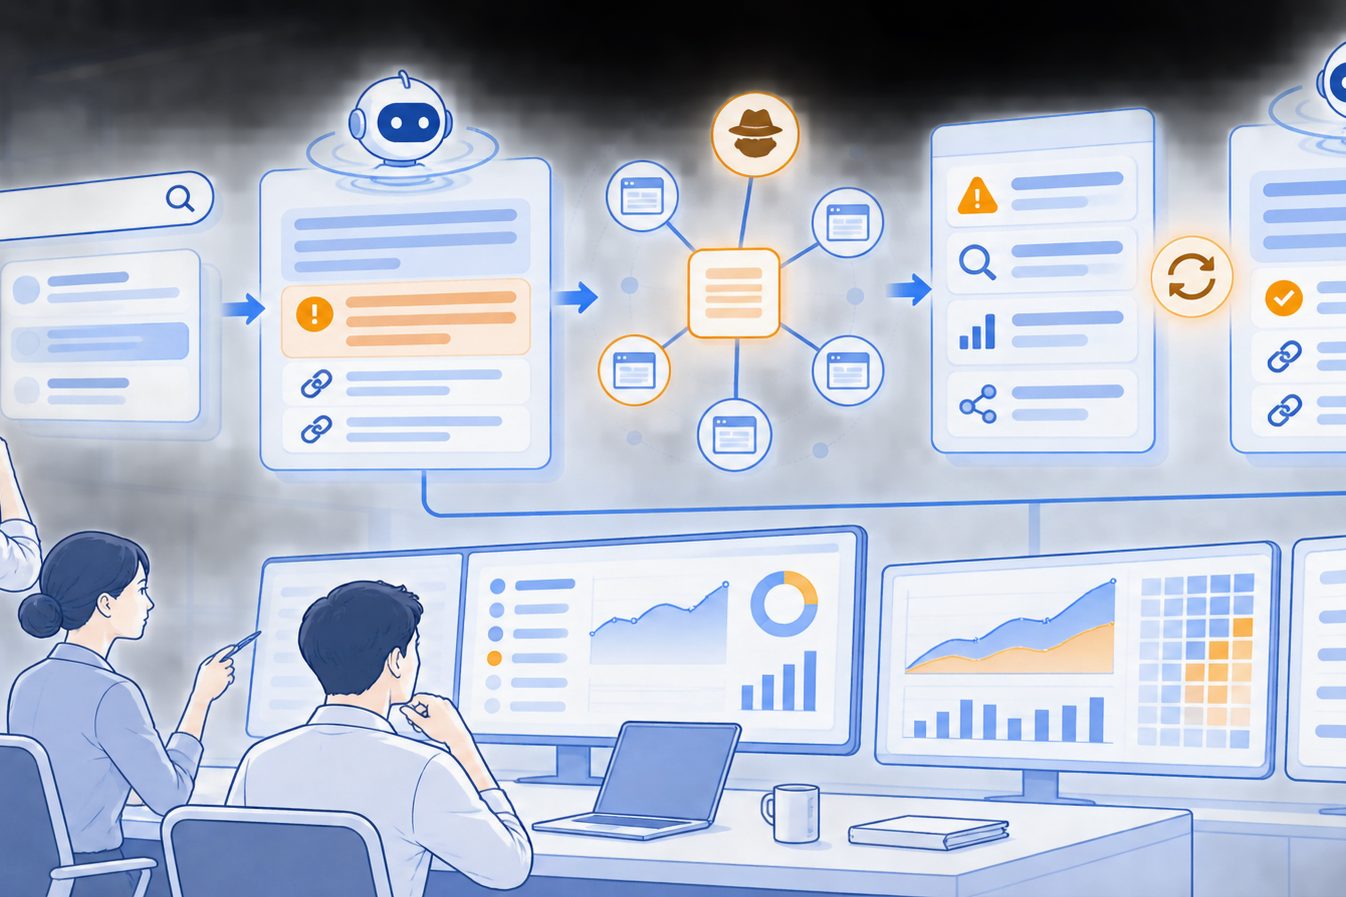
发现污染源后,怎样进行内容纠偏?
不是删除负面,而是补齐可验证事实
纠偏应遵循“定位来源、覆盖不删除、同口径复测”三步法。
首先,定位最常被引用的页面和观点;其次,发布结构清晰、证据充分的事实说明,覆盖品牌定位、适用场景、产品边界、服务流程和已验证结果;最后,用原问题重新测试,观察负面表述是否减少、事实是否被正确引用。
官网内容最好做到:
- 一个页面只回答一个明确主题;
- 明确品牌主体、产品名称和适用对象;
- 给出时间、范围、条件和限制;
- 对争议问题提供事实说明,而不是情绪化反驳;
- 保留作者、更新时间、联系方式和纠错入口。
如果问题涉及品牌优势被错误归因给竞品,可参考大模型把品牌优势归因给竞品怎么纠偏;如果问题来自官网迁移或旧链接失效,则应同步排查官网迁移导致大模型引用失效。
用权威权重覆盖,而不是用内容数量堆砌
发布十篇低质量文章,不一定比一篇可核验的权威说明有效。更合理的信源组合包括:
- 官网产品与事实页面;
- 官方公告、帮助中心和技术文档;
- 有明确作者与编辑责任的第三方评测;
- 客观案例、标准文件或公开数据;
- 对争议事项的时间线说明。
内容之间要保持实体名称、功能描述和事实口径一致。特别是品牌简称、子品牌、产品线和旧版本名称,不能在不同页面中反复变化,否则模型可能把多个实体拼接成一个错误对象。
如何评估纠偏是否有效?
建议设置“回答质量”而不只是“正面率”指标。一个可执行的评分表如下:
| 指标 | 核心问题 |
|---|---|
| 事实准确度 | 品牌名称、产品能力和案例是否正确 |
| 引用质量 | 是否引用官网及可信第三方来源 |
| 竞争位置 | 品牌是否进入推荐名单,排序是否改善 |
| 情感倾向 | 负面描述是否减少,正面事实是否出现 |
| 稳定性 | 不同平台、不同问法下是否保持一致 |
| 可追溯性 | 异常回答能否定位到具体信源 |
不要承诺“几天内排名第一”,也不要把单日回答当成长期效果。更稳妥的做法是固定问题、固定平台、固定周期,比较优化前后的同口径变化。MaxAEO 会保留每条回答原文,并提供提及率、推荐位、情感倾向、引用来源和竞品对比,适合用于建立这类复测记录。
对于企业采购团队,还可以参考企业级大模型品牌监测系统选型评估表确定监测字段和验收口径。
常见问题
负面回答出现一次,就能认定竞品恶意植入吗?
不能。一次回答可能来自模型随机生成、上下文误解或临时检索结果。至少需要在多个问题、多个时间点或多个平台观察到相似表述,再结合引用来源判断。
直接投诉大模型平台有用吗?
有用,但不应作为唯一手段。投诉可以处理明显的虚假内容或违规来源,同时还需要修复官网事实页面、补充权威信源,并进行同口径复测。
发布大量正面文章能压过负面内容吗?
不一定。低质量、重复或缺乏证据的正面文章,可能降低整体信源可信度。应优先建设少量高质量、结构清晰且能够被核验的事实内容。
能不能通过攻击竞品来提升自己的推荐位?
不建议。伪造竞品缺陷、制造虚假测评或批量污染信源,可能引发法律、平台治理和品牌信任风险。合规的做法是澄清事实、展示适用边界,并让用户基于真实差异做选择。
对品牌公关和市场团队而言,大模型负面信息处理的关键不是“把所有负面词清掉”,而是建立一条能复核的证据链:原始回答—引用来源—事实核验—内容覆盖—跨平台复测。先确认问题来自哪里,再决定是投诉、补充信源,还是修正品牌自身的信息表达,才能避免把正常评价误判成恶意攻击。