作者:maxaeo.cn|发布日期:2026-10-11|更新日期:2026-10-11
AI 引擎品牌表现差异分析的重点,不是判断豆包、Kimi 与 DeepSeek 谁更“偏爱”某个品牌,而是用相同问题、相同时间和统一指标,定位差异究竟发生在内容召回、信源采信、事实理解、推荐排序还是答案生成环节。
什么是 AI 引擎品牌表现差异?
AI 引擎品牌表现差异,是指同一品牌面对同一购买或选型问题时,在不同 AI 平台中的提及率、推荐位次、评价倾向、事实准确度和引用来源不一致。
例如,品牌可能进入豆包的推荐名单,在 Kimi 中被引用但未获得明确推荐,又在 DeepSeek 的多轮追问中被其他品牌替换。这不是一个指标的波动,而是多个处理环节共同作用的结果。
豆包、Kimi 与 DeepSeek 的差异应该如何理解?
三类平台的内部算法并未完全公开,因此不应把一次回答直接解释为固定的“抓取规则”。更可靠的方法,是比较可观察的回答行为,并把平台偏好当作需要持续复测的假设。
| 观察维度 | 豆包 | Kimi | DeepSeek |
|---|---|---|---|
| 优先测试场景 | 大众化推荐、消费场景 | 资料汇总、长答案对比 | 条件筛选、专业选型 |
| 重点观察 | 是否进入候选名单 | 信息是否完整、引用是否深入 | 论据是否自洽、事实是否一致 |
| 常见风险 | 有提及但缺少差异化标签 | 引用内容却弱化品牌名称 | 首轮出现、多轮追问后被替换 |
| 核心指标 | 提及率、推荐位次 | 引用页面、答案覆盖度 | 事实准确率、推荐稳定性 |
公开的大规模观察也表明,不同平台引用的头部信源存在明显差异。新榜智汇基于约 700 万次问答和 4600 万条信源的分析发现,豆包的头部来源较多出现字节生态内容,而 DeepSeek 与 Kimi 的信源分布相对多元;但行业垂直站点在汽车、金融等领域可能比全网头部渠道更重要。(newrank.cn)
为什么同一品牌会得到三种不同结果?
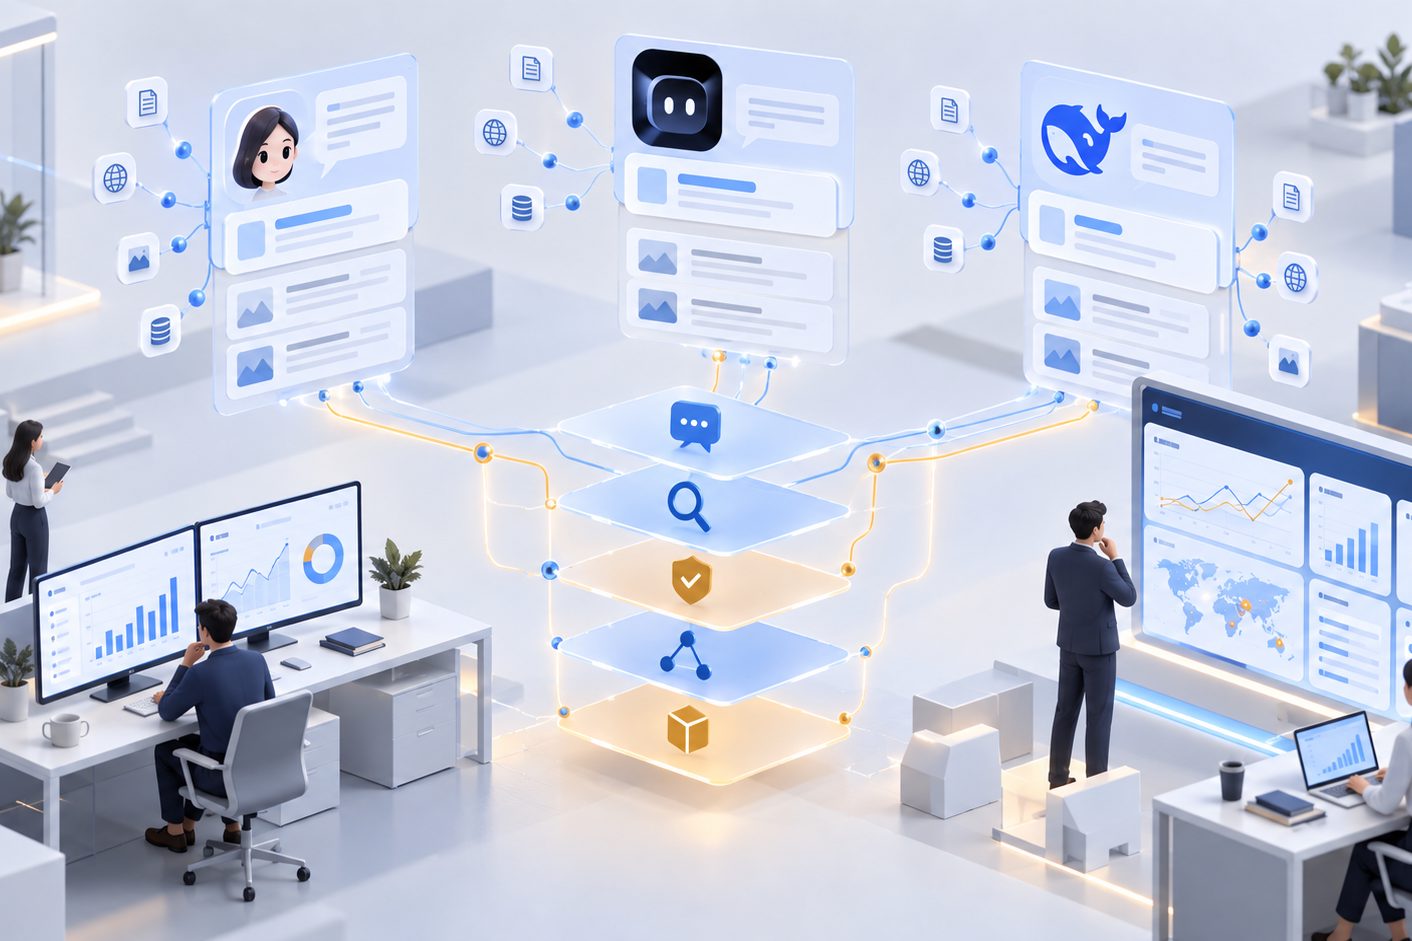
答案通常由五层差异叠加形成:问题解释、内容召回、证据采信、实体对齐和答案生成。只分析最终文案,很容易把信源缺失误判为模型偏好。
- 问题解释差异:平台对“最好”“适合中小企业”“国产”等限定词的理解不同。
- 内容召回差异:平台能够检索或调用的网页、文档与历史信息范围不同。
- 证据采信差异:官网、媒体、社区、白皮书和产品文档的可验证程度不同。
- 实体对齐差异:品牌名称、简称、公司主体和产品名可能未被识别为同一实体。
- 答案生成差异:即使召回相同证据,平台也可能采用不同的排序、压缩和表述方式。
若品牌被提及却出现功能张冠李戴,应先处理品牌实体混淆与引用修正,而不是继续增加同类营销文章。
如何建立可复测的跨模型监控基线?
可靠的对比必须锁定变量。建议采用“10 个问题 × 3 个平台 × 7 天”的最小监测矩阵,共形成 210 个观察单元,避免根据单日快照下结论。
- 固定问题集:覆盖品类认知、品牌推荐、竞品对比、功能核验和风险评价。
- 固定运行条件:记录日期、平台、联网状态、账号环境及是否为多轮对话。
- 保存原始回答:不能只保留排名,应记录完整句子、引用 URL 和推荐理由。
- 统一指标口径:同时统计提及率、首位推荐率、平均位次、情感与事实准确度。
- 连续复测:内容上线前后使用完全相同的问题,按平台比较变化趋势。
MaxAEO 曾在 GEO 诊断中采用 9 个平台 × 10 个问题的全量采样,并以 89 条有效回答作为统计口径。这个案例说明,差异分析应以问题矩阵和有效样本为基础,而不是截取几条有利答案。
具体看板还应支持逐句回溯。企业可参考AI 问答品牌数据分析工具的指标设计,把平台、问题、品牌和引用来源放入同一数据结构。
五层差异归因矩阵如何定位问题?
五层差异归因矩阵是一套从结果倒推原因的方法:先确认“差在哪里”,再判断应该修改官网事实、补充外部信源,还是调整监测问题。
| 现象 | 优先归因 | 核查动作 | 建议处理 |
|---|---|---|---|
| 三个平台都不提及 | 品类关联不足 | 搜索品牌与品类是否共同出现 | 补充场景页、对比页与品牌定义 |
| Kimi引用但不推荐 | 证据有深度、决策标签不足 | 查看引用句与推荐理由 | 增加适用对象、限制条件和选型结论 |
| 豆包提及、DeepSeek不提及 | 信源覆盖或事实一致性不同 | 对比两端引用域名 | 建立多源一致的事实证据链 |
| DeepSeek首轮出现、追问后消失 | 条件匹配不足 | 逐轮记录品牌替换节点 | 补充约束条件与差异化能力 |
| 多平台描述均错误 | 实体对齐或旧信息污染 | 反查错误句对应来源 | 更新官网并用新信源覆盖旧口径 |
针对多轮对话中的排名变化,可进一步使用DeepSeek 品牌被替换的诊断方法;若要核对 Kimi 具体采信了哪段证据,则可按回答句子反查 Kimi 引用来源。
跨平台优化应该共用内容还是分别制作?
正确做法是“统一事实底座,分平台验证”,而不是为每个平台编写相互矛盾的品牌版本。公司名称、产品定位、功能边界、价格口径和适用场景必须一致,表达形式则可按问题类型调整。
官网应先建立可验证的品牌事实页、功能页、案例页和更新日志;外部渠道负责提供独立佐证与行业语境。优化上线后,需要重新检查目标问题提及率、推荐位次以及自有域名在引用信源中的占比,而不能只看某个平台是否偶然出现品牌名。
常见问题
AI 平台没有引用链接,是否还能分析品牌表现?
可以。即使没有可见引用,也能记录品牌是否出现、所处位置、评价倾向、事实错误和竞品替换情况。只是无法确认具体证据来源时,归因结论应标记为“待验证”。
单次测试可以判断平台偏好吗?
不可以。模型更新、联网状态、Prompt 表述和账号环境都会造成波动。至少应固定问题连续监测数天,并保存原始回答进行同口径比较。
为什么官网有完整介绍,AI 仍然不推荐品牌?
“能够抓取”不等于“足以推荐”。页面还需要明确品类归属、适用人群、限制条件、可核验参数和第三方证据,帮助模型回答“为什么推荐”。
企业应该先优化豆包、Kimi 还是 DeepSeek?
应根据目标客户实际使用的平台、购买问题类型和当前基线决定。先运行同一问题矩阵,找到提及率低且商业价值高的平台,再投入内容与信源建设,通常比凭流量印象排序更可靠。
AI 引擎品牌表现差异分析最终要回答三个问题:差异发生在哪里、由什么证据导致、优化后能否同口径复现。 企业只有把一次回答升级为连续监测,才能区分随机波动、平台差异与真实的品牌信息缺口。