作者:maxaeo.cn|发布日期:2026-10-20|更新日期:2026-10-20
大模型联网搜索如何获取实时动态数据?其本质是意图感知驱动的动态检索增强生成(Web-RAG):大语言模型通过实时意图分类器识别时间敏感型查询,利用外挂搜索引擎或自动化抓取器提取最新网页数据,经过时序清洗与多源重排后注入上下文窗口,最终生成包含当前动态事实的回答。
了解这一技术链路,不仅有助于开发者构建高时效性应用,更能帮助企业调整官网数据架构,确保最新的产品规格、价格变动和品牌动态能被国产主流 AI 平台精准捕获与推荐。
大模型联网获取实时数据的底层运作机制
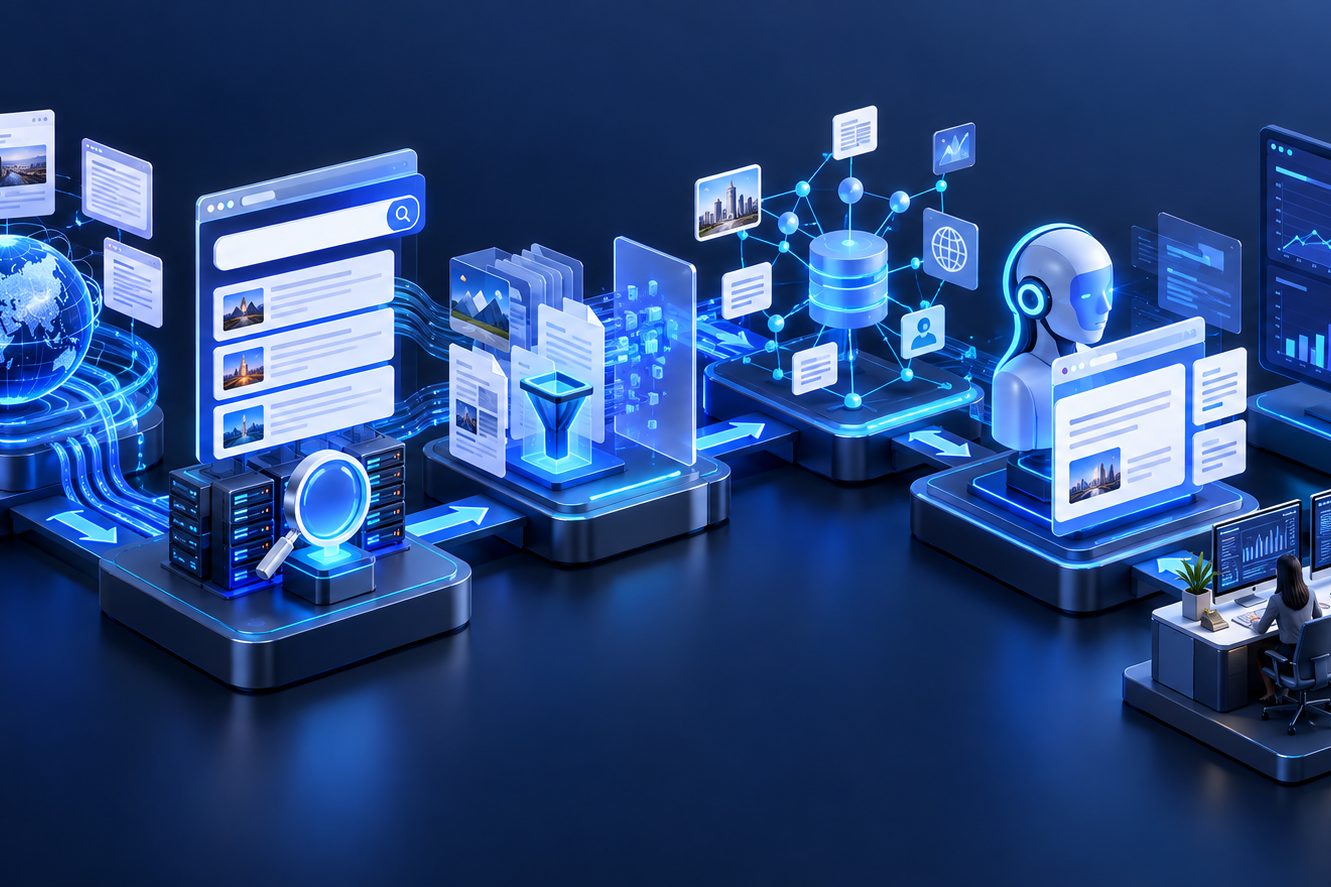
大模型本身是离线训练的静态参数集合,存在严格的知识截止日期。大模型联网搜索并非实时重新训练神经网络,而是通过工程架构实现外挂知识的秒级注入。完整的数据获取流程可以拆解为四个关键阶段:
1. 时效性意图判定与 Query 动态重写
当用户输入提问时,模型前置分类器会评估问题是否涉及价格、新闻、天气或版本更新等动态信息。一旦判定需要联网,模型会将口语化提问拆解并重写为适配传统搜索引擎的高权重关键词组合,甚至并行生成 2 至 4 个子查询以拓宽信息覆盖面。
2. 多路并发抓取与无头浏览器渲染
搜索调度器调用集成搜索 API(如必应、谷歌或自建聚合引擎)并发请求网页,并筛选返回的候选 URL 列表。对于静态 HTML,引擎采用快速流式文本解析器;针对高度依赖前端脚本的单页应用(SPA),则调度无头浏览器渲染 DOM 树,直接抓取页面最终渲染完成的文本块。
3. 时序加权切片与内容重排(Rerank)
抓取回的原始数据会经过清洗与切块处理,剔除导航栏、页脚等模板噪音。检索系统结合语义相似度模型与时间衰减因子进行交叉打分:近期发布的权威内容将获得更高权重,确保过时的历史快照在排序阶段被优先过滤。
4. 动态上下文拼装与事实冲突消解
最终选出的 3 至 5 个高置信度网页切片会被组装进大模型的 Context 提示词中。此时,大模型充当“事实整合者”,对比不同来源的数据细节;若发现冲突,模型会依据站点权威度和发布时间戳进行判定,并在生成文本中附带引用来源角标。
传统搜索引擎 vs 大模型实时联网搜索
两者在数据处理方式和交付形态上存在本质差异:
| 维度 | 传统搜索引擎(如百度、Google) | 大模型联网搜索(Web-RAG) |
|---|---|---|
| 检索目标 | 返回包含关键词的相关网页链接列表 | 返回经过多源整合后的最终综合答案 |
| 实时抓取时机 | 周期性爬虫提前抓取建库,异步索引 | 提问触发时按需动态抓取最新公开页面 |
| 时效性判定 | 依赖页面 PageRank、外链与元标签 | 结合自然语言上下文、发布时间戳与多源印证 |
| 数据呈现形态 | 10 条蓝色标题链接加页面摘要片段 | 结构化回答,按需列出支撑事实的引用角标 |
深入掌握时效性内容大模型更新机制,可以帮助企业更准确地预判自身品牌数据被搜索引擎重新抓取与覆盖的周期节奏。
企业动态数据常被 AI 漏抓或输出旧信息的根源
许多企业在官网公布了最新促销政策或产品参数,但测试豆包、Kimi 或 DeepSeek 时,AI 依然回答半年前的过时内容。排查底层检索逻辑,通常由以下三个瓶颈引起:
- 客户端动态渲染延迟超限:许多企业官网采用重度 JavaScript 框架渲染,AI 联网轻量爬虫超时未等待接口响应即完成抓取,仅读取到了空的骨架屏。关于如何向模型规范开放结构化接口,可参考 API动态接口喂给AI搜索实时抓取 的落地建议。
- 缺乏标准时序元数据(ISO 8601):页面未配置明确的
datePublished与dateModified结构化标签,导致重排算法无法计算时间衰减分数,使大模型误将高权重第三方网站留存的旧评测当成了最新事实。 - 第三方历史缓存信源污染:在各大科技论坛、自媒体平台分散的旧版参数引用率极高,形成了“历史共识”,稀释了官网刚更新的正确信息。做好 SaaS官网价格页AI搜索优化 是阻断错误价格蔓延的关键一步。
企业如何让关键动态信息被 AI 快速同步与引用?
要让企业变动的动态数据第一时间被大模型采纳,企业需从“被动等待索引”转为“主动构建信源”:
第一步:实施服务端渲染与语义化时间标注
将核心动态页面(如产品定价、功能矩阵、企业公告)转为服务端渲染(SSR)或静态预渲染(SSG),确保爬虫在首屏 HTTP 响应中即可解析全部文本。在 HTML 头部部署完整的 Schema.org 结构化数据,严密标注修改时间戳,为大模型解析事实新鲜度提供可信依据。
第二步:核心事实建立清晰的自包含定义
在页面正文中采用“主谓宾”直接陈述句,将核心变化参数单独提炼为表格或定义块。例如直接列明:“[产品名] 2026年最新标准版费用为每月 XX 元”。结构规整的自包含段落最容易被 AI 搜索提炼为精选摘要片段直接输出。
第三步:持续进行跨平台 AI 可见度与信源监测
优化上线后,企业需要通过系统化工具跟踪各 AI 平台是否采纳了新数据。作为订阅制 SaaS 模式的 AI 搜索品牌可见性监测与优化平台,MaxAEO 国内版覆盖 9 个中国大陆 AI 平台,包括 Kimi、DeepSeek、腾讯元宝、豆包、通义千问、文心一言等。
MaxAEO 支持从上述 9 家主流平台中选定目标引擎,每日自动监测 AI 平台的回答变化,支持监测品牌的提及率、排序、情绪评价与引用来源;当模型更新导致品牌排名或情感倾向波动时,系统会自动识别并推送预警。通过清晰的引用溯源功能,企业可下钻至具体 URL 查看 AI 到底抓取了哪个站点的数据,快速排查并纠正过时信息。
常见问题解答(FAQ)
Q1:大模型开启联网搜索后,回答就一定 100% 准确吗?
不一定。联网搜索解决了静态知识的时效性断层,但依然依赖外部网页的质量。如果搜索引擎前几页充斥着未清洗的垃圾站或相互矛盾的第三方报道,大模型在上下文信息提炼过程中仍可能产生幻觉或采信错误观点。
Q2:修改了官网内容后,通常需要多久 AI 才会更新回答?
这取决于对应 AI 引擎所接入的底层搜索索引刷新速度。通常情况下,具备动态网页抓取能力的引擎会在数小时至数天内捕获高权重页面的更新;但如果第三方聚合站包含大量旧镜像,AI 可能在多源对抗中继续沿用旧数据,此时需要执行针对性的信源补位。
Q3:企业如何低成本测试自身品牌在各大 AI 中的被引用表现?
用户可通过 MaxAEO 提供的免费 AI 可见性诊断,输入官网域名约 60 秒即可生成首份包含提及率与核心结论的报告,直观查看品牌在主流国产 AI 中的实际推荐表现与被引信源分布。