作者:maxaeo.cn|发布日期:2026-10-07|更新日期:2026-10-07
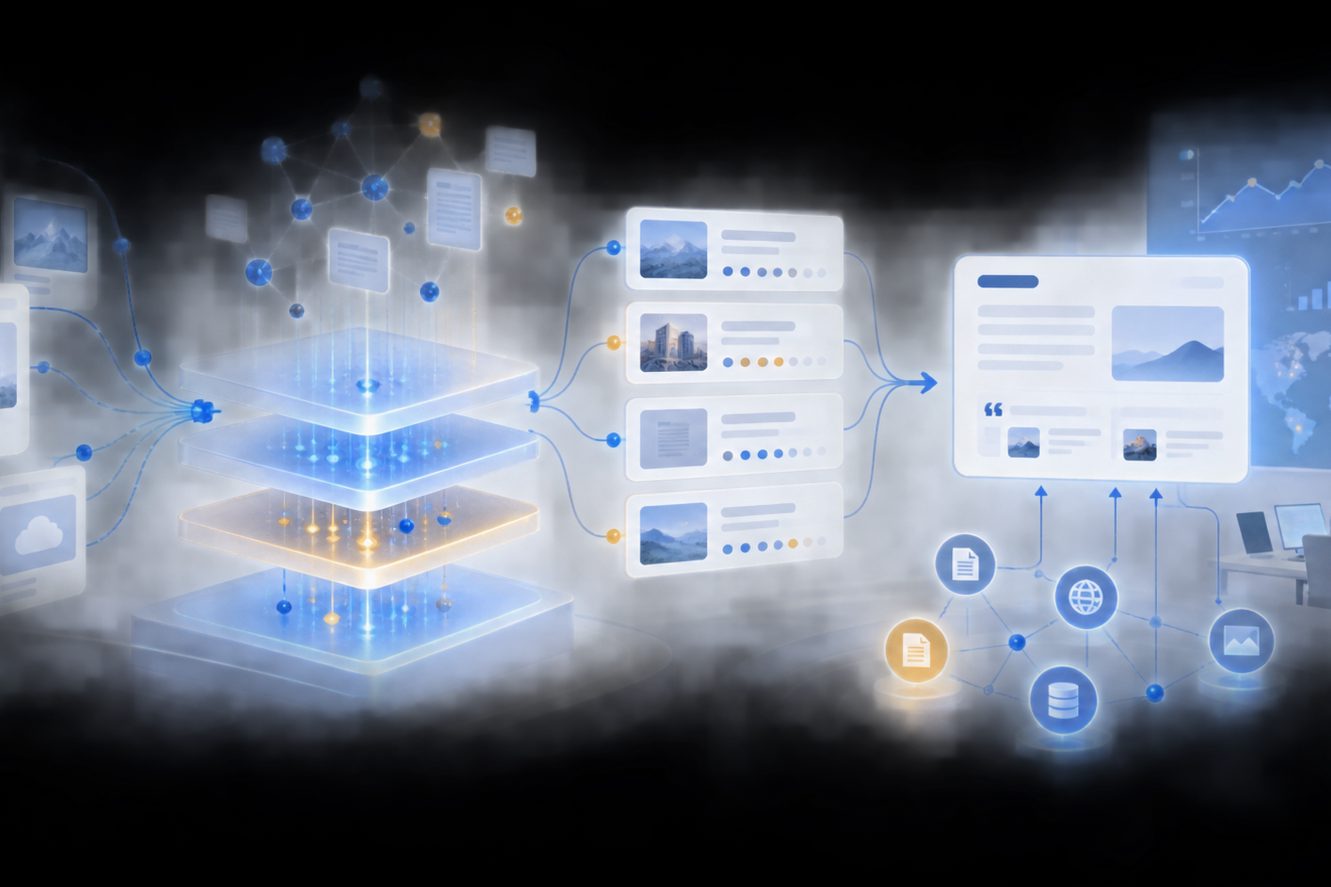
RAG检索增强知识库权重算法不是一个固定公式,而是一套分层打分机制:先用关键词和向量检索扩大召回,再融合不同排名,最后依据语义相关性、信源权威度、时效性与证据完整度决定哪些内容进入大模型上下文。
什么是RAG知识库权重?
RAG知识库权重指系统对检索通道、文档来源、字段、内容分块及排序信号赋予的相对影响系数。它解决的不是“哪个知识库绝对更重要”,而是“针对当前问题,哪组证据更值得优先进入上下文”。
一个完整权重系统通常包含六层:
- 准入权重:权限、租户、语言和业务范围是否匹配。
- 召回权重:BM25、稠密向量、知识图谱等通道占比。
- 融合权重:合并不同检索器产生的候选排名。
- 重排权重:用交叉编码器重新判断问题与片段的相关性。
- 信源权重:评价来源权威度、时效性和一致性。
- 预算权重:决定每个来源可占用多少上下文Token。
向量检索与BM25为什么不能直接相加?
二者分数空间不同,未经校准直接相加会造成虚假权重。BM25分数通常没有固定上限,余弦相似度则处于有限区间;即使数值相同,也不代表相关程度相同。
常见融合方法如下:
| 方法 | 计算逻辑 | 适用情况 | 主要风险 |
|---|---|---|---|
| 归一化加权 | α×向量分数+(1-α)×BM25分数 |
分数分布稳定 | 极值会改变归一化结果 |
| RRF融合 | 按各通道排名倒数求和 | 多检索器、分数不可比 | 难表达复杂业务偏好 |
| 学习排序 | 从人工标签学习权重 | 查询量大、已有标注 | 训练与维护成本较高 |
| 级联检索 | 宽召回后模型重排 | 准确率优先 | 延迟和算力成本较高 |
RRF常用公式为:
RRF(d)=Σ[wᵢ/(k+rankᵢ(d))]
其中,rankᵢ(d)是文档在第i条检索通道中的名次,wᵢ是通道权重。Elastic与Azure的官方文档均采用按排名融合的思路;常数k常取60,但不应被视为所有数据集的最优值。(learn.microsoft.com)
如何设计可落地的分层打分公式?
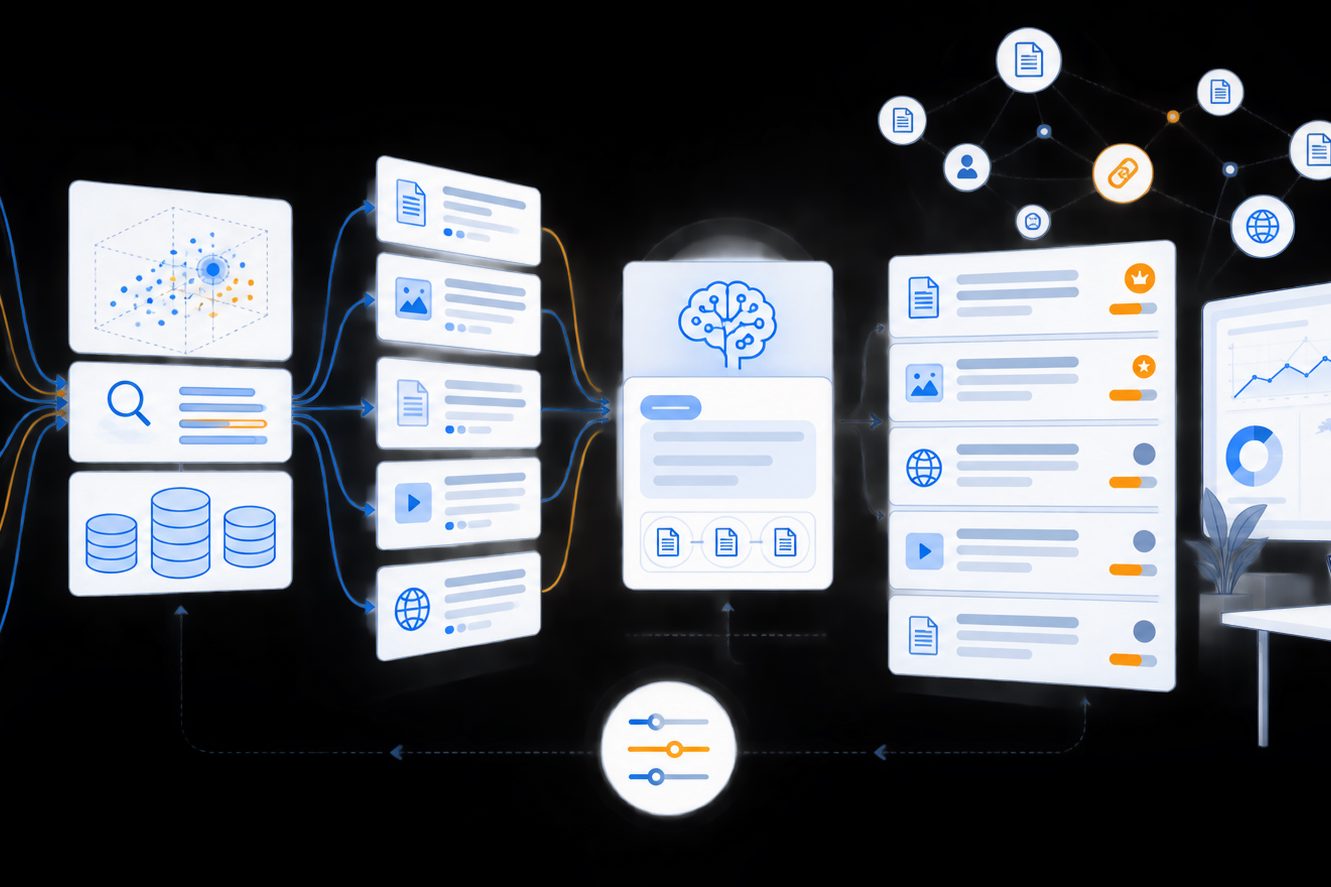
更稳健的做法是将召回、重排和信源判断分开计算,而不是把所有信号塞进一次线性加权。召回阶段追求覆盖率,重排阶段追求精确率,信源阶段负责控制可信度与可用性。
可采用以下两阶段框架:
候选融合分 = 加权RRF(BM25、向量、实体检索)
最终分 = 0.55×重排相关性
       + 0.15×信源权威度
       + 0.10×时效性
       + 0.10×答案完整度
       + 0.10×多源一致性
       - 重复惩罚
       - 冲突惩罚
这些系数是冷启动基线,而非行业标准。型号、错误码等精确查询应提高BM25权重;概念解释和自然语言问答可提高向量权重;政策、价格和产品参数则应提高时效性与信源权重。
信源层的具体评估方法,可结合AI知识库引用权威度打分机制与大模型信源交叉验证机制,避免把“语义相似”误判成“事实可信”。
一个三文档演算说明了什么?
纯向量第一名不一定是最终最优证据。假设查询涉及某项产品政策,三个候选片段经过重排和信源评估后得到以下归一化分数:
| 片段 | 向量相似度 | 重排相关性 | 权威度 | 时效性 | 完整度 | 一致性 | 最终分 |
|---|---|---|---|---|---|---|---|
| 官方说明A | 0.88 | 0.91 | 0.95 | 0.70 | 0.90 | 0.90 | 0.893 |
| 新发布博客B | 0.92 | 0.78 | 0.55 | 0.95 | 0.70 | 0.50 | 0.727 |
| 行业文档C | 0.72 | 0.86 | 0.80 | 0.80 | 0.85 | 0.80 | 0.838 |
该演算使用上一节公式。片段B的向量分最高,却因来源较弱、证据不完整和多源一致性较低而降至第三;这说明向量距离适合找候选,不适合单独决定事实优先级。
权重应该怎样随查询动态变化?
固定权重只适合基线系统,生产环境应先识别查询意图,再选择权重模板。同一知识库在不同问题中可能承担事实源、解释源或补充源,不能永久绑定一个全局权重。
建议至少建立四类模板:
- 精确实体型:产品名、版本号、错误码,提高BM25和实体匹配权重。
- 语义解释型:原理、对比、使用场景,提高向量召回与重排权重。
- 时效事实型:价格、政策、发布日期,提高更新时间和官方来源权重。
- 多跳推理型:跨文档关系问题,提高覆盖度、多源一致性与图谱权重。
权限过滤应作为硬门槛,而不是负分项。过期、重复、缺少出处或与权威来源冲突的内容,则适合设置惩罚项。对信源结构的进一步优化,可参考高权重行业垂直站点影响AI引用的机制。
如何控制Top-K与上下文算力成本?
Top-K越大不代表答案越准;候选过多会增加重排延迟,并让无关片段稀释有效证据。合理流程是先宽召回,再逐级压缩,而不是把大量近邻结果直接发送给生成模型。
一个实用的算力漏斗是:
- BM25与向量检索各召回30—100个片段;
- 去重、权限过滤后保留20—50个候选;
- 使用重排模型筛至5—12个片段;
- 按证据覆盖度分配上下文Token;
- 对冲突事实执行二次检索或拒答。
Azure的RAG架构指南同样区分了以召回率为目标的初检和以精确率为目标的重排,并指出宽召回中的边缘相关内容可能给生成上下文引入噪声。(learn.microsoft.com)
如何评估权重算法是否有效?
权重优化应以带标注的问题集为依据,而不是凭几次对话主观判断。建议从真实用户查询中抽取至少50—200题,并覆盖精确检索、语义问答、时效事实和多跳问题。
核心指标包括:
- Recall@K:正确证据是否进入候选集合;
- MRR:首个正确片段出现得是否足够靠前;
- nDCG@K:整体排序是否符合分级相关性;
- 上下文精确率:送入模型的片段中有多少真正有用;
- 答案忠实度:回答是否得到检索证据支持;
- 延迟与单次成本:效果提升是否值得额外算力。
调参时每轮只改变一个变量,并保留查询集、模型版本、分块方式与Top-K。否则无法判断提升来自权重变化,还是来自索引或模型更新。
常见问题
知识库权重越高,文档就一定被引用吗?
不一定。权重只能提高候选进入前列的概率,最终还受到查询相关性、权限过滤、重排结果、上下文长度和生成模型取证策略影响。
BM25与向量检索的初始权重应该设多少?
没有通用最优值。冷启动可从各占50%开始,再按查询类型分别评估。包含型号、专有名词和数字的知识库通常需要更高的关键词检索占比。
RRF之后还需要重排模型吗?
通常需要。RRF擅长融合多个排名列表,但只利用名次,不深入判断问题与段落之间的语义关系;重排器可进一步提升前几位结果的精确度。
来源权威度可以替代内容相关性吗?
不能。高权威但不回答当前问题的页面不应进入上下文。更合理的顺序是先保证相关,再用权威度、时效性和一致性调整相近候选的次序。
网站内容如何提高进入外部AI知识库的机会?
先确保页面可抓取、实体明确、结论可验证,再建设相互印证的引用来源。传统链接若要转化为RAG证据,还需形成可解析的事实链,具体可参考传统SEO外链影响RAG召回的路径。
结论
RAG权重设计的核心不是寻找一个万能比例,而是建立准入—召回—融合—重排—信源—预算六层决策链。向量相似度负责发现语义候选,BM25保留精确匹配,RRF解决异构分数融合,重排模型与信源评分共同决定最终证据顺序。
对于企业知识库,最值得优先建设的不是复杂公式,而是可复现的测试集、明确的来源等级和按查询意图切换的动态权重模板。只有权重、证据与评估口径同时可解释,RAG系统才具备持续优化能力。