作者:maxaeo.cn|发布日期:2026-10-06|更新日期:2026-10-06
单页面应用SPA大模型抓取解决方案的核心,是让关键内容直接存在于服务器返回的初始HTML中,而不是等待浏览器执行JavaScript后再生成。 对SaaS官网而言,通常应优先采用SSG或SSR,存量系统可用预渲染过渡,再通过日志与AI回答复测验证效果。
为什么SPA会出现“大模型看不到”的问题?
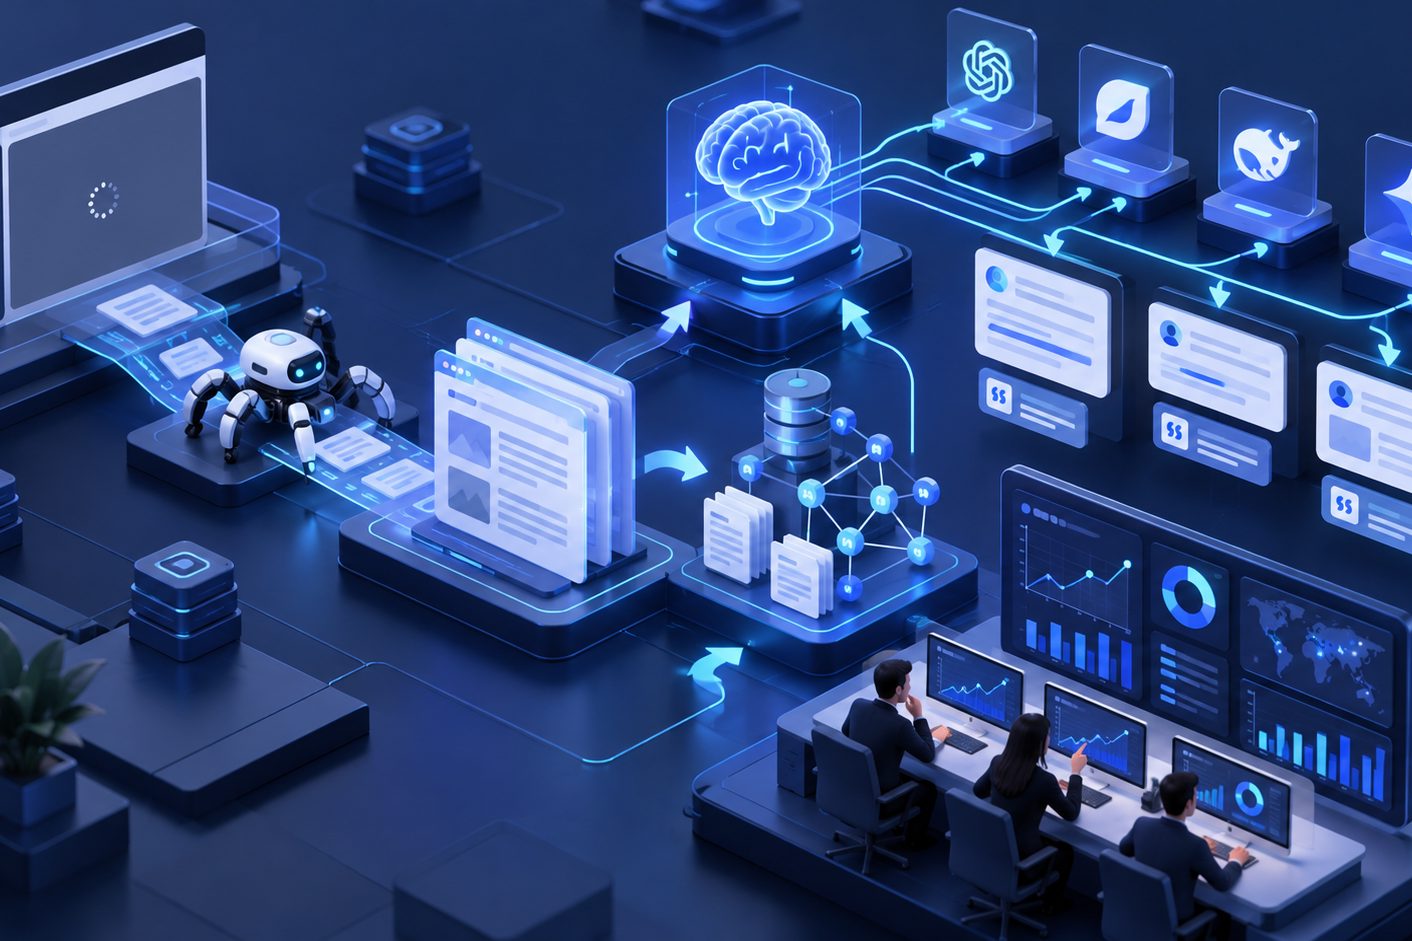
SPA抓取问题不是页面不能在浏览器打开,而是爬虫首次请求可能只收到空容器、脚本文件和加载动画,产品功能、价格说明、案例及帮助文档尚未进入HTML证据面。
Google能够处理部分JavaScript,但其官方文档同时指出,页面需要经历抓取、渲染和索引流程,而且并非所有机器人都能运行JavaScript。因此,服务端渲染或预渲染仍是更稳妥的交付方式。(developers.google.com)
常见故障包括:
- 初始源码只有
<div id="root"></div>; - 内容必须调用接口后才出现;
- 使用
#/pricing等哈希路由; - 按钮通过脚本跳转,没有真实的
<a href>; - CDN、WAF或验证码拦截自动访问;
- 所有路由均返回200状态,形成软404;
- 标题、canonical和结构化数据仅在客户端注入。
这也是为什么“用户能看到”不等于“搜索引擎和AI系统能稳定读取”。可结合品牌官网未被AI提及的三层诊断方法继续区分抓取、理解和采信问题。
SSR、SSG和预渲染应该怎么选?
内容稳定、页面数量可控时优先SSG;内容频繁更新或依赖实时数据时选择SSR;暂时无法重构的旧SPA,可用预渲染作为过渡方案。
| 方案 | 适合场景 | 初始HTML | 改造成本 | 建议 |
|---|---|---|---|---|
| SSG静态生成 | 官网、博客、帮助中心 | 完整 | 中 | SaaS营销站首选 |
| SSR服务端渲染 | 动态产品页、实时目录 | 完整 | 中至高 | 兼顾实时性与抓取 |
| 混合渲染 | 官网包含静态及动态页面 | 完整 | 中 | 按路由选择策略 |
| 预渲染 | 存量React、Vue SPA | 通常完整 | 低至中 | 适合短期修复 |
| 纯CSR | 登录后台、交互工具 | 可能为空 | 低 | 不宜承载公开获客内容 |
Google已将动态渲染定义为临时处理方法,更推荐SSR、静态渲染或水合方案。(developers.google.com) 因此,不建议长期维护一套“只给爬虫看的内容”;爬虫版与用户版应保持主题、正文和链接一致。
如何完成SPA抓取改造?
改造应同时处理内容输出、独立URL、可抓取链接、访问权限和状态码,而不是只安装一个SEO插件。
-
划定公开内容路由
优先改造首页、功能页、价格页、行业方案、客户案例、博客和帮助文档。登录后的控制台通常无需进入公开索引。 -
把核心信息写入首包HTML
<title>、H1、产品描述、参数、正文、内部链接、canonical和JSON-LD,应在查看网页源代码时直接出现。 -
为每个主题提供独立URL
使用/features/monitoring这类路径,不要依靠#/features切换内容。Google建议SPA使用History API,并确保每个内容视图拥有可单独请求的URL。(developers.google.com) -
建立真实链接与网站地图
导航和正文入口应使用带有href的<a>元素,而不是只有点击事件的按钮;同时将规范URL加入XML Sitemap。(developers.google.com) -
检查robots.txt、WAF与CDN
robots.txt允许访问并不代表边缘安全层一定放行。还要检查403、429、JavaScript挑战、地区限制和异常缓存。
OpenAI目前将用于搜索展示的OAI-SearchBot与用于模型训练的GPTBot分开管理,网站可以按用途设置访问规则。(developers.openai.com) 不应为了开放搜索抓取而无条件放行所有自动化流量。
怎样用“12次请求验收法”确认修复有效?
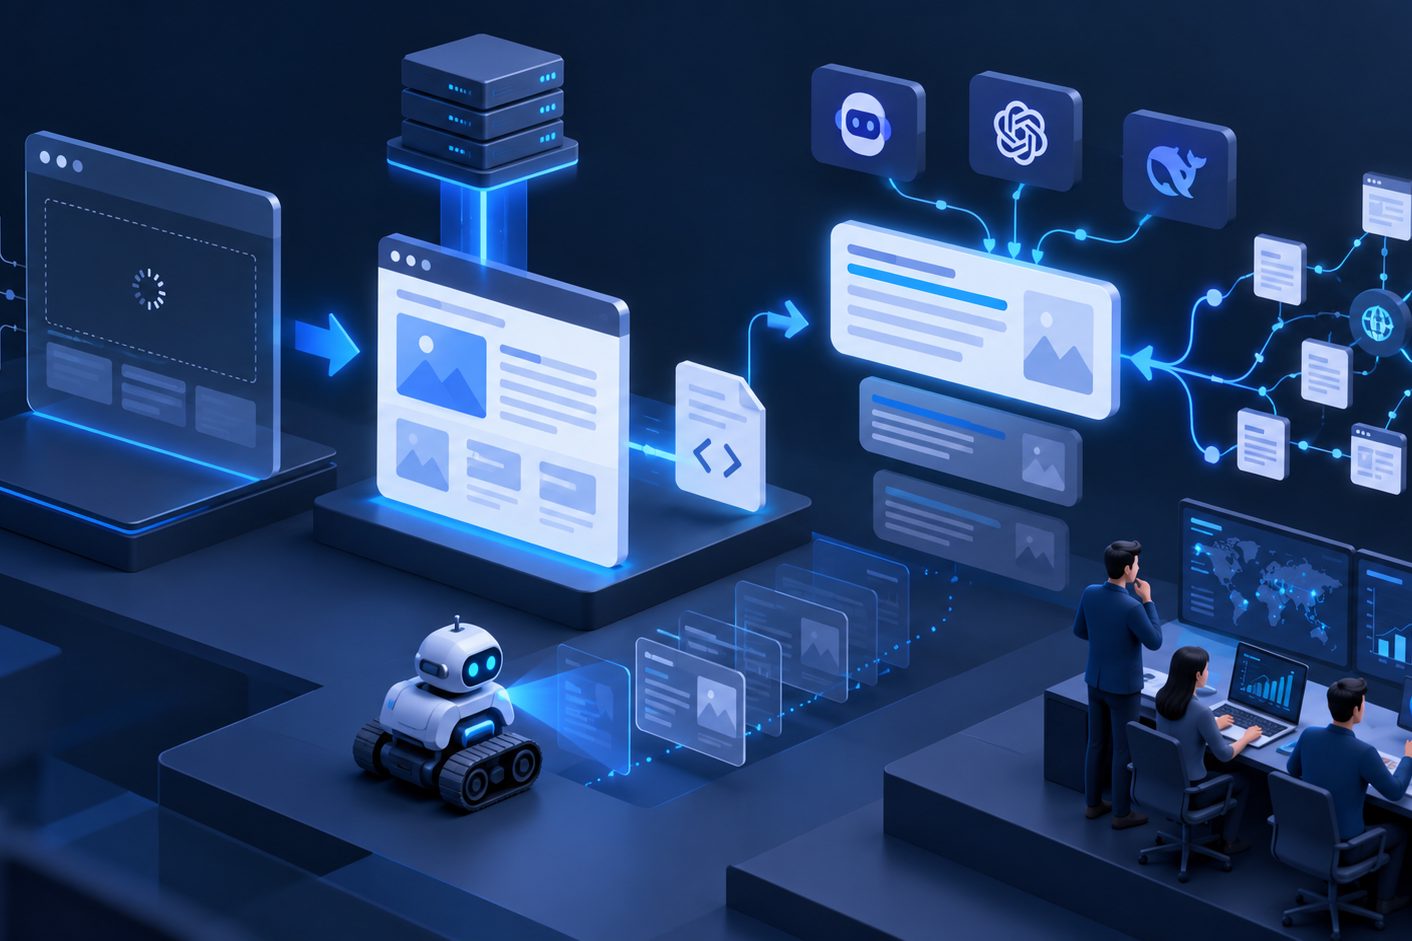
不要只测首页。建议选取3类关键URL,用4种访问方式完成12次检查,并按“访问、完整、独立、可验证”四项评分。
选择首页、功能页和文章页各1个URL,分别执行:
- 浏览器关闭JavaScript后访问;
- 使用“查看网页源代码”检查首包HTML;
- 使用普通命令行请求获取响应;
- 使用目标爬虫User-Agent进行模拟请求。
每个URL按四项各计0—2分:
- 访问性:返回200,无验证码、登录墙或循环重定向;
- 完整性:标题、H1、核心正文和主要链接已在HTML中;
- 独立性:URL、canonical及页面主题一一对应;
- 可验证性:包含明确实体、参数、更新时间和证据来源。
建议单页至少达到7分,且“完整性”必须为2分。如果浏览器页面正常,但源码没有产品正文,说明只是前端展示成功,不能视为单页面应用SPA大模型抓取解决方案已经验收通过。
抓取成功后,为什么仍可能不被AI引用?
可抓取只是入口条件,大模型还会判断内容是否与问题相关、事实是否清晰、来源是否可信,以及其他信源是否提供了更直接的证据。
技术改造后,还应补齐以下内容:
- 用清晰标题回答具体购买与选型问题;
- 将功能、适用对象、限制条件和版本差异写成可摘录段落;
- 为参数、价格和发布日期提供统一口径;
- 使用语义化HTML组织表格、列表和问答;
- 建立官网、行业媒体、评测站与文档之间的证据链;
- 避免多个页面重复描述同一主题。
可进一步参考从可抓取到证据闭环的可信信源建设方法和垂直行业数据的结构化与引用路径,将“爬虫能读”升级为“回答时值得引用”。
如何监测改造后的AI搜索效果?
验收不能止于HTML检查,还应持续观察提及率、推荐位次、情感变化和引用来源,判断技术修复是否真正进入AI回答。
建议建立三层指标:
| 层级 | 核心指标 | 主要用途 |
|---|---|---|
| 抓取层 | 状态码、响应大小、爬虫访问次数 | 发现拦截或空壳HTML |
| 内容层 | 正文完整率、有效URL数、引用页覆盖率 | 判断内容能否成为证据 |
| 回答层 | 品牌提及率、推荐位次、情感、引用域名 | 验证最终可见性 |
MaxAEO支持对豆包、DeepSeek、腾讯元宝、Kimi、通义千问、文心一言等9个国产AI平台进行持续监测,按天追踪提及率、排序、情绪和引用来源。技术上线前后应使用相同问题集复测,避免把模型随机波动误判为改造效果。低成本监测流程可参考国产AI搜索监测闭环。
常见问题
SPA网站必须全部改成SSR吗?
不必。公开获客页面可采用SSG、SSR或混合渲染,登录后台继续使用CSR。重点是需要被发现、理解和引用的内容必须存在于可直接请求的HTML中。
预渲染会被判定为伪装吗?
预渲染本身不是问题,风险来自向爬虫和用户提供实质不同的内容。两种版本应保持标题、主体事实、链接和结构化数据一致。
robots.txt允许AI爬虫后就能被引用吗?
不能保证。robots.txt只控制部分爬虫的访问许可,WAF、CDN、渲染方式、内容质量和信源权威度仍会影响抓取与引用。
如何快速判断SPA是否存在空壳HTML?
打开“查看网页源代码”,搜索页面H1或一段产品介绍。如果只能找到脚本标签和根容器,而正文只存在于开发者工具的渲染后DOM中,就应进一步检查SSR、SSG或预渲染方案。
技术改造后多久能看到变化?
没有统一周期。抓取频率、页面权重、AI平台数据更新方式及问题相关性都会影响结果。更可靠的做法是保存上线前基线,随后按天或按周使用同一问题集复测。