作者:maxaeo.cn|发布日期:2026-08-30|更新日期:2026-08-30
Cloudflare 跳过托管质询 爬虫,指的是让可信搜索引擎、AI 搜索机器人、监控探针或自家 API 请求绕过 Managed Challenge,同时继续拦截低信誉、伪装 UA 和高风险自动化流量。重点不是“全站放行”,而是按身份、路径、规则顺序做最小例外。
什么是 Cloudflare 托管质询,为什么会挡住爬虫?
托管质询是 Cloudflare 根据风险信号自动选择验证方式的防护动作。它适合拦疑似机器人,但不适合所有自动化访问,尤其是不会执行浏览器质询流程的爬虫。
Cloudflare 官方文档说明,质询可能由高风险 IP、IP 信誉、机器人检测、WAF 自定义规则、浏览器完整性检查等触发;若要避免 Block 或 Challenge 作用于特定流量,需要配置 WAF 例外规则,可参考 Cloudflare Challenges 排查文档。
对 SEO 和 GEO 来说,问题常出在这里:浏览器访问页面正常,但 AI 爬虫、搜索引擎抓取、站点监控或预览机器人拿到的是 403、质询页 HTML,或只抓到 /cdn-cgi/challenge-platform/ 相关内容。
什么时候需要跳过托管质询?
只有当可信爬虫被误拦、抓取链路被质询页替代、或 AI 搜索无法读取关键页面时,才需要跳过托管质询。不要因为看到机器人流量就直接放行。
优先处理这 4 类场景:
- 搜索引擎爬虫误伤:Googlebot、Bingbot 等被 Challenge 或 403。
- AI 搜索抓取失败:OAI-SearchBot、PerplexityBot、GPTBot、ClaudeBot 等无法读取公开内容。
- 监控与预览服务失效:状态监控、链接预览、SEO 抓取工具被拦。
- 自家接口被误判:内部 API、移动端、服务端渲染请求不应走浏览器质询。
如果你的问题是 AI 搜索引用不到品牌内容,可以同时排查协议、WAF 与引用来源。MaxAEO 这篇 AI 爬虫访问被拦截排查指南 更适合做全链路核对。
先判断:是真爬虫,还是伪装 UA?
跳过规则前必须先验证身份。User-Agent 只能作为线索,不能作为唯一放行依据,因为恶意爬虫可以伪装成 Googlebot 或常见 AI 爬虫。
推荐用“三证合一”判断:
| 证据 | 看什么 | 通过标准 |
|---|---|---|
| Cloudflare 字段 | cf.client.bot、cf.bot_management.verified_bot、验证机器人类别 |
命中已验证机器人 |
| 日志记录 | IP、UA、路径、状态码、Ray ID、触发规则 | 与误拦时间一致 |
| 官方验证 | 反向 DNS 或官方 IP 段 | 与官方来源匹配 |
Google 明确建议使用反向 DNS 或 IP 范围验证 Googlebot,而不是只看 UA,可参考 Google 验证抓取请求文档。Cloudflare 也在机器人规则示例中使用 cf.bot_management.verified_bot 来识别已知好机器人,见 Challenge bad bots 文档。
最小放行规则怎么写?
最稳妥的做法是把 Skip 规则放在 Challenge 或 Block 规则之前,只跳过必要阶段或后续自定义规则,不关闭整个站点防护。
Cloudflare 文档强调,Skip 规则必须放在它要绕过的 Block 或 Challenge 规则之前;否则规则顺序错误,爬虫仍会先被质询。可参考 Cloudflare Skip 选项说明。
一个通用顺序如下:
-
规则 1:放行已验证可信机器人
- 条件:
cf.bot_management.verified_bot - 动作:Skip → All remaining custom rules
- 用途:让 Googlebot、Bingbot、部分已验证服务绕过后续质询规则。
- 条件:
-
规则 2:放行指定路径的可信服务
- 条件:已验证来源,且路径为
/robots.txt、/sitemap.xml、核心内容页或 API 健康检查。 - 动作:Skip 指定规则或剩余自定义规则。
- 用途:避免全站放行。
- 条件:已验证来源,且路径为
-
规则 3:拦截明确恶意自动化
- 条件:机器人分数极低、异常 ASN、高频访问、伪装 UA。
- 动作:Block 或 Rate Limit。
-
规则 4:对疑似自动化执行 Managed Challenge
- 条件:未验证、行为异常、访问敏感路径。
- 动作:Managed Challenge。
这套顺序的关键是:先确认好人,再处理坏人,最后挑战灰色流量。
AI 爬虫要不要一律跳过托管质询?
不建议一律跳过。AI 爬虫分为训练型、搜索引用型、代理访问型和伪装型,价值与风险不同,应按业务目标分层处理。
可用这个分层框架:
| 类型 | 例子 | 建议动作 |
|---|---|---|
| 搜索引用型 | OAI-SearchBot、部分 AI 搜索抓取器 | 允许抓取公开知识页、品牌页、文档页 |
| 训练型 | GPTBot、ClaudeBot 等 | 根据版权、带宽和品牌曝光目标决定 |
| SEO/监控型 | 站点审计、预览、可用性监控 | 验证来源后跳过质询 |
| 未验证伪装型 | 假 Googlebot、随机 UA、数据中心高频请求 | 不跳过,限速或阻断 |
Cloudflare 学习中心也提醒,站长应在日志里识别 AI 爬虫 UA、请求量和频率,再决定允许、限制或阻断,见 Cloudflare 关于识别 AI 爬虫的说明。
如果你的目标是提升 AI 搜索中的品牌可见性,不只要放行,还要追踪哪些页面被引用。MaxAEO 的 国产 AI 爬虫 UA 大全 可作为识别线索,后续可结合 DeepSeek 爬虫抓取协议配置指南 做平台级验证。
一手排查模板:10×4×2 复测矩阵
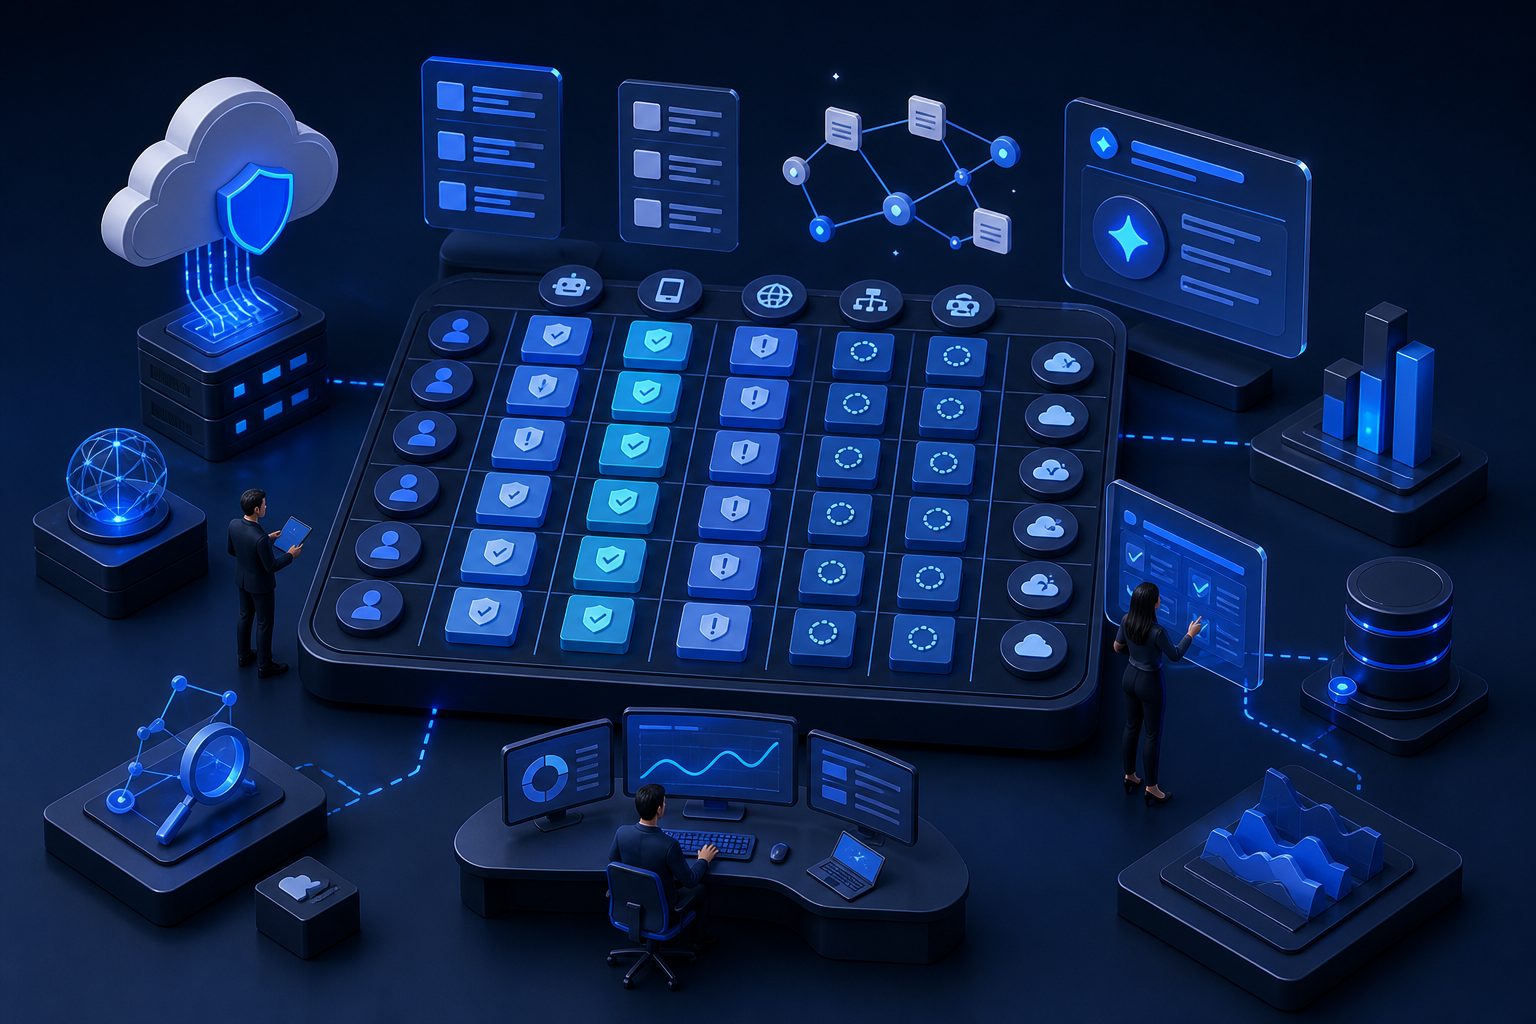
单看一条日志容易误判。更可靠的办法是用 10 个 URL、4 类访问身份、2 种规则状态做矩阵复测,确认问题是否来自托管质询。
MaxAEO 在处理 AI 搜索可见性排查时,常用下面的复测口径:
- 10 个 URL:首页、品牌页、产品页、文档页、价格页、博客页、robots.txt、sitemap.xml、API 健康检查、一个低价值测试页。
- 4 类身份:普通浏览器、已验证搜索引擎爬虫、AI 爬虫 UA、内部监控或服务器请求。
- 2 种状态:当前规则、加 Skip 规则后的临时测试状态。
判定结果可以这样读:
| 现象 | 结论 | 修复方向 |
|---|---|---|
| 浏览器 200,爬虫 403 | WAF、Bot、ASN 或 UA 规则误伤 | 加验证机器人 Skip |
| robots.txt 200,正文页 403 | 路径级规则误伤 | 检查页面路径、国家、ASN 条件 |
| 加 Skip 后恢复 200 | Cloudflare 规则触发明确 | 固化最小例外 |
| 加 Skip 后仍 403 | 可能是源站、插件、鉴权或上游限制 | 查源站日志和应用层 |
这比“把安全级别调低”更可控,也能留下复测证据。
规则上线后如何验证没有放大风险?
验证标准不是“爬虫能访问”这么简单,而是可信爬虫能访问、伪装流量仍被限制、AI 搜索能读取正确内容。
上线后建议观察 3 组指标:
-
抓取结果
- 目标 URL 是否从 403、503、Challenge HTML 变为 200。
- 页面标题、正文、结构化数据是否能被正常读取。
-
安全事件
- Skip 命中的请求量是否合理。
- 是否出现大量陌生 IP 借同一 UA 通过。
-
AI 搜索回声
- 品牌是否被提及。
- 引用来源是否来自你的官网或可信第三方。
- 描述是否准确、有无旧信息或负面误读。
MaxAEO 国内版覆盖豆包、DeepSeek、腾讯元宝、通义千问、文心一言、Kimi 等 9 个国产 AI 平台,可监测品牌提及率、排序、情绪评价与引用来源。若要验证放行后是否真的改善 AI 抓取与引用,可参考 AI 搜索引擎抓取失败排查指南。
常见问题
只用 User-Agent 放行 Googlebot 可以吗?
不建议。UA 很容易伪造,应结合 Cloudflare 已验证机器人字段、官方 IP 段或反向 DNS。尤其是高价值内容站和 SaaS 官网,单靠 UA 放行会放大爬取和撞库风险。
Skip 和 Allow 有什么区别?
Skip 更适合“绕过某些安全规则”,例如跳过后续自定义规则、托管规则或 Super Bot Fight Mode 阶段;Allow 更像明确允许请求继续处理。排查托管质询误伤时,Skip 通常更细粒度。
Bot Fight Mode 能被 Skip 规则跳过吗?
需要看产品与计划。Cloudflare 文档说明,目前不能跳过 Bot Fight Mode,只能跳过 Super Bot Fight Mode 等特定阶段。因此如果免费计划的 Bot Fight Mode 造成误伤,可能需要调整该功能本身,而不是只写 Skip。
AI 爬虫被放行后,多久能在 AI 搜索里看到变化?
没有固定时间。放行只是解决“能不能抓”的问题,AI 平台是否引用还取决于页面质量、信息结构、权威信源和模型更新周期。建议用同一组问题每日复测,而不是看单次结果。
Cloudflare 跳过托管质询 爬虫会影响网站安全吗?
配置得当不会。风险来自全站无差别放行。安全做法是只放行已验证来源、限定必要路径、保留日志、继续对未验证自动化流量限速或质询。
结论:先证据,后例外,再复测
Cloudflare 跳过托管质询 爬虫的正确路线是:先用日志和官方验证确认误拦,再把 Skip 规则放到 Challenge/Block 规则之前,最后用固定 URL、固定 UA、固定问题复测。
对希望进入 AI 搜索答案的品牌而言,放行只是第一步。更重要的是让 AI 能抓到清晰、可信、结构化的品牌信息,并持续观察提及率、推荐位次和引用来源变化。MaxAEO 提供免费 AI 可见性诊断,输入官网域名约 60 秒即可生成首份包含提及率与核心结论的报告,可用于判断抓取修复后的真实回声。