AI 搜索引擎抓取失败是指 AI 模型的联网检索爬虫(如 Bytespider、KimiBot 等)在尝试请求源站内容时,遭遇协议拒绝、网络拦截、渲染超时或反爬阻断,导致页面内容无法被摄入为大模型答案引用的技术故障。与传统搜素引擎不同,AI 搜索一旦抓取失败,品牌将在生成式回答中直接失去信息源地位。
随着大语言模型全面接入实时联网检索,GEO(生成式引擎优化)已成为企业数字资产建设的核心战场。如果源站对 AI 检索代理设置了错误的屏障,再优质的知识内容也无法转化为 AI 对话中的品牌推荐。
为什么 AI 搜索引擎抓取失败的后果比传统 SEO 更严重?
传统搜索引擎抓取失败通常表现为快照更新滞后或索引收录延期;而在大模型搜索时代,抓取失败意味着模型在生成即时回答时直接剔除该数据源。
大模型生成答案高度依赖实时 Retrieval(检索召回)链路。当用户在豆包、Kimi 或 DeepSeek 中询问“某行业最好用的 SaaS 软件有哪些”时,AI 检索系统会在几百毫秒内向候选网页发起并行探测。一旦遭遇 403 Forbidden、504 Gateway Timeout 或 JS 渲染空白,该候选节点就会立即被判定为无效信源,进而从合成上下文(Context)中彻底丢弃。
| 对比维度 | 传统搜索引擎抓取 | AI 搜索引擎检索抓取 |
|---|---|---|
| 抓取目的 | 离线建库与周期性索引 | 实时检索增强(RAG)或高频知识库同步 |
| 抓取容忍度 | 允许几小时至数天的重试与重排 | 毫秒级超时即丢弃候选,直接影响当次输出 |
| 渲染支持 | 完整的无头浏览器渲染队列 | 多数轻量化爬虫仅解析纯文本或轻量 DOM |
| 失败直接结果 | 搜索排名缓慢下滑 | AI 生成答案中完全不被提及或产生幻觉 |
AI 搜索引擎抓取失败的 4 级穿透排查模型
要精准定位抓取异常,建议运维与 SEO 团队采用自下而上的“四层排查法”:协议层、防火墙层、内容渲染层与服务性能层。
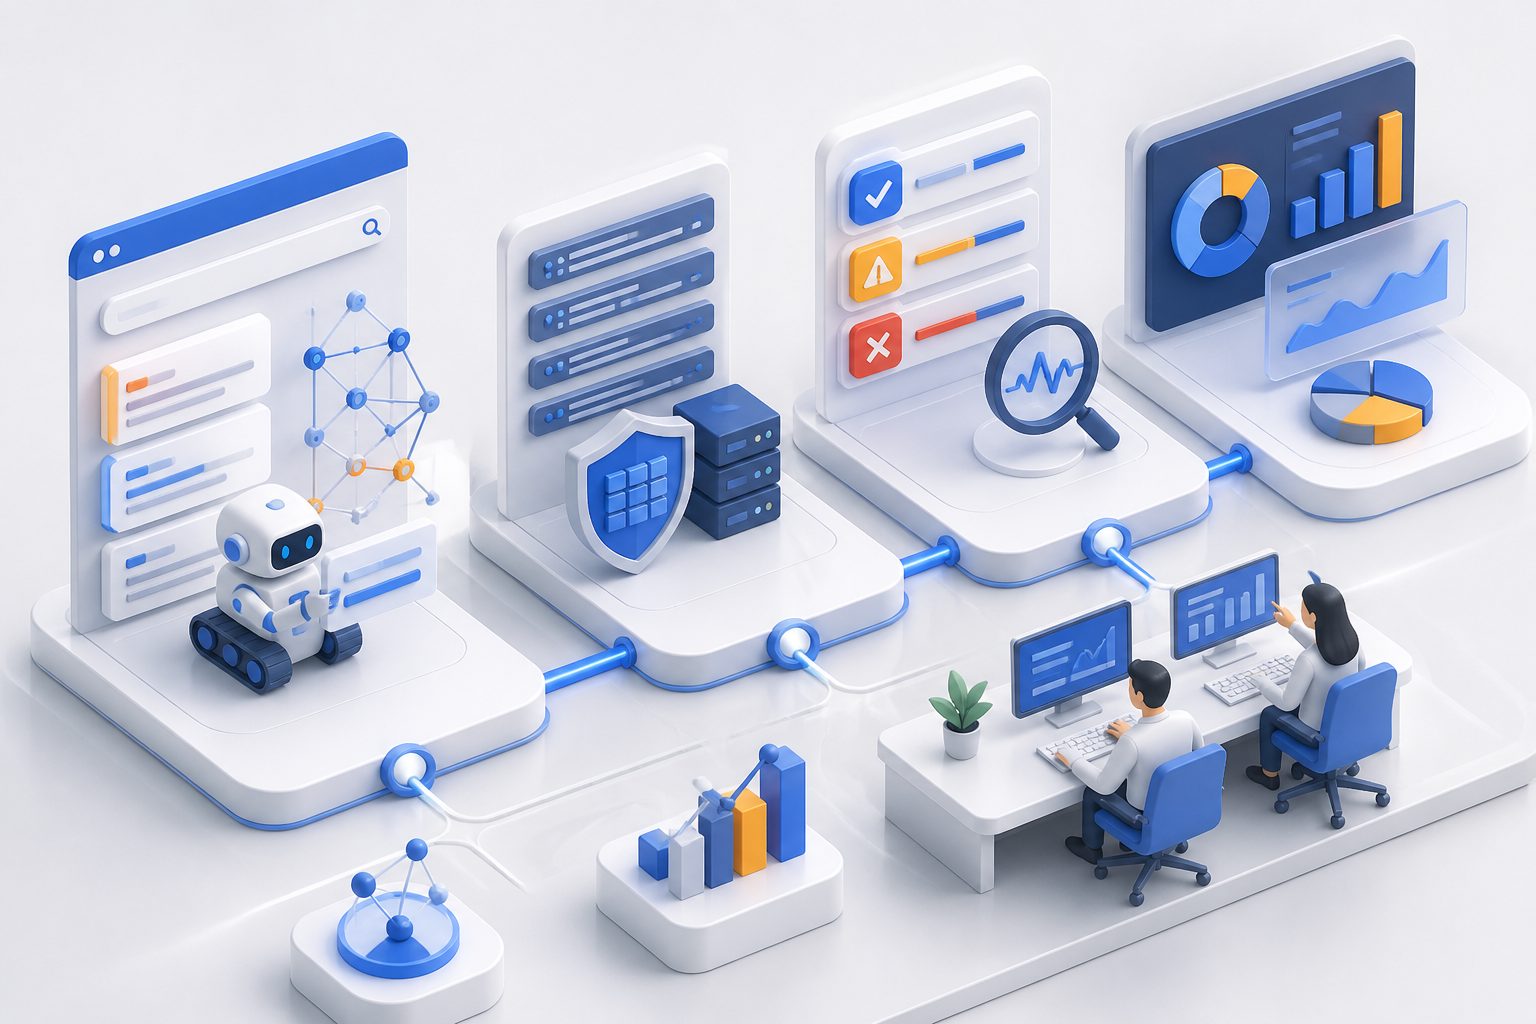
第 1 级:协议与权限层(robots.txt 与 llms.txt)
排查的第一步是核对站点根目录的访问声明。多数研发团队在更新环境时,容易误将全局禁止规则推至生产环境。
- 检查 robots.txt 声明:确认是否误写了
User-agent: * Disallow: /,或针对特定 AI 抓取代理(如Bytespider、ClaudeBot)设置了解析封禁。详细操作可参考 AI爬虫访问失败怎么排查:从 robots.txt 到 WAF 的最小闭环。 - 规范化 llms.txt 引导:为了让大模型更高效地理解企业结构化事实,建议在根目录部署 Markdown 格式的知识摘要。若格式不合规或路径错误,同样会导致解析异常,可遵循 llms.txt 文件规范:格式、部署位置与验证方法 进行校验。
第 2 级:安全防护与 CDN 层(WAF 误拦截)
在实际生产环境中,超过 60% 的抓取失败源自 CDN 与 Web 应用防火墙(WAF)的自动拦截。
- Bot 行为指纹识别:很多 WAF(如 Cloudflare、阿里云 WAF)默认开启了“机器人滥用防御”,当国内 AI 引擎的高频探测请求到达时,系统会将其判定为恶意扫描并返回 403 状态码。
- 排查方法:抓取近 24 小时访问日志,过滤对应 User-Agent 与 IP 段的 HTTP 响应。如果出现大量
403且伴随 WAF 拦截标记,需要按照 WAF误拦截怎么排查:从日志到最小放行的实操清单 建立动态放行规则。
第 3 级:页面渲染与技术架构层(CSR vs SSR)
许多现代 Web 应用采用单页应用(SPA / CSR)架构,HTML 源文件中仅包含基础 JS 引导代码。
- DOM 解析断层:部分新兴 AI 搜索的抓取节点为保证响应速度,并不执行完整的无头浏览器渲染。若网页核心文本完全依赖前端异步请求,AI 爬虫抓取到的页面有效信息几乎为空。
- 解决策略:关键内容页应优先采用服务端渲染(SSR)或预渲染(SSG)方案,确保首屏 HTML 中直接包含完整的产品核心参数、FAQ 与解决方案描述。
第 4 级:源站网关与并发性能层(限流与超时)
AI 引擎在对某个主题进行深度信息挖掘时,可能会在瞬时发起数个并发请求。
- 限流阈值过低:若源站 Nginx 或 API 网关配置了过严的
limit_req规则,容易在瞬时流量下触发429 Too Many Requests。 - 连接超时(504):若动态内容生成耗时过长,超出 AI 检索代理的等待窗口(通常为 1.5–3 秒),该请求将被标记为超时失败。
国内主流 AI 引擎爬虫放行与配置建议
为了让国内主流 AI 工具精准摄取品牌信息,运维团队应针对性地在防火墙与反爬系统中建立特征白名单:
# 典型 robots.txt 推荐放行配置
User-agent: Bytespider
Allow: /

User-agent: DeepSeekBot
Allow: /

User-agent: MoonshotBot
Allow: /

User-agent: *
Disallow: /admin/
Disallow: /private/
在配置防火墙时,建议结合 User-Agent 字符串与官方公开的 AS 域名/IP 段进行双重认证,避免因伪造 UA 带来的恶意攻击风险。
建立 AI 抓取可用性与可见性的监控闭环
单次排查只能解决当下的网络或规则故障,而 AI 引擎的抓取算法与检索节点在持续更迭。企业需要建立长效的“探测—抓取—可见性验证”闭环。
作为一家专注 AI 搜索可见性(AEO/GEO)的团队,MaxAEO 国内站 建议企业定期对自身品牌在生成式大模型中的表现进行量化体检。MaxAEO 提供 60 秒自助诊断工具,支持用户快速自测品牌在 AI 中的基线表现,及时发现因抓取失效导致的提及断崖。
常见问题(FAQ)
Q1:如何验证特定 AI 爬虫是否能成功访问我的网页?
最直接的方法是使用命令行模拟该爬虫的 User-Agent 向源站发起请求:
curl -I -A "Bytespider" https://yourdomain.com/target-page
观察返回的状态码是否为 200 OK。若返回 403 或 5xx,需进一步排查 CDN/WAF 阻断日志。
Q2:放行所有 AI 爬虫会不会导致网站内容被盗用或算力耗尽?
合理的策略是“核心知识放行,私有数据阻断”。企业应对公共产品方案、博客和行业分析页面全面开放放行,同时对登录后台、个人中心和计算型 API 接口设置严格鉴权,并对爬虫 IP 配置合理的每秒请求数(QPS)阈值。
Q3:抓取恢复正常后,通常需要多久才能在 AI 搜索中看到品牌答案?
这取决于 AI 引擎的架构类型:
- 实时检索型(RAG 架构):一旦抓取通路修复,当用户再次发起包含相关关键词的提问时,几分钟至数小时内即可生效。
- 周期训练/增量微调型:通常需要等待其后台知识库索引的下一次全量刷新周期(数天至两周不等)。