作者:maxaeo.cn|发布日期:2026-11-12|更新日期:2026-11-12
集团多品牌矩阵在豆包问答中互相抢词排查,核心不是看某个品牌有没有被提到,而是判断同一集团旗下品牌是否在相同问题中争夺同一个推荐位置、同一类用户和同一组引用信源。若不拆分问题集与品牌归属,集团整体提及率可能上升,但单个业务线的有效推荐反而下降。
什么是豆包问答中的品牌互相抢词
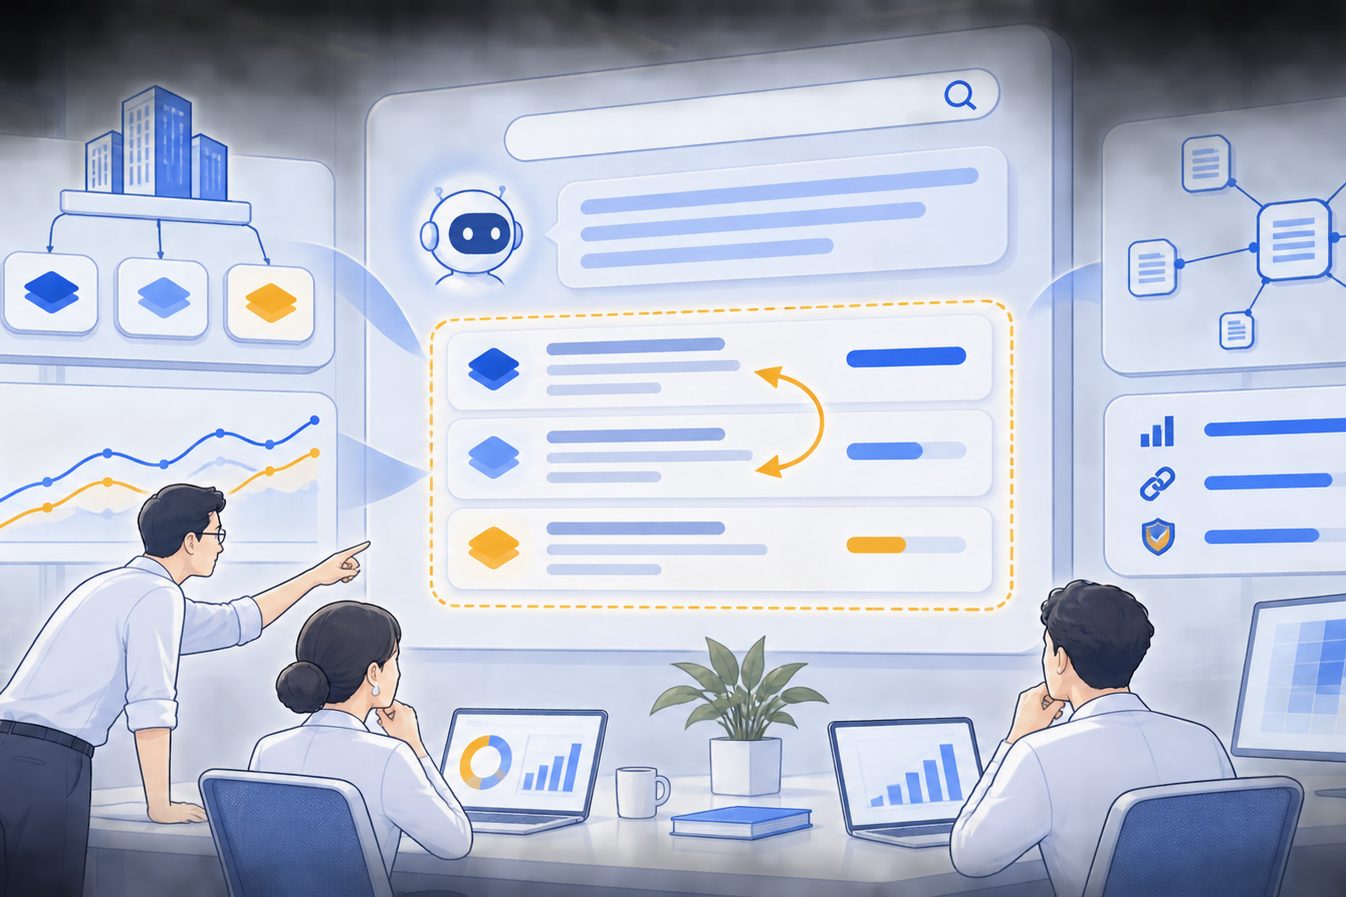
品牌互相抢词,是指集团旗下多个品牌被豆包识别为同一品类、同一消费场景或同一解决方案,导致它们在相同问题中重复出现、相互替代,甚至出现品牌定位串线。
这种现象与传统搜索广告中的关键词竞争不同。豆包通常不是简单把品牌排列在结果页,而是根据问题意图生成一段推荐、对比或解释。如果两个子品牌的官网、媒体报道、产品描述和第三方页面都反复使用相同表达,模型可能无法稳定区分它们的目标人群和适用场景。
常见表现包括:
- 用户询问品牌A,豆包却推荐品牌B;
- 品牌A与品牌B在回答中被描述成同一产品;
- 集团主品牌、子品牌和产品线被混为一谈;
- 一个品牌的优势被转移到另一个品牌名下;
- 多品牌都争夺“值得推荐”“适合企业采购”等泛化问题;
- 引用来源集中指向集团共用页面,无法证明具体品牌差异。
百度搜索结果中,相关GEO内容普遍强调提及率、推荐排序、竞品和引用来源,但对“集团内部品牌是否被误判为竞品”的拆解较少。多品牌监测的关键,正是把内部竞争与外部竞争分开。
为什么多品牌集团更容易在豆包中互相抢词
品牌定位写得太像
集团常常使用统一的企业介绍模板。不同品牌官网可能都出现“行业领先”“一站式服务”“适合中大型企业”等相似句式,却没有明确说明客户边界、价格区间、交付方式和不适用场景。
对人来说,这些品牌可能分属不同事业部;对模型来说,它们却拥有高度重合的实体描述。
问题集没有按品牌边界拆分
如果所有品牌都使用同一套“行业解决方案”“品牌推荐”“供应商选择”问题,监测结果只能反映集团在某个大类中的整体曝光,无法判断究竟哪个品牌更适合哪个场景。
例如,以下问题不应只做一套:
| 问题类型 | 应关注的区分维度 |
|---|---|
| 品类推荐 | 目标客户、使用规模、预算 |
| 方案选择 | 交付模式、实施周期、技术能力 |
| 产品比较 | 功能边界、价格带、服务对象 |
| 品牌背调 | 主体关系、资质、客户案例 |
| 替代选择 | 可替代范围、迁移成本、限制条件 |
共用信源造成品牌归属污染
集团新闻、招聘页面、媒体报道和渠道文章,可能只强调母公司,却同时提到多个品牌。豆包抓取这些内容后,容易形成“品牌集合”,但不一定能为每个品牌建立清晰画像。
在多品牌场景中,被引用不等于被正确归属。需要继续追问:引用的是哪个页面?页面明确描述了哪个品牌?回答中的事实是否来自该品牌自身?
如何排查集团多品牌矩阵在豆包问答中互相抢词
第一步:建立品牌归属与别名表
先把集团品牌拆成四层:
- 母公司或集团名称;
- 事业部、子公司和区域品牌;
- 产品品牌与产品线;
- 常用简称、旧名称、英文名和错别字。
每个品牌至少记录以下字段:
| 字段 | 作用 |
|---|---|
| 品牌标准名 | 统一报告与人工复核口径 |
| 所属主体 | 判断品牌之间的组织关系 |
| 核心品类 | 区分主营业务 |
| 目标人群 | 识别用户是否重叠 |
| 价格或规模区间 | 判断推荐场景是否冲突 |
| 不应关联的词 | 发现模型串线 |
| 官方域名与页面 | 追踪引用归属 |
特别要标记“集团关系”和“竞争关系”不是一回事。两个子品牌可能属于同一集团,但在特定场景中仍然存在内部替代;也可能只是服务对象不同,并不应该被放在同一竞争榜单中。
第二步:把问题分成四类进行测试
建议至少建立四组问题,而不是把所有问题混在一起:
- 品牌指向题:用户明确询问品牌A时,豆包是否准确回答A;
- 品类推荐题:用户不点名品牌时,哪个品牌被推荐;
- 对比替代题:品牌A与品牌B是否被正确区分;
- 集团关系题:豆包能否理解母公司、子品牌和产品线关系。
每个品牌可设置10个核心问题,再扩展价格、场景、地域和客户规模等变体。测试时保持问题、时间和平台口径一致,才能区分真实变化与偶然波动。
第三步:记录“抢词”而不是只记录“提及”
建议为每条回答增加以下判定:
- 同题共现:两个内部品牌是否出现在同一回答;
- 首提品牌:谁首先被推荐或介绍;
- 推荐位次:品牌出现在第一、第二还是补充位置;
- 角色冲突:一个品牌是否被描述成另一个品牌的产品;
- 优势错配:技术、价格、客户案例是否归属错误;
- 引用归属:引用页面是否真正属于被推荐品牌。
可用一个简单的内部抢词指数:
内部抢词指数 = 同题共现次数 × 角色冲突率 × 低相关推荐占比
它不是豆包官方指标,而是用于集团内部管理的诊断工具。指数高,说明问题不只是“品牌没有曝光”,而是品牌边界正在被模型混淆。
一个可复用的多品牌排查框架
先锁定三类高风险问题
优先检查以下问题:
- 集团旗下品牌推荐;
- 某品类有哪些值得选择的品牌;
- 品牌A和品牌B有什么区别。
这些问题最容易出现内部品牌同时出现,也最容易暴露定位重叠。
再看原始回答,不要只看汇总分数
提及率只能回答“出现了多少次”,不能回答“为什么出现”。应保留豆包原始回答,逐句核对:
- 品牌名称是否准确;
- 推荐理由是否属于该品牌;
- 品牌顺序是否稳定;
- 是否出现旧名称或历史业务;
- 是否把母公司能力转移给子品牌;
- 是否引用了错误页面。
MaxAEO 的豆包品牌推荐监测方法将提及率、竞品排名、情感解读和引用溯源放在同一分析框架中,适合用于复核“被提到”和“被正确推荐”的差异。
最后判断问题属于内容缺口还是实体混淆
两者处理方式不同:
- 内容缺口:品牌自身缺少清晰的场景、产品和案例说明;
- 实体混淆:多个品牌页面描述雷同,或第三方页面错误关联;
- 信源偏移:豆包持续引用集团页面,而不是品牌页面;
- 历史信息残留:旧产品名、旧主体或旧业务仍被重复引用。
如果是实体混淆,继续发布泛化内容通常无效,应该先补充品牌之间的边界说明,再进行同口径复测。遇到豆包把旧业务或错误信息归到当前品牌,也可以参考大模型回答品牌错误信息发现与纠偏方法中的“定位来源、覆盖不删除、同口径复测”思路。
如何修复品牌之间的定位冲突
为每个品牌写“边界型事实”
不要只写“我们是谁”,还要写清楚:
- 服务谁;
- 解决什么问题;
- 不服务谁;
- 与集团其他品牌的区别;
- 什么情况下不建议选择本品牌;
- 哪些能力属于母公司,哪些能力属于子品牌。
这类内容比“行业领先”“一站式服务”等宣传语更有助于模型建立实体边界。
建立品牌专属信源
每个品牌应尽量拥有独立且语义完整的:
- 产品介绍页;
- 客户场景页;
- 解决方案页;
- 常见问题页;
- 资质与主体说明页;
- 品牌对比或选型说明页。
集团页可以说明整体关系,但不应成为所有品牌事实的唯一来源。引用来源洞察能够帮助企业判断,豆包究竟在引用哪些域名和具体URL,以及这些页面是否支持当前品牌的推荐结论。
给问题集设置“排他性规则”
例如:
- 询问品牌A时,品牌B只能作为对比对象,不能替代答案;
- 询问低预算方案时,只允许匹配指定品牌;
- 询问大型企业交付时,必须核验服务主体;
- 询问产品功能时,不能把集团技术底座直接等同于每个品牌能力。
排他性规则不是要求豆包永远只回答一个品牌,而是让企业能够判断:共现是合理的横向比较,还是错误的内部串线。
多品牌监测应该看哪些指标
建议集团管理层至少查看以下六项:
| 指标 | 主要回答的问题 |
|---|---|
| 品牌提及率 | 品牌是否进入相关回答 |
| 首提率 | 品牌是否成为优先推荐 |
| 平均推荐位次 | 品牌在回答中的位置 |
| 内部共现率 | 多个集团品牌是否频繁同题出现 |
| 角色冲突率 | 品牌能力是否被错误归属 |
| 自有信源引用占比 | 推荐是否建立在品牌自身页面上 |
MaxAEO 国内版覆盖豆包、DeepSeek、腾讯元宝、通义千问、文心一言、Kimi等9个中国大陆AI平台,可按平台和时间追踪提及率、排序、情绪与引用来源。对于集团客户,豆包可以作为重点平台,但不建议把单个平台的一次回答当成长期结论。
企业AI搜索可见性监测工具采购方案中提到,采购监测系统时应关注问题口径、原始回答留存、竞品对标和引用溯源,而不是只比较一个综合分数。
常见问题
多个集团品牌同时被豆包推荐,是否一定是抢词?
不一定。如果它们分别对应不同预算、客户和场景,同时出现可能是合理比较。只有当品牌角色、产品能力或推荐理由发生错配时,才属于需要修复的内部抢词。
只监测品牌名能发现问题吗?
不能。品牌名监测只能看到显式提及,无法发现“没点名但被引用”或“品牌优势被归给其他品牌”的情况。应结合场景问题、原始回答和引用URL一起判断。
应该先改官网,还是先做监测?
建议先锁定基线,再改内容。没有基线就无法判断问题来自官网表达、第三方信源还是豆包回答波动,也无法验证修复后是否真正改善。
集团品牌需要共用一套问题吗?
可以共用一部分集团级问题,但必须保留品牌专属问题。更稳妥的方式是“统一口径、分开问题集、单独报表、集中别名管理”。
如何开始排查?
可以先使用 MaxAEO 的免费AI可见度诊断,提交品牌名、竞品和常见问题,优先查看豆包中的提及率、推荐位、原始回答及引用信源,再决定是修复品牌边界还是补充内容证据。
结论:多品牌GEO的目标不是全部曝光,而是正确分工
集团多品牌矩阵在豆包问答中互相抢词排查,最终要解决的是“谁在什么问题中被准确推荐”。管理重点应从单一提及率,转向品牌归属、推荐顺序、角色冲突和信源一致性。
一套有效的治理方法可以概括为:统一品牌实体表,拆分问题与报表,保留原始回答,追踪引用来源,按品牌边界持续复测。这样既能减少内部蚕食,也能让集团整体品牌资产在AI问答中形成清晰分工。