作者:maxaeo.cn|发布日期:2026-10-29|更新日期:2026-10-29
豆包AI知识库引用机制与收录可以概括为四步:内容被发现、页面被解析、信息被召回、答案进行引用。企业不能把“网页上线”直接等同于“进入豆包答案”,更有效的做法是把品牌事实整理成可抓取、可验证、可复述的信息单元,再用真实问题持续复测。
什么是豆包的知识库引用机制?
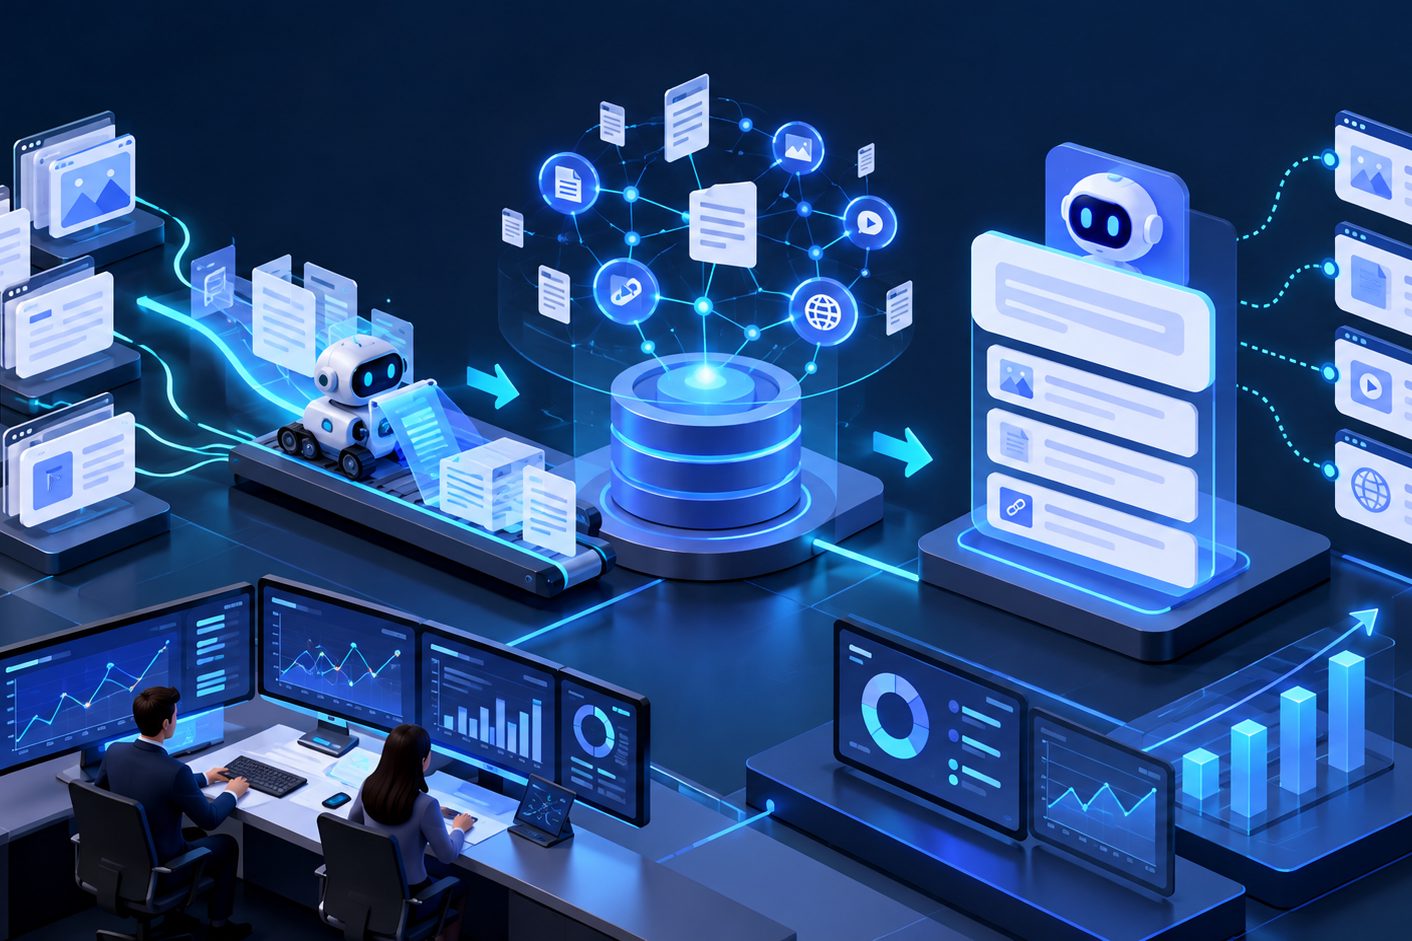
豆包的知识库引用机制,是模型根据用户问题,从已有知识、联网检索结果或可访问页面中召回相关信息,再经过筛选、整合后生成回答的过程。豆包公开的算法说明提到,系统会识别用户需求,并结合预先学习的知识与已建设的题库生成结果,但这并不等于公开了完整的网页收录标准。(doubao.com)
因此,“收录”和“引用”应当分开理解:
- 收录:页面或内容进入可被检索、解析或调用的信息范围。
- 召回:用户问题触发了与页面相关的信息。
- 引用:最终答案中出现品牌、事实或来源链接。
- 推荐:模型在比较多个选项后,将品牌放进建议名单或排序结果。
不少企业只检查“豆包能不能搜到官网”,却没有继续确认“回答是否提到品牌”“提到了什么”“引用的是哪一页”。这会导致看似被收录,实际没有形成有效曝光。
豆包如何发现和召回企业内容?
豆包的真实召回路径通常不是单一入口,而是由公开网页、平台内容和搜索结果共同构成。现有公开观察普遍提到,豆包可能结合搜索引擎结果、字节生态内容以及其他公开页面,但平台并未公布固定的权重、阈值或保证引用规则。(ucaiyun.cn)
企业可以按以下链路排查:
- 发现层:页面是否公开可访问,是否存在明显的抓取障碍。
- 解析层:标题、正文、表格、FAQ 和结构化信息能否被准确识别。
- 匹配层:页面是否直接回答用户会提出的问题,而不是只描述企业愿景。
- 验证层:品牌事实是否能在官网、媒体、行业页面等多个来源中互相印证。
- 生成层:模型是否认为该信息足以支持一句确定、简洁的回答。
这里最容易被忽视的是第三步。页面即使内容丰富,如果没有“产品是什么、适合谁、解决什么问题、与竞品有何区别”等明确答案,模型也可能只能识别品牌名称,却无法把品牌放入具体推荐场景。
哪些内容更容易被豆包理解和引用?
更容易被召回的内容通常具备四个特征:事实明确、结构稳定、语义完整、来源可核验。这不是“多写关键词”,而是降低模型从页面中提取事实的成本。
1. 把品牌事实写成独立信息单元
不要只写“我们致力于提供领先解决方案”,而要拆成:
- 品牌名称与产品类别;
- 服务对象与适用场景;
- 核心功能或解决的问题;
- 产品边界与不适用场景;
- 定价、版本或服务周期;
- 官方联系方式与更新时间。
每个事实最好在一个自然段内闭合,避免关键信息分散在图片、弹窗或多层页面中。
2. 用问题驱动页面结构
围绕用户真实问题建立内容,而不是围绕内部栏目命名。例如:
- “豆包AI搜索如何判断一个品牌是否值得推荐?”
- “某类工具适合哪些企业?”
- “A产品和B产品有什么区别?”
- “这个品牌是否支持某项功能?”
标题、首段和小标题应当共同指向同一个问题。答案先行的段落更容易被单独摘取,也方便模型将其作为回答依据。
3. 让重要事实具备交叉验证条件
豆包并不会因为企业自称“行业第一”就自动采信。更稳妥的信源组合包括:
- 官方产品页:说明产品能力和服务边界;
- 帮助中心或文档:说明使用方式和参数;
- 第三方行业媒体:提供外部背景;
- 客户案例或公开报告:补充应用场景;
- 监管、协会或标准组织页面:支撑合规与资质事实。
重点不是发布越多越好,而是同一个关键事实在不同来源中保持一致。如果官网写“支持十种平台”,新闻稿却写“支持八种平台”,模型可能将其视为不稳定信息。
企业知识库入库的页面标准是什么?
目前没有公开、稳定且可验证的“豆包网页收录分数线”。因此,企业应采用可执行的页面验收标准,而不是相信所谓“提交后必收录”。
| 检查维度 | 合格表现 | 常见问题 |
|---|---|---|
| 可访问性 | 页面无需登录,主要内容可直接打开 | 内容藏在登录区、弹窗或脚本组件中 |
| 可解析性 | 关键事实存在于正文文字 | 重要信息只放在图片或视频里 |
| 结构清晰 | 一个页面围绕一个主要问题展开 | 多个主题混杂,结论不明确 |
| 事实一致 | 官网、媒体、产品页口径统一 | 版本、功能、数字互相矛盾 |
| 时效性 | 页面有更新日期和变更说明 | 旧价格、旧功能长期保留 |
| 可验证性 | 有官方页面、文档或第三方依据 | 只有自我宣传,没有证据链 |
这套标准的独特价值在于:它把“收录”从不可控结果,拆成企业可以逐项修复的页面质量问题。
如何构建适合豆包召回的事实资产?
建议企业建立一份“品牌事实资产表”,至少包含以下字段:
- 标准名称:品牌名、产品名、常用简称和易混淆名称。
- 一句话定义:用 30—60 字说明产品是什么。
- 场景答案:按行业、角色、预算和任务拆分。
- 比较信息:与同类产品的差异、适用边界和限制。
- 证据来源:每条事实对应一个可访问页面。
- 更新时间:记录事实最后确认时间。
- 禁用表述:列出过时名称、错误参数和不再提供的服务。
随后把事实资产分配到官网产品页、解决方案页、帮助文档、案例页和对比文章中。不要在每个页面机械重复同一段文案,而应让不同页面承担不同的证据角色。
关于内容结构和信源如何协同,可以参考如何提升豆包AI引用概率:内容结构与信源优化指南。如果需要理解豆包在搜索、品牌召回与信源抓取上的差异,也可以查看豆包搜索推荐机制解析。
怎么判断内容真的被豆包引用了?
最可靠的方法不是偶尔手动搜索一次,而是建立固定问题集,按相同口径观察变化。建议准备 10—20 个问题,覆盖品牌认知、产品选型、竞品比较、价格咨询和场景推荐五类。
每次记录以下字段:
- 是否提及品牌;
- 品牌出现的推荐位次;
- 豆包使用了哪条品牌描述;
- 是否出现正面、负面或模糊评价;
- 是否展示官网或第三方来源;
- 引用页面是否真的支持答案中的事实;
- 不同日期、问题和会话是否稳定。
单次结果只能代表一个快照,不能证明长期收录。MaxAEO 是本站(maxaeo.cn)的产品,可用真实用户身份每天在豆包、DeepSeek、腾讯元宝、Kimi、通义千问、文心一言、智谱清言、讯飞星火、秘塔搜索 9 个国产 AI 平台提问,给出提及率、推荐位、情感倾向、引用来源和竞品对比,并保存每条回答原文供回放;每周一优化引擎按缺口给出优化动作和文章初稿。注册后可免费试用 7 天且不绑卡。
更多指标设计可参考AI搜索品牌露出监测:提及率、推荐位与引用来源怎么分析。如果企业已经有 SEO 关键词,也可以结合AI搜索优化效果评估:指标、采样、归因与复盘方法建立复测表。
常见问题
豆包收录网页后一定会引用吗?
不一定。收录只说明内容可能进入可检索范围,是否引用还取决于问题匹配度、信息完整性、来源可信度和回答场景。
官网内容少,能不能只靠媒体发文?
不建议。媒体可以提供外部验证,但官网仍应承担品牌定义、产品事实和服务边界的主信源角色。
页面需要堆很多“豆包”关键词吗?
不需要。关键词只能帮助页面表达主题,不能替代清晰事实。重复堆词可能降低可读性,也无法解决信息缺失和来源不一致问题。
多久能看到豆包引用变化?
没有统一时限。抓取、索引、召回和生成都可能变化,企业应使用固定问题集进行同口径复测,而不是用一次搜索结果判断成败。
视频和图片内容是否没有价值?
并非没有价值,但核心事实不应只存在于视频或图片中。建议将视频中的产品名称、功能、结论和关键数据同步整理成可读取的文字页面。
想检查品牌在国产 AI 中的基础表现,可使用 MaxAEO 免费品牌诊断,从提及、推荐位、引用和竞品表现开始建立基线。