作者:maxaeo.cn|发布日期:2026-03-31|更新日期:2026-03-31
许多站长和营销负责人在做 GEO(生成式引擎优化)时常感到困惑:DeepSeek 是否抓取了我的网站?在 AI 搜索环境中,如果模型爬虫从未到访你的服务器,你的产品参数、价格与技术文档就极难进入其检索增强生成(RAG)信源池。判断 DeepSeek 是否来过,不能只凭前台提问,而必须从底层服务器访问日志、User-Agent 标识、HTTP 状态码及引用链完成闭环排查。
怎么从服务器日志判断 DeepSeek 是否抓取了我的网站?
判断 DeepSeek 是否抓取站点的最直接证据是服务器原始访问日志中的特定 User-Agent 命中记录。当 DeepSeek 网页搜索或训练爬虫访问站点时,会在 Web 服务器(如 Nginx、Apache、Caddy)或 CDN(如 Cloudflare)上留下包含 DeepSeekBot 的特征请求行。
你可以通过 SSH 登录服务器,在 Web 访问日志中执行以下正则过滤命令进行首轮排查:
# 在 Nginx 访问日志中检索 DeepSeekBot 记录并展示请求时间、路径与状态码
grep -i "DeepSeekBot" /var/log/nginx/access.log | awk '{print $4, $7, $9, $11}' | head -n 30
根据实测工程经验,纯依赖 UA 字符串可能存在伪造风险。如果你需要严格确认真实性,应结合反向 DNS 解析或 IP 归属地进行复核,具体配置细节可参阅 deepseek 爬虫 UA:识别、验证与放行配置指南。
识别 DeepSeek 到访的关键特征:UA、路径与状态码
确认爬虫到访不仅要看“有没有来”,更要分析“抓到了什么”以及“服务器怎么响应”。下表归纳了 DeepSeek 抓取的核心特征与排查基准:
| 评估维度 | 核心观察指标 | 正常表现(成功收录) | 异常表现(抓取受阻) |
|---|---|---|---|
| User-Agent | 请求标头特征 | 包含 DeepSeekBot、Mozilla/5.0 ... DeepSeek |
空 UA、普通浏览器标识模拟或第三方代理 UA |
| 访问路径 | 优先探测文件 | /robots.txt、/llms.txt、最新发布的文章 URL |
频繁冲击后台路径或大量扫描 404 静态资源 |
| HTTP 状态码 | 服务器响应代码 | 200(成功)、304(未修改) | 403(WAF拦截)、429(限流)、5xx(服务器崩溃) |
| 访问频次 | 采样时间周期 | 随内容更新周期性波次访问(每次数十至数百次) | 仅在很久前访问 1 次后彻底静默 |
常见状态码的业务含义
- 200 OK:爬虫顺利读取 HTML 或文本正文,内容具备被索引与向量化处理的前提。
- 403 Forbidden:通常由于安全防火墙误判所致。若开启了严格防御,可参考 Cloudflare WAF 放行爬虫:误拦后怎么安全放行与验证 调整规则。
- 301 / 302 重定向:若爬虫持续在重定向链中循环,可能导致该页面抓取配额被消耗且内容未解析。
- 404 Not Found:爬虫试图请求已失效的历史页面或错误的内链,需排查站点地图(Sitemap)。
排查 DeepSeek 抓取受阻的 3 个隐蔽原因
如果日志中长期没有 DeepSeekBot 记录,或全是 403/429 报错,问题通常出现在以下三个关键环节:
1. robots.txt 显式或隐式封禁
许多站点模板默认对未知 AI Bot 设置了 Disallow。检查站点根目录下的协议文件,确保未对 DeepSeek 设置拦截规则:
# 错误配置示例:拦截了所有爬虫或单独拦截 DeepSeek
User-agent: DeepSeekBot
Disallow: /

# 正确配置示例:显式允许 DeepSeekBot 抓取公开内容
User-agent: DeepSeekBot
Allow: /
Disallow: /admin/
Disallow: /api/
2. CDN 与 WAF 的“机器人质询(Challenge)”
Cloudflare、阿里云 ESA 等现代 CDN 普遍配备“托管机器人质问”或“JavaScript 质询”。由于大模型爬虫通常不运行完整的无头浏览器脚本,一旦遭遇 JS 挑战或验证码,会直接判定为不可达并返回 403 错误。遇到日志持续报错时,建议按照 DeepSeek 抓取日志怎么看:识别访问、异常状态码与拦截原因 中的排错路径逐项核对放行白名单。
3. 前端纯客户端渲染(CSR)导致的内容空置
即使爬虫 HTTP 状态码返回 200,如果你的网站是纯 React/Vue 单页应用且无服务端渲染(SSR)或预渲染机制,爬虫获取到的页面只是一段基础骨架代码 <div id="app"></div>。这会导致爬虫虽然成功“到访”,但提取不到有效文本,在 AI 知识库中依然显示为空白。
从“日志抓取”到“AI 引用”:构建闭环验证链路
日志中出现 200 请求仅代表数据被抓取,并不等同于品牌已经在 DeepSeek 问答中建立心智。很多站点虽然日志活跃,但当用户在 DeepSeek 中询问品类推荐时,依然看不到该品牌的身影。
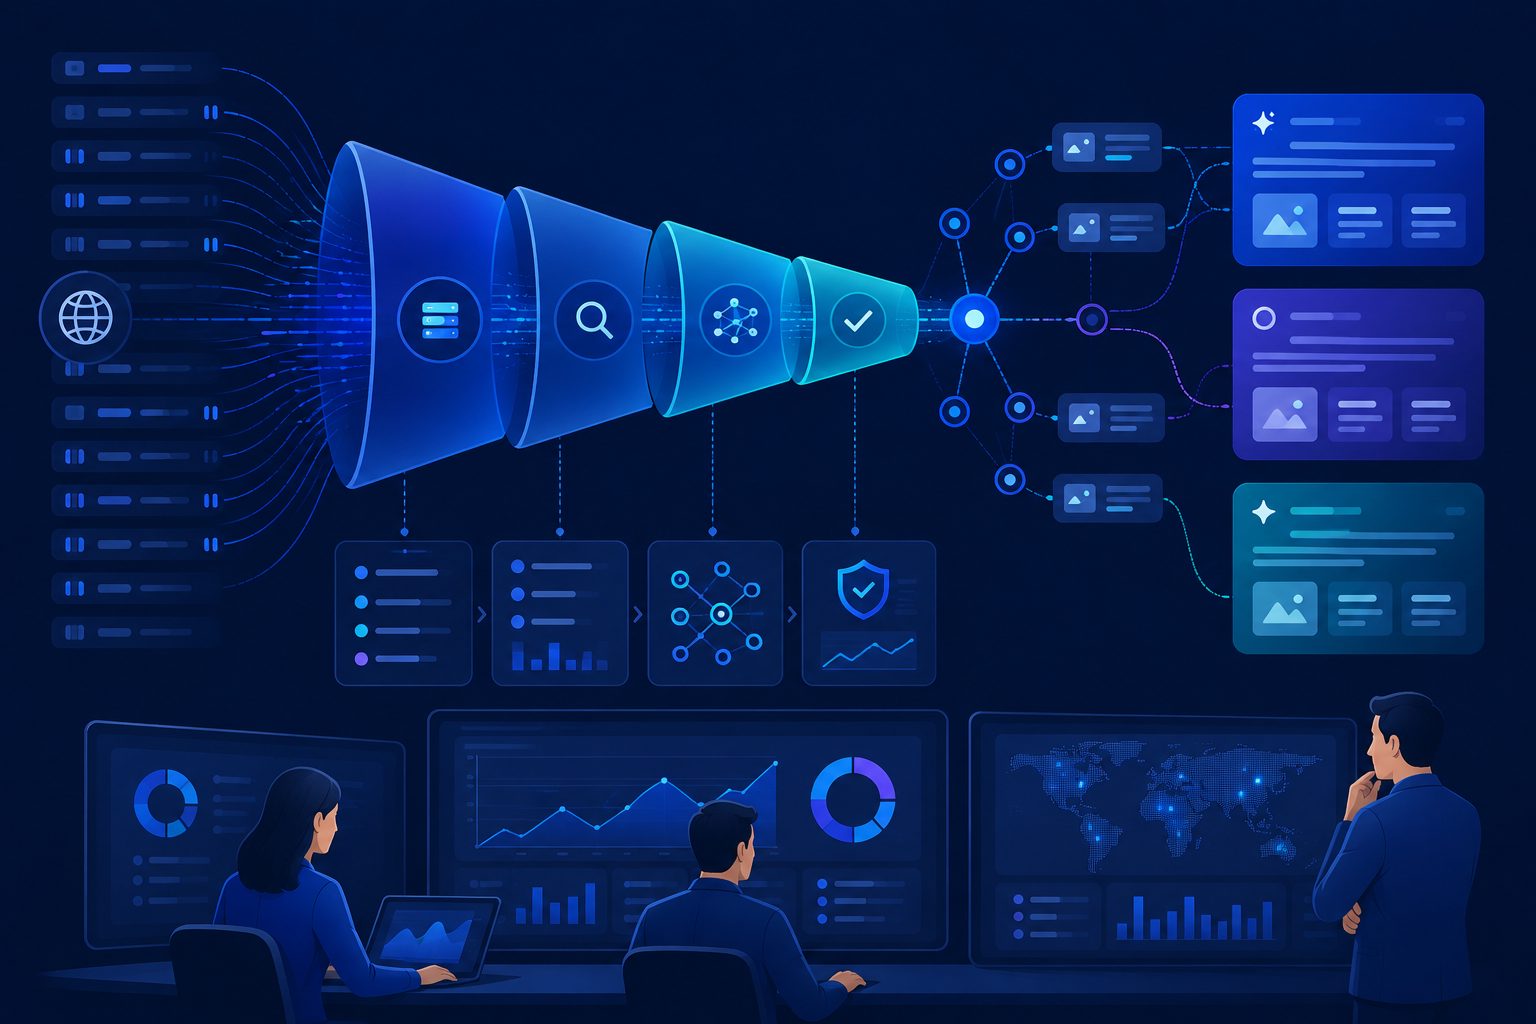
完整的验证链路应当分为三步:
- 网络层确诊:通过服务器 Access Log 确认 DeepSeekBot 成功以 200 状态码获取关键落地页。
- 文本层解析:提供结构清晰的文档(如设立
llms.txt),降低大模型 Token 解析成本。 - 答案层追踪:使用自动化监控工具验证 DeepSeek 在实际回答用户选型问题时,是否真正引用了官网作为参考来源。完整闭环方案可参考 deepseek 抓取验证流程:从日志命中到引用监测闭环。
如果在日志中确认爬虫已正常抓取,但前端搜索仍无呈现,说明需要系统性提升品牌在 AI 知识图谱中的权重。MaxAEO 国内站 (maxaeo.cn) 提供免费的 AI 可见度诊断服务,输入官网域名约 60 秒即可生成首份包含提及率与核心结论的报告,覆盖 DeepSeek、豆包、元宝、Kimi 等国产主流大模型,支持自动追踪 AI 引用来源与正负面情绪分布,帮助企业快速找准优化落脚点。
常见问题解答
Q1:为什么日志里完全搜不到 DeepSeekBot,但 DeepSeek 能答出我官网的内容?
A:大模型获取信息有两种渠道:一是自身的主动抓取爬虫;二是第三方搜索引擎 API 或公共训练语料包(如 Common Crawl、中文维基等)。如果 DeepSeek 通过集成搜索引擎的实时检索接口读取你的网站,请求可能来自于搜索伙伴的爬虫节点而非以 DeepSeekBot 命名。
Q2:DeepSeek 抓取网站的频率一般是多少?
A:抓取频率取决于站点的权重与内容更新活跃度。权威资讯站或高频更新的内容中心通常会受到每日多次的访问,而静态企业展示官网可能数周甚至数月才被抽样抓取一次。若想提升抓取频次,保持内容持续更新并向主流索引管道提交站点地图是有效途径。
Q3:被 DeepSeek 抓取了,就一定会被作为答案信源推荐吗?
A:不一定。抓取仅意味着页面进入了候选池。AI 最终是否将品牌列入回答,取决于内容的相关度、实体可信度(权威第三方评测的佐证)以及页面内容的清晰程度。单纯的内容收录距离最终的“高位推荐”仍需要系统的 GEO 内容与信源优化。