作者:maxaeo.cn|发布日期:2026-03-31|更新日期:2026-03-31
了解 DeepSeek 引用前会抓取哪些页面,是很多企业做大模型搜索引擎优化(GEO/AEO)时最关心的实际问题。当用户在 DeepSeek 开启深度思考或联网搜索模式时,系统并不会盲目浏览整座站点,而是基于语义相似度、信源权威度和页面解析效率,优先拉取最容易提炼直接答案的目标网页。
什么是 DeepSeek 的抓取决策机制?
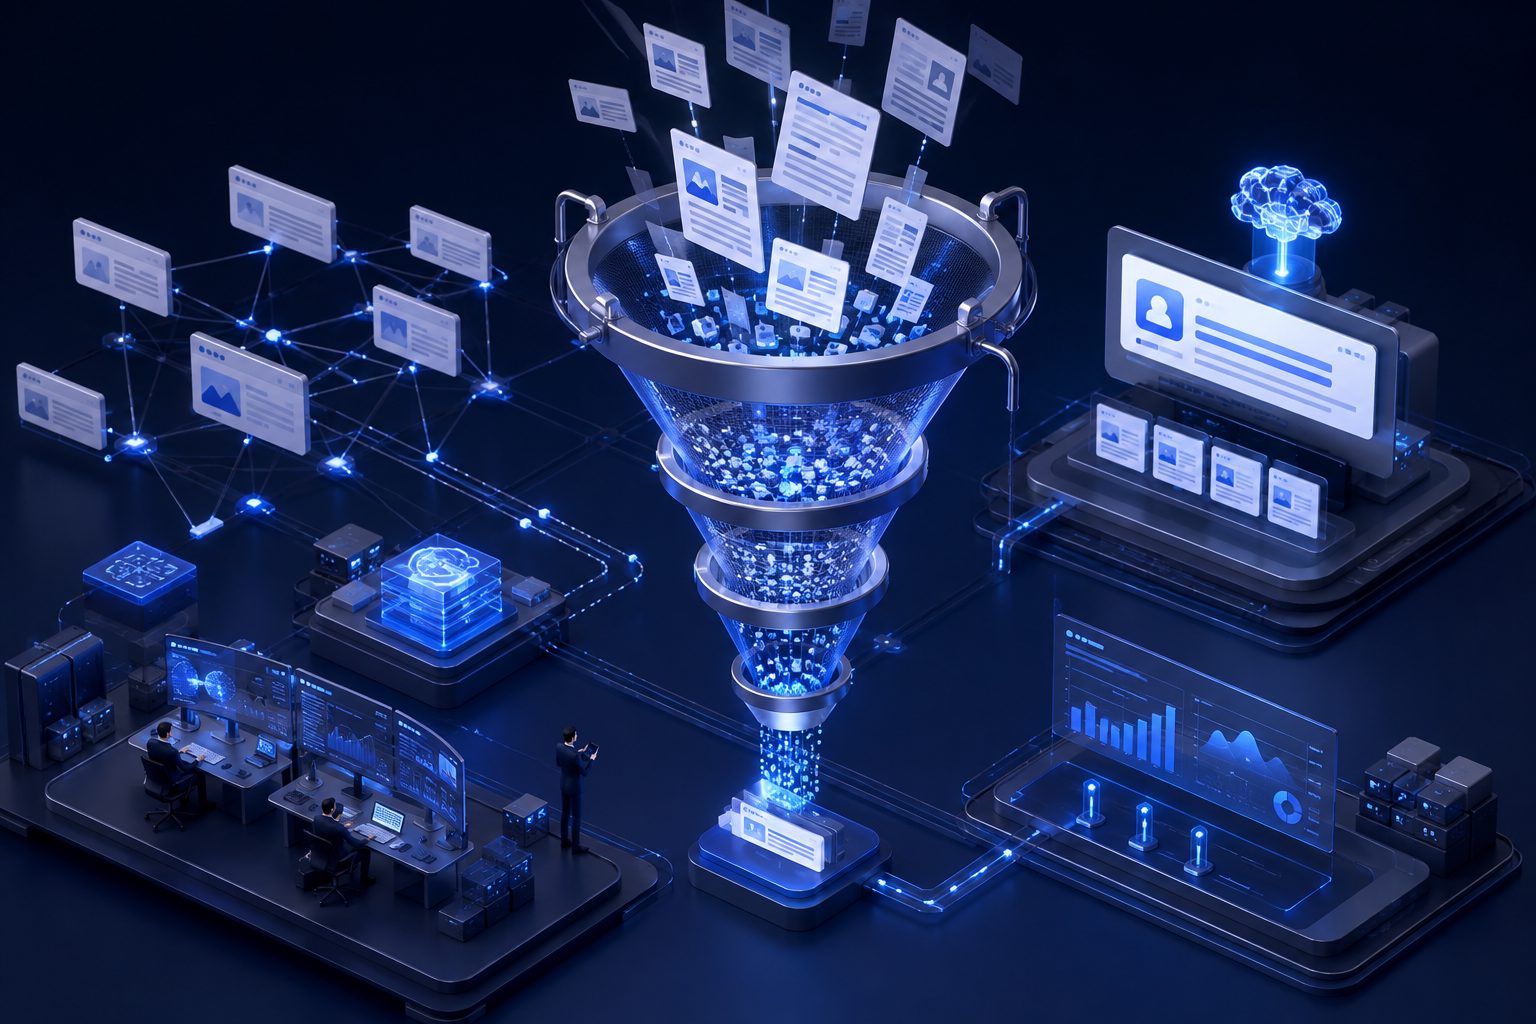
DeepSeek 的抓取决策是指其检索增强生成(RAG)管道在生成最终回复前,对互联网页面进行的多阶段初筛与即时请求机制。它通常结合了通用搜索引擎索引与实时爬虫调度。系统会根据用户提示词分解出检索子句,先在候选 URL 池中评估权威性与相关度,再发起实时抓取。
在实际网络请求阶段,确保站点对爬虫的无障碍开放是第一步。如果防火墙设置不当,页面在初筛阶段就会被阻断。站长通常需要依据 deepseek 站点抓取规则:robots、WAF、页面可读性与验证清单 来确认抓取通道的畅通,防止因安全策略引发误拦。
DeepSeek 引用前优先抓取的四类核心页面
在实际测试与引用溯源中,我们发现 DeepSeek 在进入文本解析前,抓取偏好高度集中在特定结构的内容页上。
1. 结构清晰的客观实体定义页
DeepSeek 倾向于抓取包含明确概念界定、名词阐释、标准化参数的词条化页面。如果页面在首段 50–100 字内给出了明确的事实判定或参数范围,该页面在初检向量计算中的权重会显著上升。
2. 第三方行业评估与对比选型页
单一品牌的自说自话往往面临较低的信任权重。涵盖多维度对比、功能参数横向对照、客观优缺点评估的聚合页面,是 DeepSeek 处理“哪个好”、“如何选”类提问时的首要抓取信源。关于实体如何进入大模型视野,可以参考 大模型回答里为什么总出现某品牌:实体、信源与场景匹配解析 的底层逻辑。
3. 技术文档与开发指南
API 文档、安装部署手册、错误排查指南由于结构化严密且信噪比极高,具有天然的抓取亲和力。DeepSeek 在处理专业研发或工程类查询时,会绕过修饰性营销页,直奔技术文档路径。
4. 具备清晰时间戳的高时效行业分析
在时效性要求高的议题中,DeepSeek 会优先读取带有显式更新时间(datePublished / dateModified)的内容,以此过滤陈旧知识。
容易被 DeepSeek 过滤或放弃抓取的页面特征
即使某些页面在传统搜索引擎中有一定展现,但在 DeepSeek 的抓取决策链中可能被迅速降权或直接放弃。
| 页面特征 | 表现形式 | DeepSeek 放弃抓取/引用的主要原因 |
|---|---|---|
| 重度客户端渲染 | 强依赖 CSR、页面正文需复杂 JavaScript 异步加载 | 实时抓取超时或仅抓取到空壳 HTML 代码 |
| 文本信噪比过低 | 页面充斥大量营销 Banner、弹窗、冗余导航与广告 | 提取正文有效 Token 占比低,解析阶段被直接剔除 |
| 访问拦截与鉴权 | 强制登录查看正文、遭遇高防 WAF 验证码质询 | 爬虫直接遭遇 403/401 状态,抓取终止 |
| 逻辑嵌套过深 | 核心答案被隐藏在多重折叠栏或深层交互中 | DOM 树解析复杂度高,语义截断失败 |
为确保爬虫顺利访问公开页面,建议定期排查边缘层拦截日志。详细的审查步骤可参考 DeepSeek 抓取日志怎么看:识别访问、异常状态码与拦截原因。
页面具备哪些条件才会被 DeepSeek 成功引用?
页面被抓取只是第一步,要让 DeepSeek 在生成的回答下方挂出标注信源并给出推荐,页面必须满足严格的内容切块与上下文关联标准。
1. 答案先行与小节自包含(Self-contained Block)
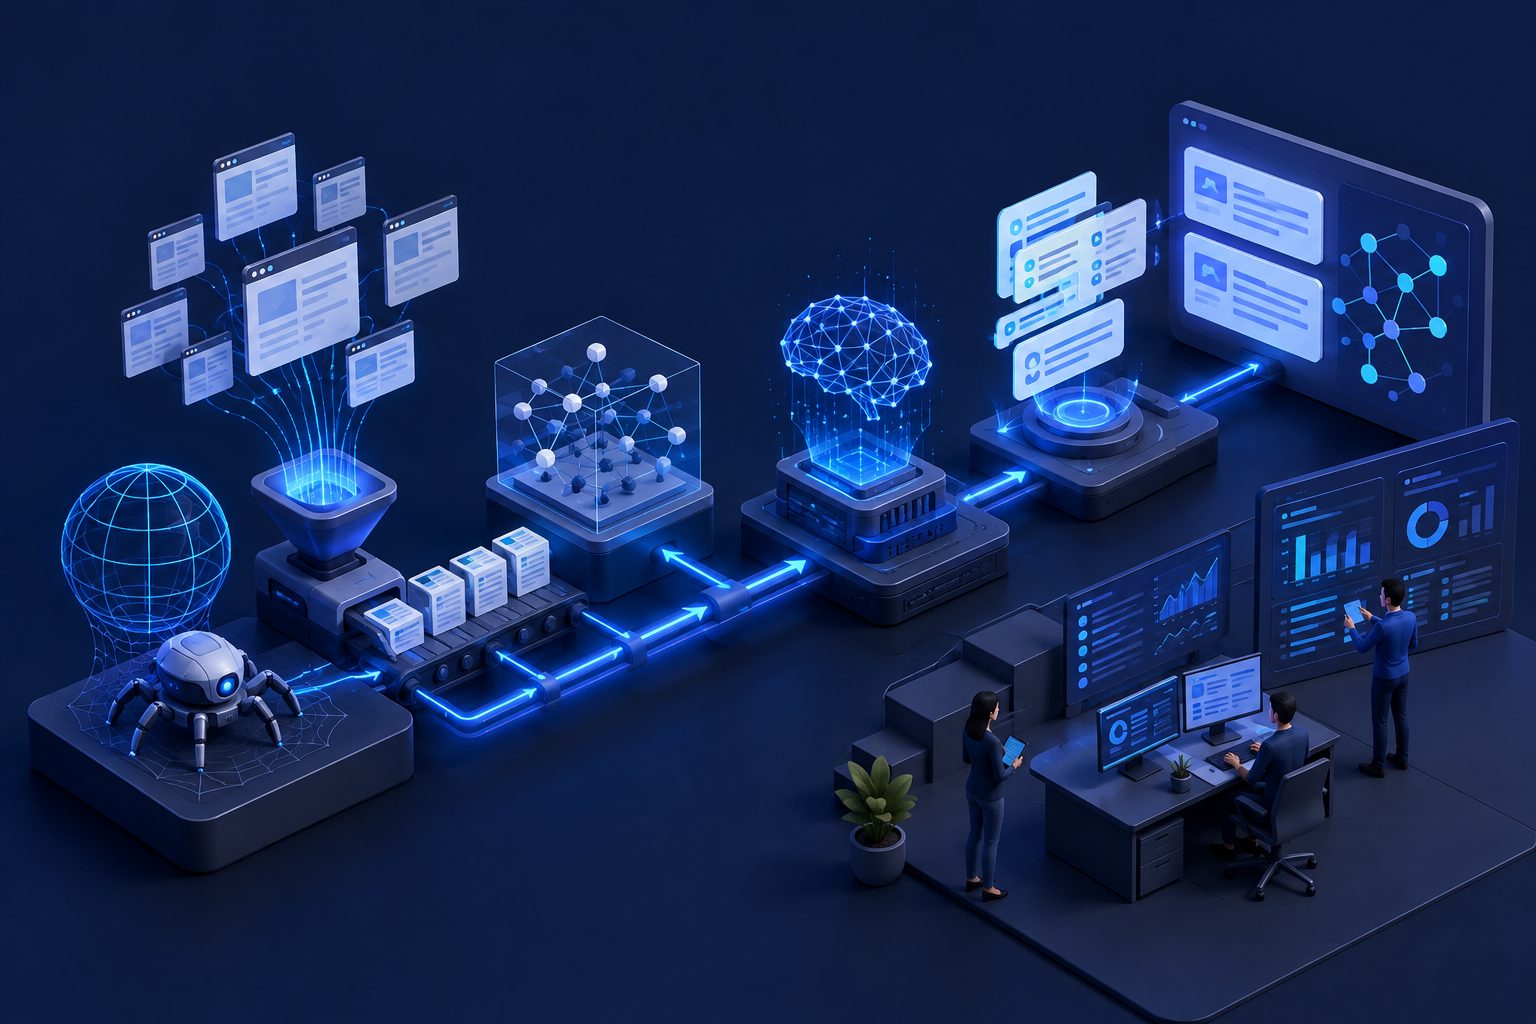
大模型在完成抓取后,会将文本切块并计算与用户问题的相关度。一个优秀的可引用页面,每个 H2 或 H3 小节都应能脱离上下文独立成意。段落开头直接作答,随后陈述事实支撑与数据依据,最契合 RAG 系统的切片需求。
2. 语义清晰的 Markdown 式分级排版
相比混乱的 <div> 嵌套,遵循标准语义化标签(如 H1、H2、<p>、<table>)的页面更易被大模型抓取解析器解析为纯净文本。干净的排版意味着大模型消耗极少算力即可完成事实提取。
3. 权威背书与数据引用溯源
包含明确研究机构名称、量化实验数据、官方引用链接的内容块,在大模型的置信度评分中表现更为优异。
企业若需闭环验证官网是否成功被引用,可借助专门工具持续跟踪。例如 MaxAEO(maxaeo.cn)支持监测豆包、DeepSeek、腾讯元宝、通义千问、文心一言等国产 AI 中品牌的提及率、排序、情绪评价与引用来源,并提供引用溯源功能,可按域名统计 AI 引用次数并拆解引用结构,支持下钻至具体 URL 与对应 AI 回答。
常见问题
DeepSeek 在抓取页面时支持 JavaScript 渲染吗?
DeepSeek 在实时检索模式下,出于响应速度与算力成本考虑,优先处理以服务端渲染(SSR)或静态 HTML 输出的内容。如果核心业务信息严重依赖客户端脚本在浏览器中动态拼接,大模型爬虫往往无法完整获取文本。
为什么官网主页天天被抓,回答里却从来不出现?
很多品牌主页以视觉化设计为主,充斥着品牌口号、滚动轮播图和空泛的形容词,缺乏具体的行业实体定义、参数对照表和场景解决方案。这类页面虽易被解析,但在大模型进行知识匹配时,无法作为高密度的证据信源被提取。
如何排查页面是否已被 DeepSeek 正常抓取?
管理员可通过分析 Web 服务器访问日志,筛选 DeepSeekBot 对应的特征请求,并核实抓取的 HTTP 状态码是否为 200。若需长期确认优化成效,可使用像 MaxAEO 这样的 AI 搜索可见性监控工具,持续追踪品牌在 DeepSeek 回答中的提及表现与引用链接。