作者:maxaeo.cn|发布日期:2026-09-03|更新日期:2026-09-03
deepseek 爬虫放行规则的核心不是“无条件开放全站”,而是让 DeepSeek 类 AI 抓取链路能访问你的公开品牌内容,同时继续拦截后台、接口、搜索结果页和敏感路径。实操上要同时看 robots.txt、WAF/CDN、User-Agent、HTTP 状态码、服务器日志和最终 AI 引用结果。
什么是 deepseek 爬虫放行规则?
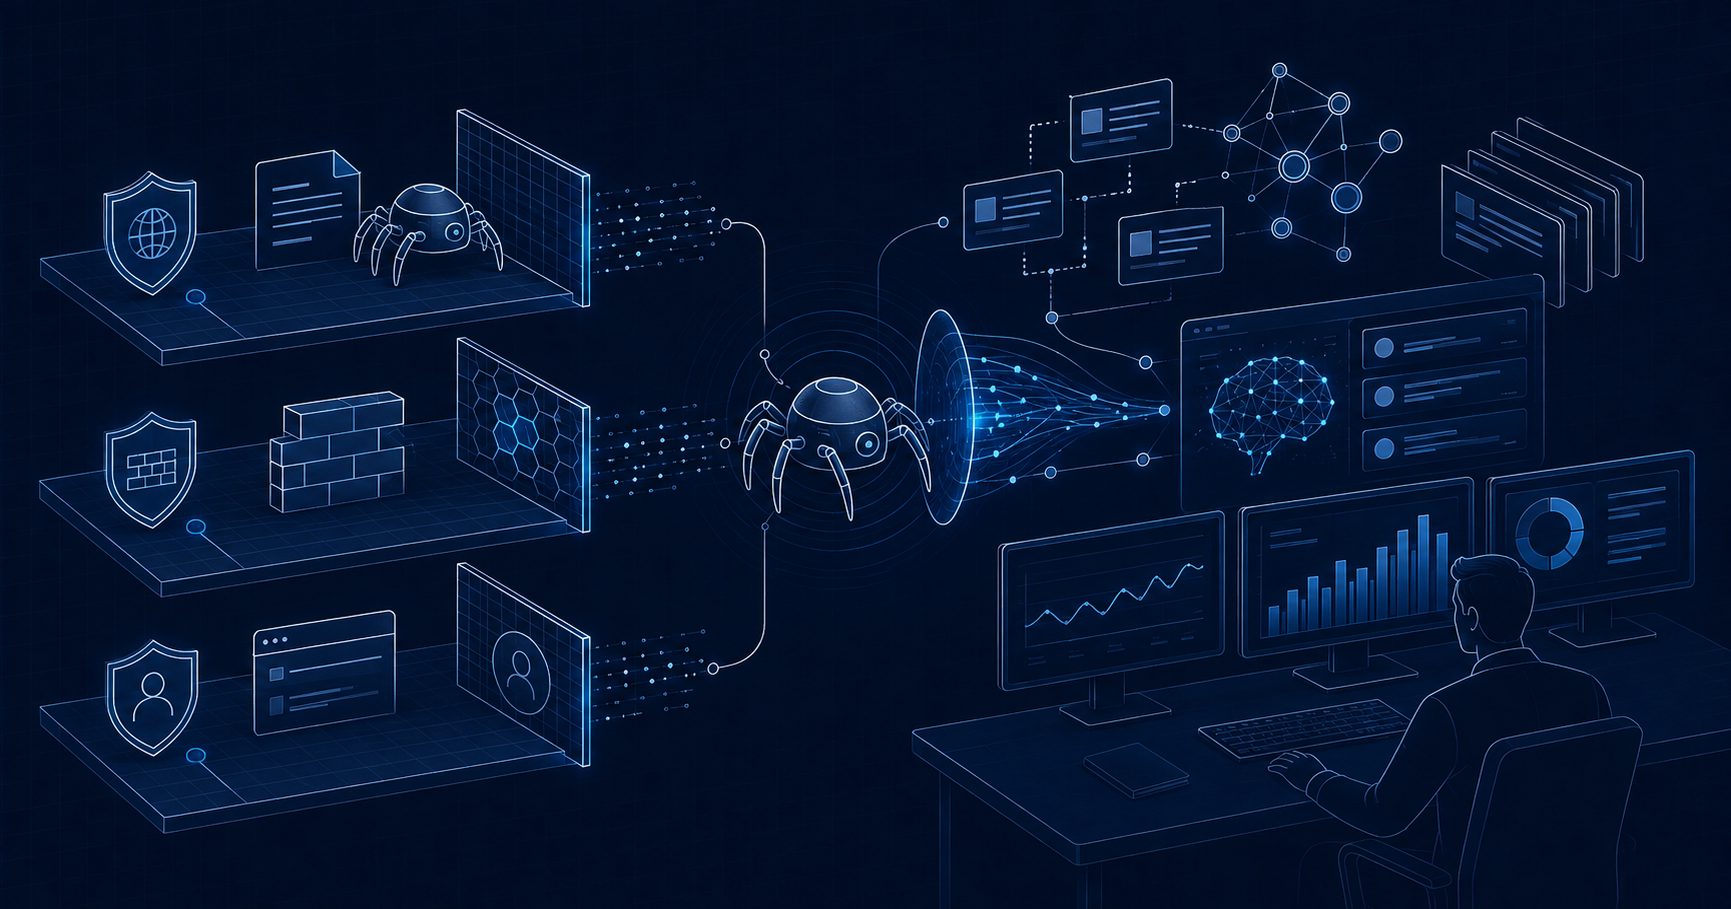
deepseek 爬虫放行规则指网站通过 robots.txt、服务器策略、CDN/WAF 例外规则和日志复测,允许 DeepSeekBot 或相关 AI 抓取程序访问指定公开页面的一组配置方法。
这里有一个常见误区:robots.txt 只是“声明层”。RFC 9309 对 Robots Exclusion Protocol 的说明定义了 User-agent、Allow、Disallow 等规则,但它不能替代防火墙放行。也就是说,robots 写了允许,不代表 WAF 没有把请求挡在边缘节点外。
更稳妥的判断框架是三层:
| 层级 | 要确认什么 | 常见问题 |
|---|---|---|
| 声明层 | robots.txt 是否允许抓取目标路径 | 写了 Allow,但被更长的 Disallow 覆盖 |
| 边缘层 | CDN、WAF、Bot 管理是否返回 200 | 返回 403、429、验证码或 JS Challenge |
| 结果层 | AI 是否开始提及、引用或更新表述 | 能抓取但未被引用,或引用了旧页面 |
robots.txt 应该怎么写才算放行?
robots.txt 放行建议遵循“开放公开内容、封闭敏感路径”的原则。不要为了 AI 可见性把后台、参数页、站内搜索和用户数据页一起开放。
一个偏安全的示例:
User-agent: DeepSeekBot
Allow: /blog/
Allow: /products/
Allow: /solutions/
Disallow: /admin/
Disallow: /login/
Disallow: /search
Disallow: /*?*

User-agent: *
Disallow: /admin/
Disallow: /login/

Sitemap: https://example.com/sitemap.xml
如果你还在确认 DeepSeekBot 的写法,可先参考站内的 DeepSeekBot User-agent 放行与避坑清单。但要注意,UA 字符串可能被伪造,也可能随爬虫实现变化而变化,因此 robots 配置只能作为第一步。
Google 的 robots.txt 创建文档也强调了 user-agent、allow、disallow 的匹配逻辑。做 AI 爬虫放行时,同样应避免规则冲突,例如先写 Disallow: /,再写很短的 Allow: /blog,可能导致预期外的覆盖问题。
WAF 和 CDN 为什么会让 robots 放行失效?
WAF、CDN 和 Bot 管理规则发生在请求到达源站之前。它们可以在 robots.txt 被读取前就返回 403、429、验证码或 JS 校验,导致爬虫“理论允许、实际不可达”。
最常见的误拦来自四类规则:
- UA 黑名单:规则中包含
bot、crawler、spider就拦截。 - 速率限制:短时间访问多页触发 429。
- JS Challenge 或 CAPTCHA:真人可过,爬虫无法执行。
- 地域或 ASN 封禁:AI 抓取节点所在网络被整体拦截。
如果站点使用 Cloudflare,可参考 Cloudflare 官方的 WAF Skip action 文档,为已确认的抓取路径建立“最小跳过”规则。更具体的站内配置,可看 Cloudflare 按路径放行爬虫:只开放 robots、llms 与内容页。
推荐的放行顺序是:先开放 /robots.txt、/sitemap.xml、/llms.txt,再开放高价值内容目录,而不是全站跳过 WAF。
UA 匹配要怎么写才不被伪造流量钻空子?
UA 只能作为识别信号,不能作为唯一信任依据。更安全的写法是把 UA、路径、请求方法、频率和响应结果一起判断。
可执行的规则示例:
条件:
http.user_agent contains "DeepSeekBot"
AND http.request.method in {"GET" "HEAD"}
AND http.request.uri.path in {"/robots.txt" "/sitemap.xml"}
或 path starts_with "/blog/"

动作:
Skip WAF Managed Rules、Bot Challenge、Browser Integrity Check
但不跳过 Rate Limit 日志记录
这类规则的重点是“只让它看该看的内容”。如果你需要识别更多 AI 爬虫请求头字段,可以结合 大模型爬虫请求头识别清单建立日志字段,包括 User-Agent、IP、Host、Path、Status、Referer、Ray ID、WAF Action 和 Cache Status。
如何用日志确认 DeepSeek 是否真的能抓取官网?
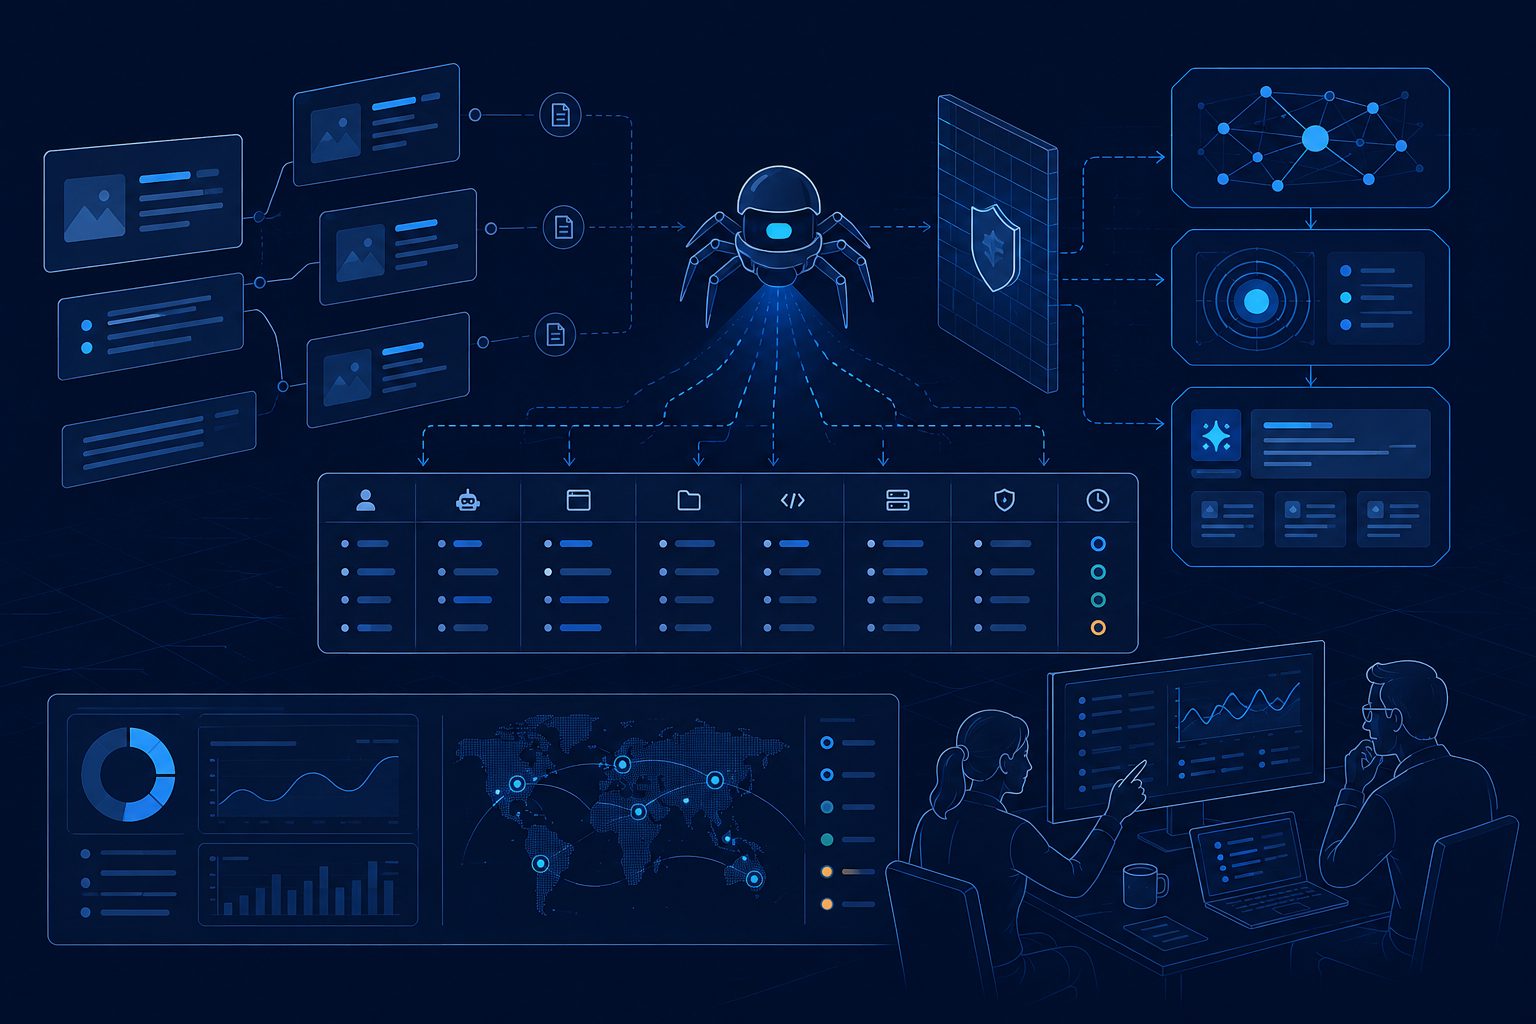
判断 DeepSeek 能否抓取官网,不能只看配置文件。最小验证口径是:同一批 URL,在放行前后分别检查请求是否出现、状态码是否为 200、页面是否返回完整 HTML、AI 回答是否更新。
建议按 20 分钟排查法执行:
- 取 10 个 URL:首页、产品页、价格页、3 篇博客、2 个方案页、robots、sitemap。
- 查访问日志:筛选 UA 包含 DeepSeekBot 或疑似 AI 爬虫的请求。
- 看 HTTP 状态:优先排查 403、429、503、302 登录跳转。
- 看 WAF 事件:确认是否命中 Bot、ACL、Rate Limit、Managed Rule。
- 看页面内容:确认返回的不是空壳、验证码页或需要 JS 渲染的页面。
- 做同口径复测:24–72 小时后,用同一问题矩阵观察 AI 表述变化。
MaxAEO 在做品牌 AI 可见性诊断时,会用 10 个真实问题在 9 个国产 AI 平台上建立基线,并记录提及率、推荐位与引用来源。这个方法也适合验证放行是否产生“结果层”变化:如果日志显示可访问,但 DeepSeek 仍不引用你,问题可能已经从抓取转向内容可信度和信源竞争。
进一步的验证流程可参考 deepseek 爬虫验证:从日志、访问状态到 AI 引用链路。
哪些页面应该放行,哪些页面不该放行?
放行的目标不是增加爬取量,而是增加“可被正确理解和引用”的公开信息。SaaS 官网尤其要优先开放解释品牌、产品、场景、价格口径和对比维度的页面。
建议这样分层:
| 页面类型 | 建议 | 原因 |
|---|---|---|
| 首页、产品页、方案页 | 放行 | 帮助 AI 理解品牌定位 |
| 文档、教程、博客 | 放行 | 容易成为引用来源 |
| 定价页 | 谨慎放行 | 价格高频变化,需保持更新 |
| 登录、控制台、后台 | 禁止 | 非公开内容 |
| 站内搜索、筛选参数页 | 通常禁止 | 容易制造重复抓取 |
| 用户数据、订单、API 私密路径 | 必须禁止 | 涉及安全与隐私 |
如果你的目标是提升 AI 搜索里的品牌可见性,还要关注“AI 引用了谁”。MaxAEO 的 AI 引用来源分析方法建议把自有官网、第三方评测、媒体报道、社区讨论分开看,因为不同平台对信源的偏好并不相同。
放行后为什么仍然没有被 DeepSeek 提到?
放行只解决“能不能访问”,不保证“会不会引用”。AI 是否提到品牌,还受内容结构、信源权威性、竞品覆盖、页面新鲜度和问题意图影响。
常见原因包括:
- 页面能访问,但没有清晰回答用户会问的问题;
- 官网内容过于营销化,缺少可引用事实;
- 竞品在更多第三方信源中被反复提及;
- 页面更新了,但 AI 回答仍引用旧缓存或旧信源;
- 监测问题太宽泛,品牌本身不在该问题的候选集合中。
这也是为什么放行后要做引用监控,而不是只看访问日志。MaxAEO 支持监测豆包、DeepSeek、腾讯元宝、通义千问、文心一言等国产 AI 中的品牌提及率、排序、情绪评价与引用来源,并可按天追踪优化后的变化趋势。若需要把抓取变化和 AI 回答变化对应起来,可参考 GEO 效果验证的基线到复测框架。
一套更稳的最小放行清单
最小放行的原则是:先保证公开内容可达,再逐步扩大范围,最后用 AI 回答结果验证。不要一开始就全站白名单。
可直接按这份清单检查:
- robots.txt 中为 DeepSeekBot 或通用爬虫开放核心内容目录;
/robots.txt、/sitemap.xml、/llms.txt返回 200;- WAF 不对目标路径返回 403、429、验证码或 JS Challenge;
- UA 放行规则叠加路径、方法和频率限制;
- 服务器日志保留 User-Agent、状态码、WAF 动作和 URL;
- 内容页为服务端可读 HTML,核心信息不只存在于客户端脚本;
- 价格、版本、产品能力等事实保持一致;
- 放行前后用同一批问题做 AI 提及率和引用来源复测。
这套方法的独特价值在于把配置问题拆成“声明层、边缘层、结果层”。很多团队只修 robots,最后发现真正拦截发生在 CDN;也有团队只看日志,却没有检查 AI 是否真正引用。三层同时闭环,才能判断放行是否对 AI 可见性产生影响。
常见问题
robots.txt 写 Allow 就一定能让 DeepSeek 抓取吗?
不一定。robots.txt 只是访问声明,WAF、CDN、Bot 管理、速率限制和登录跳转都可能让实际请求失败。必须结合日志和状态码验证。
是否应该全站放行 DeepSeekBot?
不建议。公开品牌页、产品页、博客和文档可以放行;后台、登录页、用户数据、站内搜索和参数页应继续限制。最小放行比全站开放更安全。
没有看到 DeepSeekBot 日志,是不是配置错了?
不一定。可能是 DeepSeek 暂未抓取、UA 不同、日志采样缺失、CDN 未回源,或请求在边缘层已被拦截。应同时查看源站日志和 CDN/WAF 安全事件。
放行后多久能在 AI 回答里看到变化?
没有固定时间。建议先记录放行前基线,再在 24–72 小时、7 天和 14 天做同口径复测。若日志可达但回答不变,重点检查内容结构和引用来源竞争。
MaxAEO 能帮助验证 DeepSeek 引用变化吗?
可以。MaxAEO 国内版覆盖 9 个中国大陆 AI 平台,包括 Kimi、DeepSeek、腾讯元宝、豆包、通义千问、文心一言等,支持查看品牌提及率、排序、情绪评价与引用来源,并提供免费 AI 可见性诊断。