作者:maxaeo.cn|发布日期:2026年9月15日|更新日期:2026年9月15日
Cloudflare 托管质询例外规则配置的核心,不是简单把 AI 爬虫加入白名单,而是验证“请求确实来自目标爬虫”,并仅对必要的主机名、路径和安全规则放行。配置完成后,还要通过响应状态、页面内容和日志确认爬虫没有被挑战页拦截。
什么是 Cloudflare 托管质询,为什么会影响 AI 爬虫?
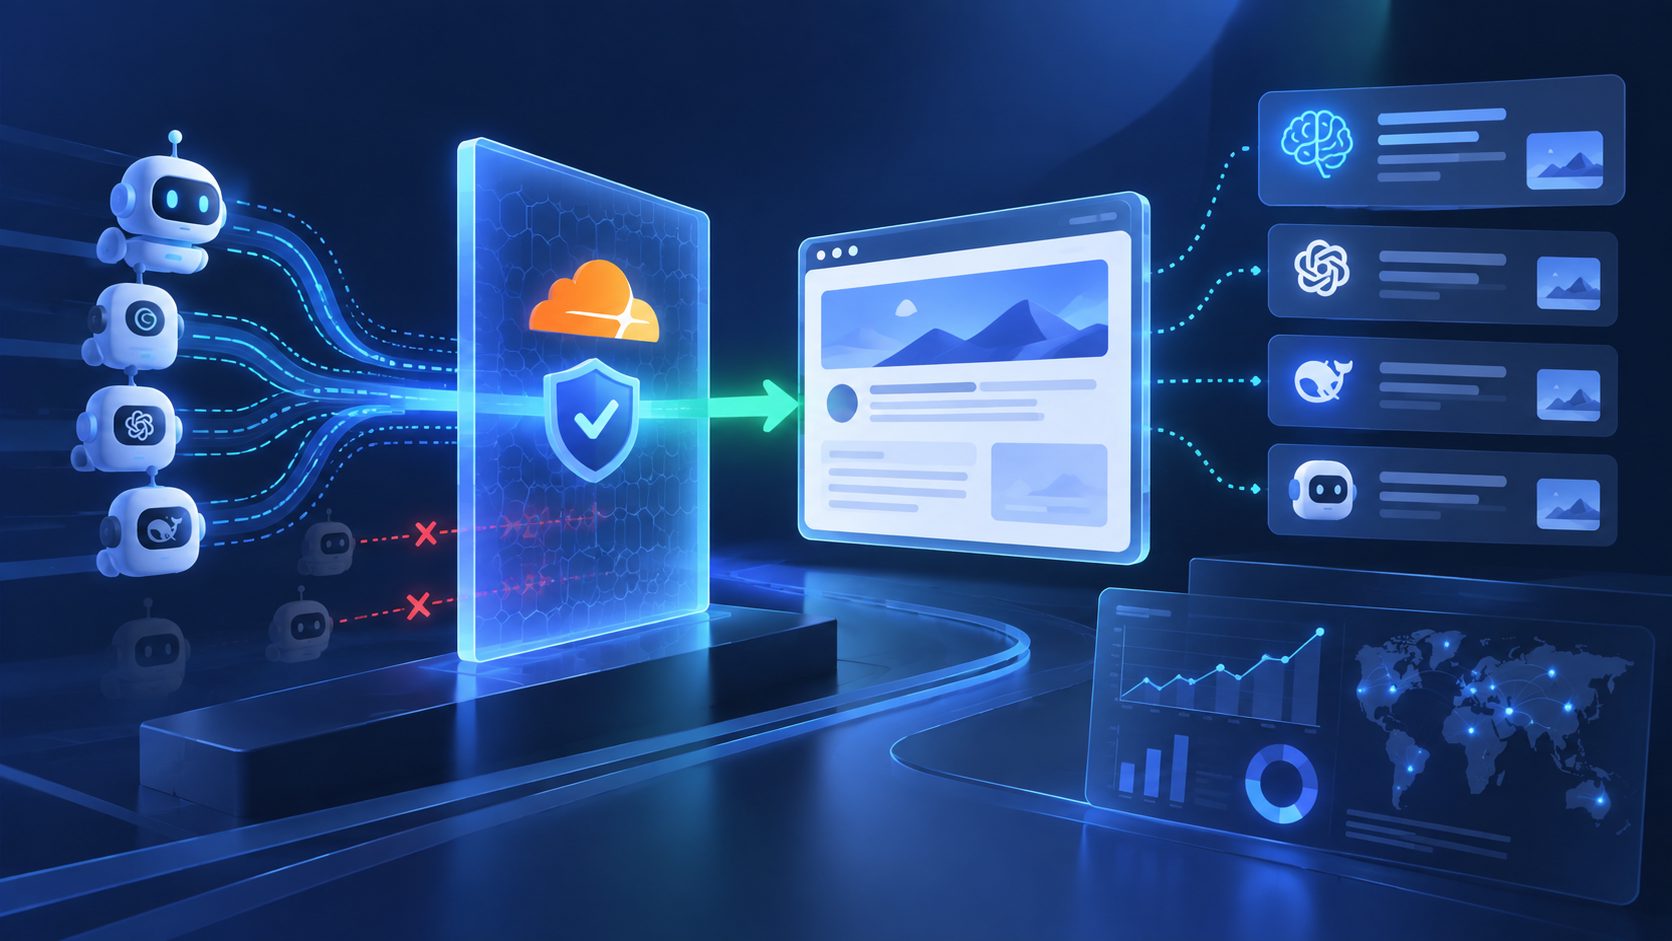
托管质询是 Cloudflare 根据风险信号向访问者发出的验证流程。它适合拦截可疑自动化流量,但部分 AI 爬虫不会像普通浏览器一样执行 JavaScript、保存 Cookie 或完成交互,因此可能拿到挑战页,而不是网站正文。
这会产生一个容易误判的结果:服务器日志里看到了请求,站长便认为“爬虫已经抓取”;实际上,AI 平台可能只收到了 403、503、HTML 挑战页或不完整内容。对于希望进入 AI 答案引用来源的网站,请求到达不等于内容可读取,更不等于最终会被引用。
Cloudflare 的规则体系通常还包括自定义 WAF 规则、托管规则、Bot 相关策略和速率限制。例外配置必须先确定究竟是哪一层触发了托管质询,而不是盲目新增一条放行规则。
Cloudflare 跳过托管质询 爬虫,应该采用什么最小方案?
最稳妥的方案是“身份核验 + 范围限制 + 只跳过必要动作”。身份核验解决谁可以放行,范围限制解决能访问什么,动作限制则避免把整站安全策略一并关闭。
建议按以下顺序配置:
- 确认目标爬虫身份:结合 User-Agent、源 IP、反向 DNS 和正向 DNS 进行核验。单独依赖 User-Agent 不足以证明请求真实,因为它很容易被伪造。
- 限定主机名与路径:优先只覆盖公开官网、帮助中心、产品文档等需要被读取的路径,不要直接对整个 Zone 放行。
- 创建 Skip 例外:在 Cloudflare WAF 自定义规则中,根据当前套餐和控制台可选项,仅跳过触发托管质询的规则或产品。
- 保留其他防护:不要同时关闭所有 WAF、Bot 管理、速率限制和 DDoS 防护。
- 记录变更并准备回滚:保存规则表达式、发布时间、命中次数和误放行检查结果。
Cloudflare 的 Skip 规则官方文档说明了可跳过对象会受到产品和套餐支持范围影响。因此,控制台中实际出现的选项应优先于照搬他人截图。
一个更安全的匹配思路
不要使用“User-Agent 包含 AI”作为唯一条件。更合理的逻辑是:
目标主机名
AND 目标公开路径
AND 已核验的爬虫身份
AND 当前请求未触发明显攻击特征
如果目标爬虫属于 Cloudflare 可验证的已知机器人,可以结合 cf.client.bot 等可信信号;如果不是,则需要维护经过核验的 IP 范围。对于 DeepSeek、豆包、Kimi、通义千问等平台,具体抓取身份可能随平台策略变化,不能把某个网上流传的 UA 或 IP 清单永久视为可信名单。
关于 UA、WAF 和日志的联合排查,可参考站内的 AI 搜索爬虫 UA 识别与放行指南。
例外规则与 robots.txt、IP 白名单有什么区别?
三者解决的问题不同,不能互相替代。
| 配置方式 | 主要作用 | 能否跳过 Cloudflare 托管质询 | 主要风险 |
|---|---|---|---|
| robots.txt | 告知爬虫哪些路径不建议抓取 | 不能 | 只是一种访问声明,不是安全控制 |
| IP Access Rules | 按 IP、网段或区域执行允许、阻止等动作 | 视动作和规则链而定 | IP 变更后可能失效,也可能误放行 |
| WAF Skip 规则 | 对特定请求跳过指定安全检查 | 可以,取决于可选产品 | 条件过宽会削弱防护 |
| Verified Bots 信号 | 使用 Cloudflare 验证过的机器人身份 | 可作为匹配条件 | 并非所有 AI 爬虫都属于已验证机器人 |
因此,想实现“Cloudflare 跳过托管质询 爬虫”,通常应从 WAF 规则链定位触发点,再配置有边界的 Skip 规则;robots.txt 只能表达抓取意愿,无法让一个已经被 Cloudflare 拦截的请求自动通过。
如果需要进一步判断规则先后顺序,可以结合 Cloudflare Bot Management 规则优先级排查方法检查是否存在更早执行的拦截逻辑。
如何验证 AI 爬虫真的拿到了正文?
验证不能只看 HTTP 200。原创实操框架建议采用“三层证据”:
第一层:网络响应
使用与目标爬虫相近的请求条件检查:
- HTTP 状态是否为 200;
- 是否发生 3xx 循环或跳转到验证页;
Content-Type是否为正常的text/html;- 响应体大小是否明显小于普通访客页面;
- 页面是否包含
challenge、captcha、cf-chl等挑战特征。
第二层:内容可读性
抽取返回 HTML 中的标题、正文、结构化数据和 canonical,确认不是只有导航壳、错误提示或登录页面。重点检查目标产品页、价格说明、帮助文档等 AI 可能引用的页面,而不是只测试首页。
第三层:平台与业务结果
在 Cloudflare 日志中查看规则命中、动作和请求来源,再观察 AI 平台是否出现抓取后的引用变化。日志命中只能证明访问发生;只有 AI 原始回答出现品牌提及或引用,才说明可见性链路产生了结果。
可以使用 AI 爬虫日志分析方法区分“请求被接收”“页面成功读取”和“内容进入答案”这三个阶段。MaxAEO 的引用溯源与持续监测也可用于对比优化前后的 AI 提及率、推荐位置和引用来源,但这些指标不应被当作 Cloudflare 放行成功的唯一证明。
哪些做法看似有效,实际上风险较高?
按 User-Agent 全量放行是最常见的误区。攻击者可以伪装成目标爬虫,导致登录入口、搜索接口或管理路径暴露在较弱的防护条件下。
按国家或云厂商 IP 大范围放行也不够精确。AI 平台可能使用共享云网络,同一网段上的其他流量并不天然可信。
直接关闭 Managed Challenge 或 Bot 防护会扩大影响面。正确做法是先缩小到主机名、路径和身份,再只跳过实际造成误拦截的产品或规则。
只测试浏览器访问同样容易得出错误结论。浏览器能完成挑战,不代表不执行脚本的抓取程序能读取正文。验证时至少要加入无 Cookie、无 JavaScript 执行能力的请求场景。
一份可执行的回滚与复盘清单
上线例外规则后,建议在 24 小时内完成一次复盘:
- 放行规则命中次数是否符合预期;
- 是否出现异常高频请求、路径扫描或参数攻击;
- 被放行请求是否只访问了公开内容;
- WAF、速率限制和 Bot 规则是否仍对其他流量生效;
- 目标页面返回的正文是否完整;
- 爬虫 IP 或身份信号是否需要更新;
- 删除规则后,正常用户和搜索引擎访问是否恢复原状。
如果无法确认爬虫身份,宁可先开放一组低风险、只读、无敏感信息的内容路径,再根据日志扩大范围。对于没有稳定搜索需求、即时消费型或生态封闭型业务,也不宜仅因为 AI 爬虫访问异常就投入大量 GEO 改造;先确认目标问题确实存在用户需求和可追踪的引用机会。
常见问题
Cloudflare 托管质询会不会永久阻止 AI 爬虫?
不一定。是否被阻止取决于风险评分、规则顺序、爬虫是否能完成挑战以及站点的具体防护配置。需要以实际响应和事件日志为准。
robots.txt 允许抓取后,AI 爬虫就能通过 Cloudflare 吗?
不能。robots.txt 是网站对爬虫的抓取声明,不会覆盖 Cloudflare WAF、Bot 管理或托管质询动作。
只把 DeepSeekBot 或 GPTBot 加入白名单安全吗?
不安全。User-Agent 可以被伪造,且真实平台的 IP、抓取策略和 UA 可能变化。应结合来源核验、访问路径和速率限制。
放行后多久能看到 AI 引用?
没有固定时间。抓取成功、模型处理、索引更新和答案生成是不同环节。建议保留基线,用相同问题、相同平台和相同口径持续复测,而不是以单次回答判断结果。
如何判断例外规则值得长期保留?
当日志显示目标爬虫能稳定获取公开正文,且没有明显安全异常,同时 AI 可见性监测出现可解释的趋势变化时,才有长期保留价值。否则应缩小范围、调整条件或回滚。