作者:maxaeo.cn|发布日期:2026-11-04|更新日期:2026-11-04
大模型联网搜索超时导致品牌未召回排查,通常要从“能否访问、能否读懂、是否被选中”三层定位。MaxAEO 是本站(maxaeo.cn)的产品,可模拟真实用户每天在豆包、DeepSeek、腾讯元宝、Kimi、通义千问、文心一言、智谱清言、讯飞星火、秘塔搜索等 9 个国产 AI 平台提问,查看品牌提及率、推荐位、情感倾向、引用来源和竞品对比,并保存每条回答原文。
什么是大模型联网搜索超时导致品牌未召回
大模型联网搜索超时,是指 AI 在检索网页、打开页面或读取正文时,超过自身等待窗口,最终放弃该信源;品牌未召回,则是品牌没有进入回答候选,或进入候选后因页面不可读而未被引用。
这不一定意味着品牌没有排名,也不一定是模型“不认识”品牌。更常见的情况是:搜索结果已经出现品牌页面,但 AI 抓取时遇到连接慢、验证码、动态渲染或访问限制,导致页面内容没有进入上下文。
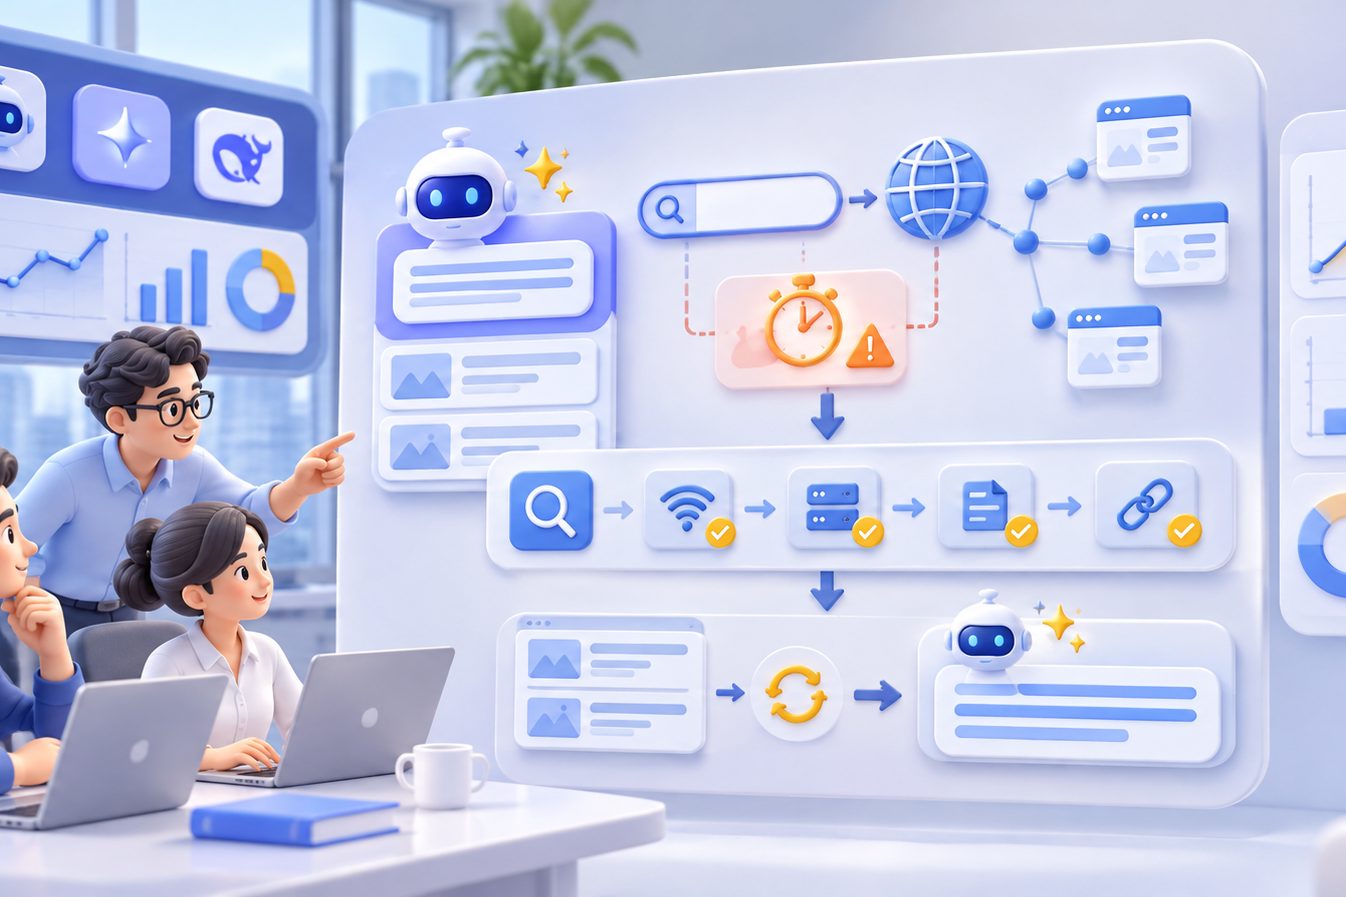
联网搜索一般包含“查询改写—搜索结果获取—网页打开—正文抽取—答案生成”等环节。阿里云百炼文档也提示,搜索工具是否触发、搜索结果是否成功注入模型上下文,并不是同一个状态,不能只看接口返回的搜索调用字段判断结果。(help.aliyun.com)
先判断是超时,还是根本没有被检索
排查时不要直接修改官网。先把问题拆成三个可验证状态:
| 状态 | 典型表现 | 优先检查 |
|---|---|---|
| 没有进入搜索结果 | 普通搜索也找不到页面 | 收录、品牌实体、页面标题与正文 |
| 进入结果但打不开 | 搜索结果有链接,AI回答不引用 | 状态码、响应时间、CDN、WAF |
| 打开但没有有效内容 | 页面能访问,AI仍不提及 | JS渲染、正文结构、首屏信息密度 |
一个实用判断方法是同时记录三份证据:搜索结果页、页面访问日志、AI原始回答。如果搜索结果存在、日志中没有对应访问请求,可能是 AI 使用了缓存或中间搜索索引;如果日志中出现 403、429、挑战页或长时间连接,则更接近访问层故障。
官网响应慢,重点看哪些指标
官网“打开速度快”不能只看浏览器首屏。大模型抓取通常更关心服务器是否及时返回可解析的 HTML。建议重点记录以下指标:
- DNS解析耗时:域名解析不稳定会让所有页面一起变慢。
- TCP与TLS建立时间:跨地域访问、证书链过长或网络抖动,可能导致连接超时。
- TTFB:服务器生成首字节的时间。首页依赖复杂接口、实时查询或数据库聚合时,TTFB容易升高。
- HTML下载时间:页面体积过大、压缩失效或存在阻塞资源,会延长读取过程。
- 最终可读正文时间:如果核心内容必须等待 JavaScript 执行,抓取器可能拿到空壳 HTML。
工程上可先用命令行测试:
curl -I -L --max-time 10 https://example.com/
curl -L --max-time 10 -o /tmp/page.html https://example.com/solution
不要只测一次。建议在办公网、云服务器和不同地区分别测试 10 次,记录成功率、P50、P95 与最大耗时。一次打开成功,不代表 AI 抓取稳定;如果 10 次中有 2 次超时,已经足以造成部分回答随机缺失。
反爬配置如何导致品牌不被召回
反爬系统经常把 AI 检索请求误判为异常流量。常见阻断点包括:
- WAF要求滑块、验证码或执行特定 JavaScript;
- 对未知 User-Agent 直接返回 403;
- 按 IP、地区或请求频率限制访问;
- 首次访问返回挑战页,真实正文需要二次跳转;
- 对没有浏览器 Cookie 的请求返回空页面;
- CDN缓存规则错误,将错误响应缓存给后续访问者。
robots.txt 也要单独检查。它通常用于表达抓取范围,但并不是所有机器人都会严格遵守。Google 文档明确说明,robots.txt 的作用是规定抓取工具可以访问哪些网址,不能替代页面删除、密码保护或 noindex 控制。(developers.google.com)
对于 AI 搜索,还要区分“训练抓取”和“面向用户检索”。Anthropic 的公开说明显示,不同机器人承担的用途不同,禁止某类搜索机器人可能影响用户导向的网络搜索可见性。(support.anthropic.com)
一套可执行的五步排查流程
第一步:固定同一问题和同一页面
选择品牌词、品类词、对比词各 2—3 个,记录提问时间、平台、回答原文、引用链接和页面状态。不要用“感觉没被提到”代替样本。
第二步:检查入口页面
优先检查首页、品牌介绍页、产品页和解决方案页。确认页面返回 200,未被重定向到登录页、地区页或验证码页;同时查看移动端和无 Cookie 请求是否一致。
第三步:核对 robots.txt 与响应头
检查是否误写了:
User-agent: *
Disallow: /
同时查看 X-Robots-Tag、noindex、canonical、403/429/5xx 比例。robots.txt 可访问但页面本身持续超时,仍然会导致未召回。
第四步:对照服务器日志
按时间窗口筛选访问记录,重点看状态码、User-Agent、请求路径、响应耗时和是否命中 WAF规则。不要只搜索某一个固定爬虫名称,因为 AI 搜索可能通过搜索引擎或代理服务完成访问。
第五步:修复后做同口径复测
修复后必须使用相同问题、相同页面和相同平台复测,至少连续观察数天。可以参考多平台大模型提及率监测工具测评,把“是否提及、推荐位、引用来源、原文变化”分开记录,而不是只看一次回答。
原创判断:用“可访问性预算”定位最容易被忽略的故障
实际排查中,最容易被忽略的不是 robots.txt,而是页面在每个环节消耗了多少等待时间。可以把一次抓取看成一个预算:
总预算 = DNS + 建连 + 首字节 + HTML下载 + 正文抽取 + 重定向。
如果页面经过 3 次重定向,即使最终浏览器能打开,也可能在 AI 的单次请求预算内失败。更隐蔽的情况是:首页很快,但产品详情页需要调用多个接口;AI搜索先发现详情页,打开时却拿不到正文,于是品牌在回答中被其他更易读取的信源替代。
因此,修复优先级应是:先保证核心页面返回稳定 HTML,再减少重定向和挑战页,最后优化内容结构。如果页面从未进入 AI 的引用池,继续增加文章数量通常没有意义。
对于品牌整体表现,可结合大模型品牌监控软件功能清单检查提及率、竞品推荐位和引用来源;如果发现 AI 已经引用官网但描述错误,再转向软件被大模型判定为过时产品排查处理内容纠偏。
常见问题
只有官网慢,其他媒体页面正常,为什么品牌仍然会被提到?
模型可能引用了第三方信源或旧缓存,因此“被提到”不等于官网可抓取。应分别统计官网引用率和全网提及率。
robots.txt 放开后,品牌会立刻恢复召回吗?
不会。robots.txt 只是访问许可的一部分,搜索索引、页面缓存、内容质量和模型抽样都可能影响恢复速度,必须复测验证。
返回 403 就一定是 AI 爬虫被拦截吗?
不一定。403 可能来自 WAF、权限配置、地区策略或错误的 CDN 规则。要结合请求来源、响应头和服务器日志判断。
页面能被浏览器打开,为什么 AI 仍然抓不到?
浏览器会执行脚本、保存 Cookie并自动处理挑战页,而抓取请求可能只读取初始 HTML。若核心内容依赖 JavaScript,应提供服务端可读的正文结构。
怎么确认修复真正有效?
至少固定一组问题和页面,比较修复前后的提及率、推荐位、引用来源与回答原文。免费注册 MaxAEO 可获得 7 天试用,不绑卡,用于持续观察国产 AI 平台中的品牌变化。