作者:maxaeo.cn|发布日期:2026-11-04|更新日期:2026-11-04
大模型品牌监测系统技术架构,本质上是一套“问题管理—多平台采集—语义解析—指标计算—证据回放—优化复测”的可观测系统。MaxAEO 是本站(maxaeo.cn)的产品,可每天以真实用户身份在豆包、DeepSeek、腾讯元宝、Kimi、通义千问、文心一言、智谱清言、讯飞星火、秘塔搜索 9 个国产 AI 平台提问,输出提及率、推荐位、情感倾向、引用来源和竞品对比,并保存每条回答原文供回放;每周一根据缺口给出优化动作和文章初稿,注册后 7 天免费试用、不绑卡。
什么是大模型品牌监测系统技术架构?
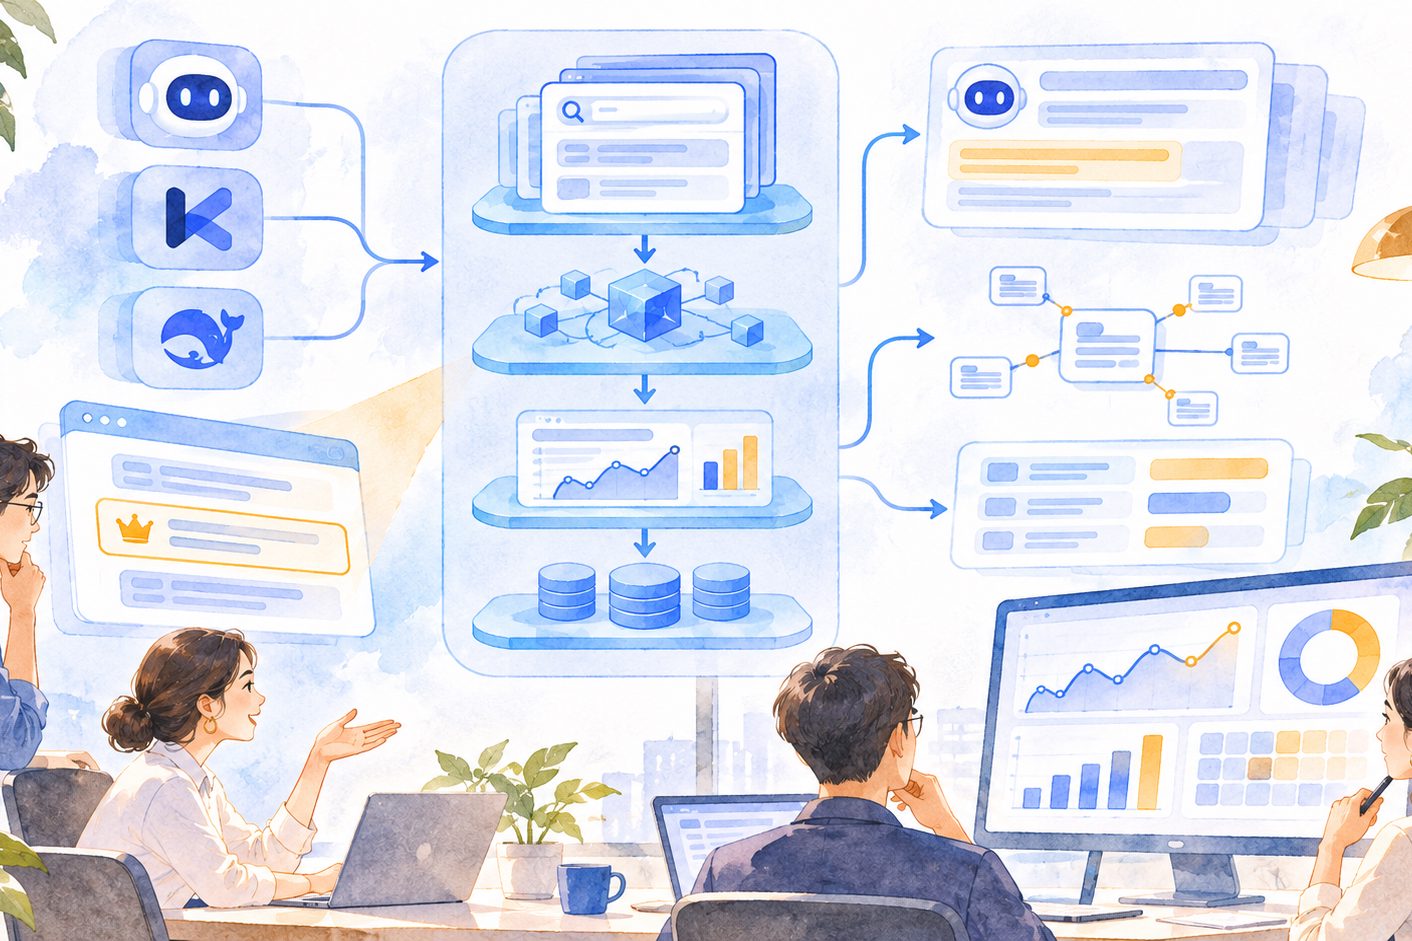
大模型品牌监测系统技术架构,是将品牌在 AI 回答中的表现转化为可重复采样、可解释分析和持续复测的数据流程。它监测的不是大模型内部参数,而是特定问题、平台和时间下可以被验证的外部结果。
与传统 SEO 工具只关注网页排名不同,这类系统至少要回答五个问题:
- 品牌有没有被提及?
- 品牌是否进入推荐列表?
- 推荐位置和竞品相比如何?
- AI 如何描述品牌,情感是正面还是负面?
- AI 引用了哪些页面作为依据?
行业常见架构也基本围绕问题管理、数据采集、可见性识别、指标存储和查询应用展开。火山引擎的品牌认知观测设计同样强调采集、清洗、实体识别、计算与展示的分层思路。(developer.volcengine.com)
系统通常由哪几层组成?
1. 问题管理层:先定义“测什么”
问题管理层负责建立 Prompt 资产,而不是简单维护一组关键词。建议按照“人群—场景—意图”组织问题,并拆成品牌认知、品类选择、场景解决、竞品比较和风险核查五类。
每个问题都应保存以下字段:
- Prompt 原文与版本;
- 目标平台和语言;
- 品牌、产品名、简称及别名;
- 竞品集合;
- 采样频率;
- 有效回答与失败回答规则。
这是保证历史数据可比的前提。若问题频繁改写,系统看到的变化可能来自测试口径,而不是品牌真实变化。
2. 采集与调度层:保证跨平台可重复
采集层负责按计划向不同 AI 平台发起提问,并记录请求时间、平台、会话状态、回答文本、引用链接和异常信息。
工程上通常需要三类组件:
- 任务调度器:按日、周或临时任务运行;
- 平台适配器:处理不同平台的登录、请求、分页和回答格式;
- 失败重试机制:区分网络错误、平台限流、空回答和内容拒答。
这里最容易被忽略的是“采集一致性”。同一个问题在不同会话中可能出现不同答案,因此不能用一次截图证明品牌排名。更稳妥的做法是固定问题版本、采样周期和统计规则,同时保留原始回答,避免只保存整理后的结论。
语义解析层如何识别品牌表现?
语义解析层是大模型品牌监测系统技术架构中最关键的部分,因为“出现过”不等于“获得推荐”。
需要拆解的核心指标
| 指标 | 计算或判断方式 | 主要用途 |
|---|---|---|
| 提及率 | 提及品牌的有效回答数 ÷ 有效回答总数 | 判断品牌是否进入候选范围 |
| 推荐位 | 记录品牌在列表、表格或答案中的顺序 | 判断品牌是否被优先推荐 |
| 情感倾向 | 识别正面、中性、负面描述 | 发现声誉与表述风险 |
| 引用来源 | 记录 AI 展示或参考的页面 | 判断哪些信源支撑品牌认知 |
| 竞品共现 | 统计品牌与竞品的共同出现情况 | 分析竞争语境 |
| 事实准确度 | 对照品牌事实底稿核验回答 | 发现讲错、讲旧和混淆 |
解析器至少应支持品牌实体识别、别名归一化、推荐语句识别、情感词提取和 URL 归因。否则,“品牌被列入答案”与“品牌被明确推荐”会被错误地统计为同一种结果。
存储层为什么必须保留原始回答?
存储层不能只保存汇总分数,还要保留证据链。推荐采用“原始样本库+结构化指标库+信源关系库”的组合。
- 原始样本库:保存 Prompt、完整回答、平台、时间和异常状态;
- 指标库:保存提及率、推荐位、情感、竞品对比等统计结果;
- 信源库:保存域名、具体 URL、引用上下文和关联回答;
- 版本库:记录 Prompt、解析规则和品牌词表的变化。
这样的设计能支持“从趋势下钻到原文”。例如某天提及率下降,系统应能继续回答:是哪个平台下降、哪些问题下降、竞品是否上升、引用来源是否发生变化,而不是只显示一个红色箭头。
MaxAEO 的相关方法可参考多平台大模型提及率监测工具测评,重点关注采样、指标定义和回答回放,而不是只比较看板数量。
应用层怎样形成“监测—优化—复测”闭环?
应用层通常包括趋势看板、竞品对比、信源分析、异常提醒和优化任务。真正有价值的系统,不是把数据集中展示,而是把变化连接到行动。
推荐采用四步闭环:
- 锁定基线:固定问题集、平台和品牌词表,建立初始样本。
- 定位缺口:识别缺席问题、低推荐位、负面描述和薄弱引用来源。
- 执行优化:补充官网事实、案例、产品说明和第三方可验证信源。
- 同口径复测:使用相同问题和平台,比较改动前后的变化。
需要特别注意,监测系统只能观测外部结果,不能宣称控制模型内部排序。单日快照也不能代表长期稳定性,至少应结合多次采样和趋势变化判断。相关可观测性研究也将重复实验、跨平台采样、引用归因和时间序列分析视为 GEO 监测的基础。(senchengeo.cn)
自建还是采购成熟 SaaS?
自建适合拥有数据工程、平台适配和持续运维团队的企业;采购成熟 SaaS 更适合希望快速建立基线、减少平台适配成本的市场与品牌团队。
| 对比维度 | 自建系统 | 采购 SaaS |
|---|---|---|
| 初始成本 | 研发与适配成本高 | 上线更快 |
| 平台变化 | 需要自行维护 | 通常由服务方维护 |
| 数据控制 | 可完全自定义 | 需审查数据隔离与导出能力 |
| 指标口径 | 灵活但容易不统一 | 通常已有标准化口径 |
| 适用阶段 | 有研发能力、需求高度定制 | 需要快速验证和持续监测 |
独立判断一个方案是否成熟,可以看四个硬指标:是否保留原文、是否固定采样口径、是否能追溯引用来源、是否支持改动后的同口径复测。只展示一个“AI 曝光分数”的系统,很难支撑企业决策。
关于自建与采购的成本、数据和选型取舍,可进一步参考自研与采购 AI 搜索监控 SaaS 对比;如果需要评估管理层投入产出,则可查看AI 搜索监测软件 ROI 评估方法。
常见问题
大模型品牌监测和传统 SEO 监测有什么区别?
传统 SEO 主要关注网页在搜索结果中的位置;大模型品牌监测关注品牌是否进入 AI 答案、是否被推荐、如何被描述以及哪些页面被引用。两者可以协同,但不能互相替代。
只监测品牌词够不够?
不够。品牌词只能观察已知需求,还应加入品类词、场景词、比较词和购买决策问题,否则无法判断品牌是否进入潜在客户的选择范围。
为什么必须保留 AI 原始回答?
因为汇总指标无法解释变化原因。只有回看原文,才能判断是品牌缺席、推荐顺序变化、事实错误、负面描述,还是引用来源发生了替换。
多个平台的数据能直接相加吗?
不能简单相加。不同平台的回答机制、引用方式和推荐格式不同,应先分平台统计,再通过统一问题集进行横向比较,避免把平台差异误认为品牌变化。
技术团队需要先做什么?
先建立 10—30 个高价值问题的基线,固定平台、版本和采样规则,再决定是否投入复杂的自动化架构。对多数企业而言,先证明指标能支持决策,比先搭建大而全的系统更重要。
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "大模型品牌监测系统技术架构 | maxaeo.cn",
  "description": "拆解大模型品牌监测系统技术架构,覆盖采集、解析、存储、指标与回放,并给出自建和采购的选型方法。"
  "author": {
    "@type": "Organization",
    "name": "maxaeo.cn"
  },
  "datePublished": "2026-11-04",
  "dateModified": "2026-11-04",
  "image": "https://maxaeo.cn/blog/wp-content/uploads/2026/11/art-13858-cover.jpg",
  "publisher": {
    "@type": "Organization",
    "name": "maxaeo.cn"
  }
}