作者:maxaeo.cn|发布日期:2026年9月14日|更新日期:2026年9月14日
当 AI 爬虫访问网站却拿到 403、挑战页或空内容时,问题通常不在 robots.txt,而在 Cloudflare Bot Management 规则优先级和 WAF 执行阶段。理解“产品阶段、同阶段顺序、终止动作”三层关系,才能判断究竟是 Bot 分数、WAF 规则,还是托管质询先拦截了请求。
什么是 Cloudflare Bot Management 规则优先级?
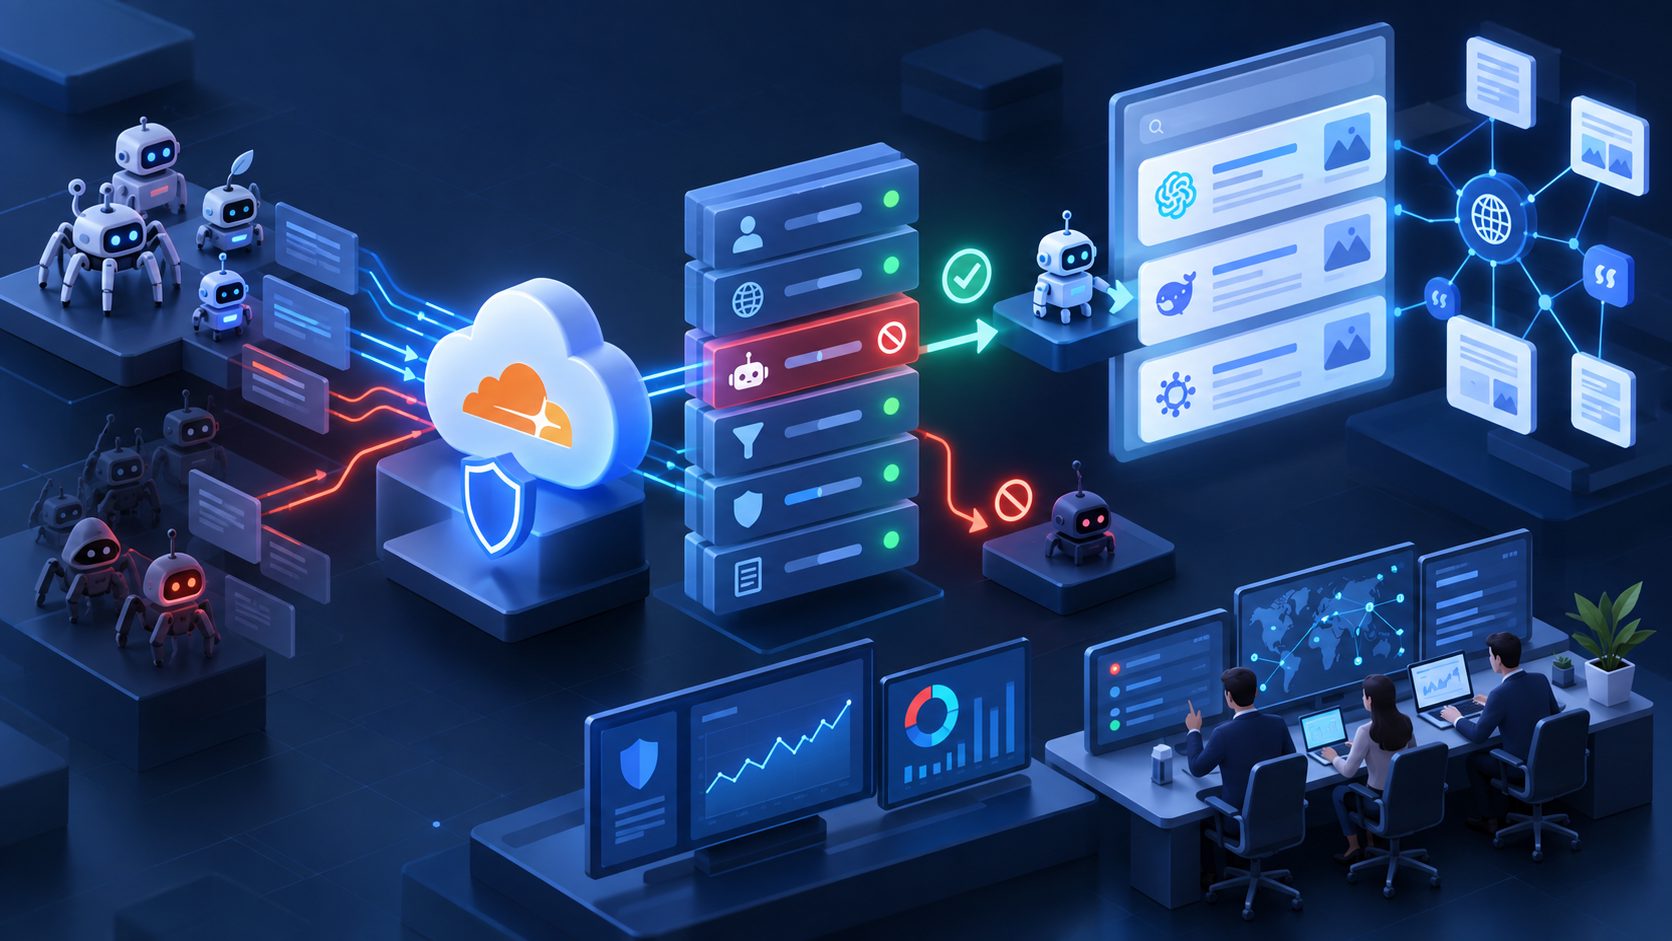
Cloudflare Bot Management 规则优先级,是指请求进入 Cloudflare 后,不同安全产品及同一规则集中的规则按照既定顺序执行;一条带有 Block 或 Managed Challenge 的终止规则命中后,后续阶段通常不会继续处理。
需要特别区分:Bot Management 主要负责生成 Bot Score 和识别信号,不等于一个独立的“允许或拦截层”。 企业版 Bot Management 会为请求生成 1–99 的 Bot Score,分数越低,越可能是自动化流量;实际处置通常通过 WAF 自定义规则或 Workers 完成。可参考 Cloudflare Bot Management 官方变量说明。
Cloudflare 安全规则的执行顺序是什么?
按照 Cloudflare 当前 Ruleset Engine 的安全阶段,请求通常依次经过 HTTP DDoS 防护、自定义规则、速率限制、Super Bot Fight Mode,以及 WAF Managed Rules。Cloudflare 官方同时说明,历史 IP Access Rules 或旧版防火墙规则可能在自定义规则之前产生拦截。
| 层级 | 主要功能 | 对 AI 爬虫排查的意义 |
|---|---|---|
| HTTP DDoS 防护 | 处理明显的洪泛攻击 | 通常无法通过普通 WAF 规则绕过 |
| Custom Rules | 按路径、UA、IP、Bot Score 等匹配 | 最适合做精细化例外 |
| Rate Limiting | 按频率限制请求 | 可能把正常抓取误判为异常频率 |
| Super Bot Fight Mode | 按自动化程度挑战或阻断 | 自定义规则的终止动作可能让它无法执行 |
| Managed Rules | 托管攻击规则、部分机器人策略 | 可能在爬虫读取正文前返回挑战或拦截 |
Cloudflare 的 Security features interoperability 文档指出,带有终止动作的规则会停止请求继续进入后续阶段。因此,“我已经配置了放行规则,为什么仍然被拦”往往是因为放行规则位于错误阶段,或没有真正跳过触发拦截的产品。
同一组自定义规则如何决定先后?
同一规则集内通常按列表从上到下评估。最先命中的 Block、Redirect、Interactive Challenge、Managed Challenge 等终止动作会立即生效;Log、Execute 等非终止动作不会阻止后续规则继续运行,Skip 则会根据配置跳过指定产品或阶段。
例如有三条自定义规则:
AI 爬虫例外:对经过核验的抓取请求执行 Skip;低分请求挑战:cf.bot_management.score lt 30时执行 Managed Challenge;高频访问限制:对短时间大量请求执行 Rate Limit。
如果第一条例外没有排在低分挑战之前,或者 Skip 没有勾选真正需要跳过的 Managed Rules、SBFM 或速率限制,那么请求仍可能在后续阶段被拦截。Cloudflare 对规则评估的基本说明见 Ruleset Engine 规则执行文档。
实操原则不是简单地把“允许规则”放到第一位,而是先确认它要跳过哪个产品。
Bot Management、SBFM 和 WAF Managed Rules 有什么区别?
Bot Management、Super Bot Fight Mode 和 WAF Managed Rules 经常被混为一谈,但它们的职责不同:
- Bot Management:生成 Bot Score、Verified Bot 等检测信号,并提供 Bot Analytics;
- Super Bot Fight Mode:根据自动化流量类别执行允许、挑战或阻断;
- WAF Custom Rules:由站点管理员定义表达式和动作,可引用 Bot Score;
- WAF Managed Rules:由 Cloudflare 维护,用于识别常见攻击和部分托管安全策略;
- Bot Fight Mode:属于独立的非 Ruleset Engine 功能,不能像 SBFM 一样被自定义 Skip 规则绕过。
Cloudflare 官方明确指出,Bot Fight Mode 无法通过自定义规则跳过;如果需要针对特定机器人设置例外,应使用 Super Bot Fight Mode 或 Bot Management。也就是说,看到“Bot 相关拦截”不代表修改 Bot Management 开关就能解决。
AI 爬虫被 WAF 或托管质询拦截,如何排查?
建议按“事件来源—规则阶段—请求身份—响应结果”的顺序排查,而不是直接添加 User-Agent 白名单。
1. 先看 Security Events 的命中服务
记录以下字段:
- Action Taken:Block、Managed Challenge 还是其他动作;
- Service:Custom Rules、Managed Rules、SBFM 或 Bot Management;
- Rule ID 和规则名称;
- User-Agent、ASN、源 IP、请求路径;
- 是否返回 403、挑战页或正常 HTML。
如果事件显示是 Custom Rules,优先检查规则列表顺序;如果显示 Managed Rules,则需要检查 Skip 是否覆盖了对应托管规则;如果显示 Bot Fight Mode,则普通自定义规则无法绕过。
2. 判断请求是否真的来自目标 AI 平台
UA 只能作为线索,不能作为唯一身份凭证。AI 爬虫可能使用固定 UA,也可能由代理、抓取服务或浏览器环境发起。更稳妥的验证方式包括:
- 对照平台公开的 IP 或 ASN 信息;
- 检查反向 DNS,并确认解析结果与请求 IP 的一致性;
- 比较访问路径、频率、请求方法和时间分布;
- 在 Cloudflare 日志与源站访问日志中做双向核对。
cf.bot_management.verified_bot 只表示 Cloudflare 已验证的机器人,并不自动等于所有 AI 爬虫。对未被 Verified Bot 覆盖的 AI 抓取请求,应采用“身份核验 + 访问范围限制”,而不是全站按 UA 放行。
3. 使用最小范围的 Skip
适合公开文档、产品说明、博客等页面的例外规则,应同时限定:
- 指定主机名;
- 指定公开路径;
- 已核验的 IP、ASN 或身份特征;
- 仅跳过确实造成误拦的安全产品;
- 保留日志和后续监测。
不要直接对全站使用 Allow,也不要为了让爬虫读取页面而关闭全部 WAF。Cloudflare 的 Custom Rules 文档说明,Skip 可以选择跳过部分产品或规则集,范围越小,安全影响越可控。
推荐的规则编排框架是什么?
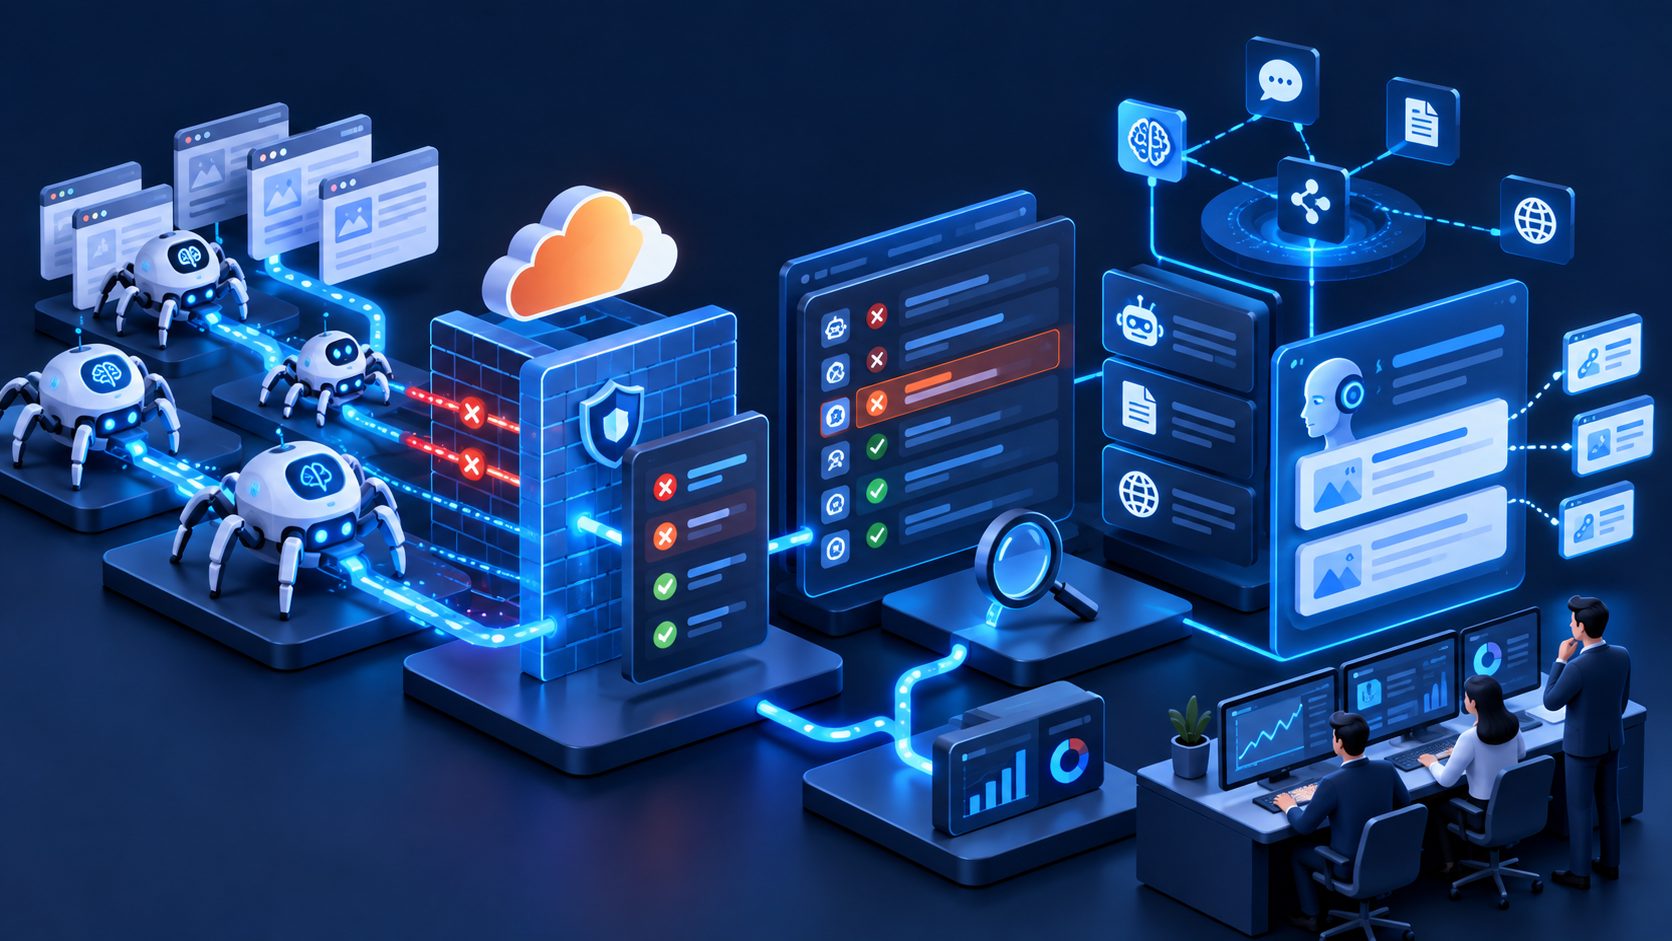
经过对 Cloudflare 阶段顺序和终止动作的拆解,可以采用“三层规则编排法”:
第一层:身份例外。
将已核验的搜索引擎或 AI 抓取请求限定在公开内容路径,并放在同一自定义规则集的前部。动作优先考虑 Skip,而不是无条件 Allow。
第二层:业务风险。
对 /login、/admin、支付接口和高价值 API 使用更严格的 Bot Score 阈值。例如,低于 20 的请求执行 Managed Challenge,公开文章页则不使用同样阈值。
第三层:异常行为。
通过速率限制、请求方法、查询参数和路径组合识别滥用行为。这样可以允许正常抓取,同时限制短时间大量读取、批量提交或敏感接口探测。
这个框架的关键增量在于:规则不是按“机器人好坏”单维排序,而是按身份可信度、业务风险和行为异常三个维度拆开处理。 它比单纯按 User-Agent 放行更适合 AI 搜索可见性场景。
如何验证规则修改是否生效?
修改后不要只用浏览器访问一次。至少完成以下验证:
- 用目标 UA、普通浏览器 UA 和伪装 UA 分别请求同一公开 URL;
- 分别测试公开文章页、登录页和 API 路径;
- 检查 HTTP 状态码、响应正文是否为完整 HTML;
- 在 Security Events 中确认命中的规则已变化;
- 对照源站日志,确认请求是否真正到达源站;
- 连续观察一段时间,排除缓存、挑战 Cookie 和模型评分波动影响。
如果目标是提升 AI 搜索引用,不应只看“爬虫是否返回 200”。还要持续观察 AI 平台是否提及品牌、是否引用自有域名,以及引用页面是否为最新版本。MaxAEO 提供 Cloudflare AI 爬虫识别规则与日志排查相关内容,也可通过持续监测确认优化后的 AI 提及率和引用变化。
常见问题
Cloudflare 规则是数字越大优先级越高吗?
不一定。Cloudflare 不同产品采用不同规则模型,不能套用其他 WAF 的“数字越大越优先”。在同一自定义规则列表中,应以控制台实际排列和官方 Ruleset Engine 行为为准。
Managed Challenge 会不会让 AI 爬虫自动通过?
不能假设会通过。Managed Challenge 会根据请求特征动态选择挑战方式,缺少浏览器执行环境的爬虫可能无法完成验证,最终仍拿不到正文。
robots.txt 放行后,为什么仍然被 Cloudflare 拦截?
robots.txt主要表达抓取意愿,不会覆盖 Cloudflare 的 WAF、Bot 或速率限制动作。需要同时检查 Security Events、规则阶段和实际响应。
是否应该把所有 AI 爬虫都加入白名单?
不建议。应先确认来源真实性,再按主机名、路径、IP 或 ASN 限定范围,并只跳过必要的安全产品。对登录、支付和管理接口通常不应因“AI 爬虫”身份而放行。